テンソルコアの理解

Nvidiaの最新世代のGPUマイクロアーキテクチャのリリースにおける主要な技術の一つがテンソルコアです。この専門的な処理サブユニットは、Voltaでの導入以来、各世代ごとに進化し、オートマチックミックスドプレシジョントレーニングの助けを借りてGPUの性能を向上させます。
このブログ記事では、NVIDIAのボルタ、チューニング、アンペアシリーズのGPUにおけるテンソルコアの機能を要約します。読者は、この記事を終えることで、NVIDIAのGPUコアの異なる種類が何をするのか、テンソルコアが深層学習のための混合精度トレーニングを実現するために実際にどのように機能するのか、各マイクロアーキテクチャのテンソルコアの性能をどのように区別するか、そしてテンソルコア搭載のGPUを特定するための知識を得ることが期待されます。
前提条件
この記事を理解するためには、GPUハードウェアについての基本的な理解が必要です。GPU技術に関する追加のガイダンスを得るために、NVIDIAのウェブサイトを参照することをお勧めします。
CUDAコアとは何ですか?

テンソルコアのアーキテクチャと機能について議論する際には、まずCUDAコアの話題を取り上げる必要があります。CUDA(Compute Unified Device Architecture)は、NVIDIAの独自の並列処理プラットフォームおよびGPU用のAPIであり、CUDAコアはNVIDIAのグラフィックカードにおける標準の浮動小数点ユニットです。これらは、過去10年間にリリースされたすべてのNVIDIA GPUにおいて、NVIDIA GPUマイクロアーキテクチャの特徴として存在しています。
各CUDAコアは計算を実行でき、各CUDAコアはクロックサイクルごとに1つの操作を実行できます。CPUコアよりは能力が劣りますが、ディープラーニングで一緒に使用すると、多くのCUDAコアが並列にプロセスを実行することで計算を加速できます。
テンソルコアのリリース以前は、CUDAコアがディープラーニングを加速するための決定的なハードウェアでした。CUDAコアに限定されたGPUは、クロックサイクルごとに単一の計算しか行えないため、CUDAコアの性能が限られ、利用可能なCUDAコアの数と各コアのクロックスピードによっても制約されます。この制限を克服するために、NVIDIAはテンソルコアを開発しました。
テンソルコアとは何ですか?
Nvidiaのテンソルコアに関する詳細 - マイケル・ヒューストン、Nvidia
テンソルコアは、混合精度トレーニングを可能にする特化型コアです。これらの特化型コアの第1世代は、融合乗算加算計算を通じてそれを実現します。これにより、2つの4 x 4 FP16行列が4 x 4 FP16またはFP32行列に対して掛け算され、加算されることが可能になります。
混合精度計算と呼ばれるのは、入力される行列が低精度のFP16であっても、最終的な出力がFP32となり、出力にわずかな精度の損失しかないからです。実際、これにより計算が迅速に加速され、モデルの最終的な効果に対する悪影響は最小限に抑えられます。その後のマイクロアーキテクチャは、この能力をさらに低い精度のコンピュータ数値形式にまで拡張しました!

最初の世代のテンソルコアは、Voltaマイクロアーキテクチャとともに導入され、V100から始まりました。(ソース)その後の各世代では、新しいGPUマイクロアーキテクチャでの計算のために、より多くのコンピュータ数精度フォーマットが有効化されました。次のセクションでは、各マイクロアーキテクチャの世代がテンソルコアの能力と機能をどのように変更し、向上させたかについて説明します。
テンソルコアはどのように機能しますか?

GPUマイクロアーキテクチャの各世代は、Tensor Core操作のパフォーマンスを向上させるための新しい方法論を導入しています。これらの変更により、Tensor Coreが異なるコンピュータ数形式で動作できる能力が拡張されました。結果的に、各世代ごとにGPUのスループットが大幅に向上します。
第一世代
パスカルおよびボルタ計算の可視化、テンソルコアありおよびなし - ソース
最初の世代のテンソルコアは、ボルタGPUマイクロアーキテクチャと共に登場しました。これらのコアはFP16数値形式を使用した混合精度トレーニングを可能にしました。これにより、これらのGPUの潜在的なスループットがテラFLOPの観点で最大12倍まで向上しました。前の世代のパスカルGPUと比較して、フラッグシップV100の640コアは最大5倍の性能向上を提供します。 (出典)
第二世代
パスカルとチューリングの計算の視覚化、異なる精度フォーマットの速度を比較 - ソース
第2世代のテンソルコアは、チューリングGPUのリリースと共に登場しました。サポートされるテンソルコアの精度は、FP16からさらにInt8、Int4、およびInt1を含むように拡張されました。これにより、混合精度トレーニング操作が可能になり、Pascal GPUの最大32倍のパフォーマンススループットを加速することができました!
第2世代GPUに加えて、Turing GPUにはレイトレーシングコアも含まれており、これは3D環境における光や音のグラフィックビジュアライゼーション特性を計算するために使用されます。RTX Quadro GPUを使用することで、これらの専門コアを活用し、ゲームや動画制作プロセスを次のレベルに引き上げることができます。
第三世代

アンペアシリーズのGPUは、第3世代のテンソルコアとこれまでで最も強力なものを導入しました。
Ampere GPUでは、アーキテクチャがVoltaおよびTuringマイクロアーキテクチャの以前の革新を基に、計算能力をFP64、TF32、およびbfloat16精度に拡張しています。これらの追加精度フォーマットは、深層学習のトレーニングおよび推論タスクをさらに加速させるために機能します。たとえば、TF32フォーマットはFP32と同様に機能し、コードを変更することなく最大20倍の速度向上を実現します。これに加えて、自動混合精度を実装することで、数行のコードでトレーニングをさらに2倍に加速させることができます。さらに、Ampereマイクロアーキテクチャには、まばら行列数学に特化した機能や、超高速のマルチGPUインタラクションを可能にする第3世代NVLink、そして第3世代レイトレーシングコアなどの追加機能があります。
これらの進展により、Ampere GPU、特にデータセンター用のA100は、現在市場で最も強力なGPUです。予算に余裕がない場合、A4000、A5000、A6000のようなワークステーショングPUラインも、強力なAmpereマイクロアーキテクチャとその第3世代テンソルコアの利点を低価格で享受するための優れた選択肢を提供します。
第四世代
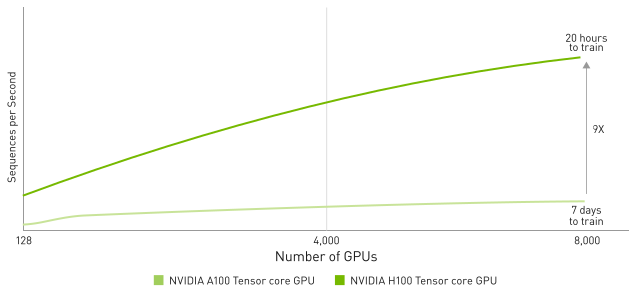
第4世代のテンソルコアは、将来的にホッパーマイクロアーキテクチャとともにリリースされます。2022年3月に発表された次期H100は、第4世代のテンソルコアを搭載し、FP8精度フォーマットの処理能力が向上しており、NVIDIAは「前世代に比べて驚異の30倍」という大規模言語モデルの速度向上を主張しています。
これに加えて、NVIDIAは新しいNVLink技術により、最大256のH100 GPUが接続できると主張しています。これは、データワーカーが操作できる計算規模をさらに引き上げる大きな恩恵となります。
どのGPUにテンソルコアがありますか?
| GPU | テンソルコアはありますか? | レイ トレーシング コアはありますか? |
|---|---|---|
| M4000 | いいえ | いいえ |
| P4000 | いいえ | いいえ |
| P5000 | いいえ | いいえ |
| P6000 | いいえ | いいえ |
| V100 | はい | いいえ |
| RTX4000 | はい | はい |
| RTX5000 | はい | はい |
| A4000 | はい | はい |
| A5000 | はい | はい |
| A6000 | はい | はい |
| A100 | はい | はい |
GPUクラウドは、Maxwell、Pascal、Volta、Turing、Ampereマイクロアーキテクチャを含む、過去5世代のさまざまなGPUを提供しています。
マクスウェルおよびパスカルのマイクロアーキテクチャは、テンソルコアとレイトレーシングコアの開発に先立っています。この構成の違いの影響は、これらのマシンのディープラーニングのベンチマークデータを見ると非常に明らかであり、メモリのような類似の仕様を持つ場合、より最近のマイクロアーキテクチャが古いマイクロアーキテクチャよりも優れていることを明確に示しています。
V100は、一般的にTensorコアはあるがレイトレーシングコアはない唯一のGPUです。全体としては優れたディープラーニングマシンですが、V100はTensorコアを搭載した最初のデータセンターGPUでした。その古い設計のため、ディープラーニングタスクにおける性能ではA6000のようなワークステーショングPUに後れを取っています。
ワークステーション用のGPU、RTX4000およびRTX5000は、ディープラーニング用のGPUプラットフォームで優れたコストパフォーマンスを提供します。たとえば、第二世代のテンソルコアの性能向上により、RTX5000はV100と比較して、バッチサイズやベンチマークタスクの完了時間においてほぼ同等の性能を達成します。
Ampere GPUラインは、第三世代のテンソルコアと第二世代のレイトレーシングコアを搭載し、前世代に比べて前所未聞のスループットの向上を実現しています。この技術により、A100は1555 GB/sのスループットを達成し、V100の900 GB/sから大幅に向上しました。
A100に加えて、Ampere GPUのワークステーションラインにはA4000、A5000、A6000が含まれています。これらは、非常に低価格で優れたスループットと強力なAmpereマイクロアーキテクチャを提供します。
ホッパーマイクロアーキテクチャが出荷されると、H100はA100が提供する現在のピークの最大6倍のGPUパフォーマンスを再び引き上げます。H100は、NVIDIAのCEOであるジェンセン・フアンが発表したGTC 2022の基調講演によれば、少なくとも2022年第3四半期までは購入できません。
結論としての考え
GPUの世代ごとの技術的進歩は、部分的にテンソルコア技術の進歩によって特徴づけられます。
このブログ記事で詳述したように、これらのコアは高パフォーマンスの混合精度トレーニングパラダイムを可能にし、Volta、Turing、AmpereのGPUがAI開発のための主力マシンとなることを可能にしました。
これらのテンソルコアの違いとその能力を理解することによって、各次世代がいかにして深層学習タスクのために処理できる生データの量を瞬時に大幅に増加させてきたのかをより明確に理解することができます。
リソース
- Nvidia - テンソルコア
- Nvidia - テンソルコア (2)
- Nvidia - ホッパーアーキテクチャ
- Nvidia - アンペアアーキテクチャ
- Nvidia - チューリングアーキテクチャ
- Nvidia - ボルタアーキテクチャ
- H100 - Nvidiaの製品ページ
- A100 - Nvidia製品ページ
- V100 - Nvidia製品ページ
- TechSpotによるTensor Coreの完全な内訳
- TechCenturionによるテンソルコアの簡潔な要約
- A100 GPUのTensorFloat-32は、AIトレーニングとHPCを最大20倍加速します。