PyTorchでCNNをゼロから書く

紹介
この記事では、PyTorchを使用して畳み込みニューラルネットワーク(CNN)をゼロから構築し、実際のデータセットでトレーニングおよびテストする際にそれらの動作を確認します。
最初に、CNNとは何か、そしてそれがどのように機能するのかを探ります。その後、PyTorchを見て、torchvisionを使用してCIFAR10データセットをロードすることから始めます(コンピュータビジョンに関連するさまざまなデータセットやヘルパー関数が含まれるライブラリ)。次に、ゼロからCNNを構築し、トレーニングします。最後に、モデルをテストします。
以下はこの記事の概要です:
- 紹介
- 畳み込みニューラルネットワーク
- PyTorch
- データの読み込み
- CNNをゼロから作る
- ハイパーパラメータの設定
- トレーニング
- テスト
前提条件
このチュートリアルに従うためには、Pythonコードとニューラルネットワークの基本的な理解が必要であり、PyTorchフレームワークに精通していることも重要です。PyTorchを使用して開発経験がある中級から上級のコーダーにこの資料をお勧めします。
この記事のコードは、通常のホームPCまたはDigitalOcean Dropletで実行でき、特別なVRAMは必要ありません。
畳み込みニューラルネットワーク
畳み込みニューラルネットワーク(CNN)は、入力画像を取り込み、それを出力クラスのいずれかに分類します。各画像は、主に畳み込み層、プーリング層、全結合層のさまざまな層を通過します。以下の画像は、CNN内で画像が通過するものを要約しています。
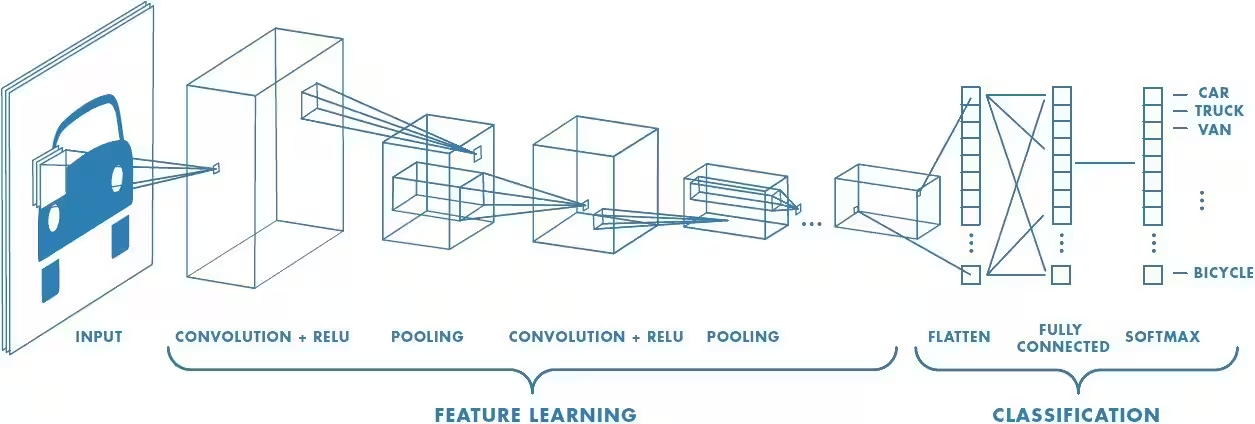
出典: mathworks
畳み込み層
畳み込み層は入力画像から特徴を抽出するために使用されます。これは、入力画像とカーネル(フィルター)との間の数学的操作です。フィルターは画像を通過し、出力は次のように計算されます:

出典: https://www.ibm.com/cloud/learn/convolutional-neural-networks
異なるフィルターが異なる種類の特徴を抽出するために使用されます。以下にいくつかの一般的な特徴を示します:

出典: https://ja.wikipedia.org/wiki/カーネル_(画像処理)
プーリング層
プーリング層は、最も重要な特徴を維持しながら、画像のサイズを縮小するために使用されます。使用される最も一般的なプーリング層のタイプは最大プーリングと平均プーリングで、それぞれ与えられたフィルターのサイズ(つまり、2x2、3x3など)から最大値と平均値を取ります。
例えば、マックスプーリングは次のように機能します:

出典: https://cs231n.github.io/convolutional-networks/
PyTorch
PyTorchは、特に学術研究の分野で最も人気があり、広く使用されている深層学習ライブラリの一つです。これはオープンソースの機械学習フレームワークで、研究のプロトタイピングから生産環境への展開までの過程を加速させます。今日はこの記事で、初めてのCNNを作成するためにこれを使用します。
データロード:データセット
データの読み込みから始めましょう。CIFAR-10データセットを使用します。このデータセットには、10の異なるクラスに属する60,000枚のカラー画像(RGB)が32px x 32pxのサイズで含まれています(クラスごとに6,000枚の画像)。データセットは、50,000枚のトレーニング画像と10,000枚のテスト画像に分かれています。
下記にデータセットのサンプルとそのクラスを見ることができます:
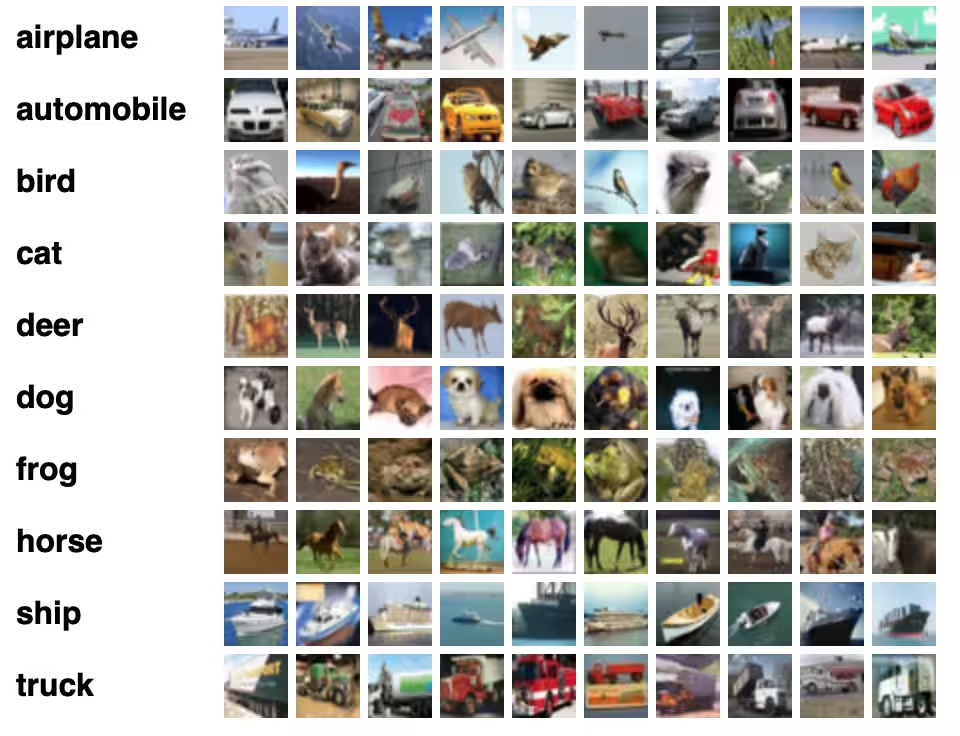
出典: https://www.cs.toronto.edu/~kriz/cifar.html
ライブラリをインポートする
必要なライブラリをインポートし、いくつかの変数を定義することから始めましょう:
Load in relevant libraries, and alias where appropriate
import torch
import torch.nn as nn
import torchvision
import torchvision.transforms as transforms

Define relevant variables for the ML task
batch_size = 64
num_classes = 10
learning_rate = 0.001
num_epochs = 20

Device will determine whether to run the training on GPU or CPU.
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
ライブラリのインポート
デバイスは、トレーニングをGPUまたはCPUで実行するかどうかを決定します。
データセットの読み込み
データセットをロードするために、torchvisionに組み込まれているデータセットを使用します。これにより、データセットをダウンロードする能力と、必要に応じて任意の変換を適用することができます。
まずはコードを見てみましょう:
Use transforms.compose method to reformat images for modeling,
and save to variable all_transforms for later use
all_transforms = transforms.Compose([transforms.Resize((32,32)),
                                     transforms.ToTensor(),
                                     transforms.Normalize(mean=[0.4914, 0.4822, 0.4465],
                                                          std=[0.2023, 0.1994, 0.2010])
                                     ])
Create Training dataset
train_dataset = torchvision.datasets.CIFAR10(root = './data',
                                             train = True,
                                             transform = all_transforms,
                                             download = True)

Create Testing dataset
test_dataset = torchvision.datasets.CIFAR10(root = './data',
                                            train = False,
                                            transform = all_transforms,
                                            download=True)

Instantiate loader objects to facilitate processing
train_loader = torch.utils.data.DataLoader(dataset = train_dataset,
                                           batch_size = batch_size,
                                           shuffle = True)


test_loader = torch.utils.data.DataLoader(dataset = test_dataset,
                                           batch_size = batch_size,
                                           shuffle = True)
データの読み込みと変換
このコードの一部を詳しく見てみましょう:
- 私たちは変換をいくつか書くことから始めます。画像のサイズを変更し、テンソルに変換し、入力画像の各バンドの平均と標準偏差を使用して正規化します。これらを自分で計算することもできますが、オンラインで入手可能です。
- 次に、データセットをロードします。トレーニングとテストの両方です。まだダウンロードされていない場合にダウンロードされるように、downloadをTrueに設定します。
- 全データセットを一度にRAMに読み込むことは良い習慣ではなく、コンピュータを大きく遅らせる可能性があります。そのため、データローダーを使用し、データをバッチで読み込むことによってデータセットを反復処理できるようにしています。
- 次に、2つのデータローダー(訓練用/テスト用)を作成し、バッチサイズを設定し、シャッフルをTrueに設定して、各クラスの画像がバッチに含まれるようにします。
CNNをゼロから作る
コードに入る前に、PyTorchでニューラルネットワークをどのように定義するかを説明しましょう。
- まず、PyTorchの
nn.Moduleクラスを拡張する新しいクラスを作成します。これはニューラルネットワークを作成する際に必要で、便利なメソッドがいくつか提供されます。 - 次に、ニューラルネットワークの層を定義する必要があります。これはクラスの
__init__メソッドで行われます。私たちは単に層に名前を付けて、それから望む適切な層、例えば畳み込み層、プーリング層、全結合層などに割り当てます。 - 最後に行うことは、私たちのクラスに
forwardメソッドを定義することです。このメソッドの目的は、入力データがさまざまな層を通る順序を定義することです。
さあ、コードに入っていきましょう:
Creating a CNN class
class ConvNeuralNet(nn.Module):
 Determine what layers and their order in CNN object
    def __init__(self, num_classes):
        super(ConvNeuralNet, self).__init__()
        self.conv_layer1 = nn.Conv2d(in_channels=3, out_channels=32, kernel_size=3)
        self.conv_layer2 = nn.Conv2d(in_channels=32, out_channels=32, kernel_size=3)
        self.max_pool1 = nn.MaxPool2d(kernel_size = 2, stride = 2)

        self.conv_layer3 = nn.Conv2d(in_channels=32, out_channels=64, kernel_size=3)
        self.conv_layer4 = nn.Conv2d(in_channels=64, out_channels=64, kernel_size=3)
        self.max_pool2 = nn.MaxPool2d(kernel_size = 2, stride = 2)

        self.fc1 = nn.Linear(1600, 128)
        self.relu1 = nn.ReLU()
        self.fc2 = nn.Linear(128, num_classes)

    # Progresses data across layers
    def forward(self, x):
        out = self.conv_layer1(x)
        out = self.conv_layer2(out)
        out = self.max_pool1(out)

        out = self.conv_layer3(out)
        out = self.conv_layer4(out)
        out = self.max_pool2(out)

        out = out.reshape(out.size(0), -1)

        out = self.fc1(out)
        out = self.relu1(out)
        out = self.fc2(out)
        return out
上に説明したように、私たちはまずnn.Moduleクラスを継承するクラスを作成し、その後で__init__およびforwardのそれぞれの中で層とその実行順序を定義します。
ここで注目すべきいくつかの点があります:
nn.Conv2dは畳み込み層を定義するために使用されます。受け取るチャンネルと、返すべきチャンネルの数、カーネルサイズを定義します。私たちはRGB画像を使用しているため、3チャンネルから始めます。nn.MaxPool2dは、カーネルサイズとストライドのみを必要とする最大プーリング層です。nn.Linearは全結合層であり、nn.ReLUは使用される活性化関数です- メソッドの
forwardでは、シーケンスを定義し、全結合層の前で出力を整形して全結合層への入力に合わせます。
ハイパーパラメータの設定
では、トレーニングの目的のためにいくつかのハイパーパラメータを設定しましょう。
model = ConvNeuralNet(num_classes)

Set Loss function with criterion
criterion = nn.CrossEntropyLoss()

Set optimizer with optimizer
optimizer = torch.optim.SGD(model.parameters(), lr=learning_rate, weight_decay = 0.005, momentum = 0.9)

total_step = len(train_loader)
ハイパーパラメータ
まず、クラス数でモデルを初期化します。その後、損失関数と最適化手法として交差エントロピーとSGD(確率的勾配降下法)を選択します。これらには異なる選択肢がありますが、実験した結果、これが最大の精度につながることがわかりました。また、さまざまなバッチを通じてイテレーションを容易にするために、変数total_stepを定義します。
トレーニング
さあ、私たちのモデルのトレーニングを始めましょう:
We use the pre-defined number of epochs to determine how many iterations to train the network on
for epoch in range(num_epochs):
Load in the data in batches using the train_loader object
    for i, (images, labels) in enumerate(train_loader):
        # Move tensors to the configured device
        images = images.to(device)
        labels = labels.to(device)

        # Forward pass
        outputs = model(images)
        loss = criterion(outputs, labels)

        # Backward and optimize
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

    print('Epoch [{}/{}], Loss: {:.4f}'.format(epoch+1, num_epochs, loss.item()))
これはおそらくコードの最も難しい部分です。コードが何をしているのか見てみましょう:
- 私たちはエポックの数を繰り返し、その後にトレーニングデータのバッチを繰り返します。
- 私たちは、使用しているデバイス、つまり GPU または CPU に応じて、画像とラベルを変換します。
- フォワードパスでは、モデルを使用して予測を行い、その予測と実際のラベルに基づいて損失を計算します。
- 次に、逆伝搬を行い、実際に重みを更新してモデルを改善します。
- その後、毎回の更新前に
optimizer.zero_grad()関数を使用して勾配をゼロに設定します。 - 次に、
loss.backward()関数を使用して新しい勾配を計算します。 - そして最後に、
optimizer.step()関数で重みを更新します。
出力は次のように見ることができます。

トレーニング損失
ご覧のように、損失はエポックが増えるにつれてわずかに減少しています。これは良い兆候です。しかし、最後に振動していることに気づくかもしれません。これはモデルが過学習しているか、batch_sizeが小さいことを意味する可能性があります。何が起こっているのかを確かめるためにテストする必要があります。
テスト
さあ、モデルをテストしてみましょう。テストのためのコードは、重みを更新しないため勾配を計算することを除けば、トレーニングとはそれほど異なりません。
with torch.no_grad():
    correct = 0
    total = 0
    for images, labels in train_loader:
        images = images.to(device)
        labels = labels.to(device)
        outputs = model(images)
        _, predicted = torch.max(outputs.data, 1)
        total += labels.size(0)
        correct += (predicted == labels).sum().item()

    print('Accuracy of the network on the {} train images: {} %'.format(50000, 100 * correct / total))
コードをtorch.no_grad()の中にラップします。なぜなら、勾配を計算する必要がないからです。その後、モデルを使って各バッチを予測し、どのくらいの正確さで予測できたかを計算します。最終的な結果は約83%の精度です:

正確さ
これで終わりです。私たちはPyTorchでゼロから畳み込みニューラルネットワークを作成することに成功しました!
結論
私たちはCNNについて学ぶことから始めました。CNNにはどのような層があり、どのように機能するのかを学びました。そして、今日利用可能な最も人気のある深層学習ライブラリの一つであるPyTorchを紹介しました。私たちは、PyTorchを使うことでCNNを使った実験が非常に簡単になることを学びました。
次に、CIFAR-10データセット(60,000枚の画像を含む人気のあるトレーニングデータセット)を読み込み、いくつかの変換を行いました。
それから、私たちは最初からCNNを構築し、それにいくつかのハイパーパラメータを定義しました。最後に、私たちはCIFAR10でモデルを訓練し、テストセットで良好な精度を達成しました。