画像超解像:包括的レビュー

紹介
画像超解像は、画像の解像度を低解像度(LR)から高解像度(HR)に向上させるタスクを指します。これは次のアプリケーションで広く使用されています:
- 監視: セキュリティカメラから得られた低解像度の画像を検出し、識別し、顔認識を行うこと。
- 医学: 高解像度のMRI画像を撮影することは、スキャン時間、空間のカバレッジ、信号対雑音比(SNR)に関して難しい場合があります。超解像度は、低解像度のMRI画像から高解像度のMRIを生成することで、これを解決します。
- メディア:スーパー解像度は、メディアを低解像度で送信し、その場でアップスケールすることでサーバーコストを削減するために使用できます。深層学習技術は、画像および動画のスーパー解像度の問題を解決するのにかなり成功しています。この記事では、関係する理論、使用されるさまざまな技術、損失関数、メトリクス、および関連するデータセットについて説明します。

(ソース)
前提条件
画像超解像に関するこのレビューに入る前に、以下の概念について基本的な理解を持っておくべきです:
- デジタル画像処理:画像フィルタリング、サンプリング、補間などの基本的な技術に精通していること。
- 機械学習の基本: 教師あり学習、損失関数、モデル評価指標などのコア概念の理解。
- ディープラーニングの基礎: ニューラルネットワーク、特に畳み込みニューラルネットワーク(CNN)の知識と、コンピュータビジョンタスクにおけるその応用。
- AIのための数学: 特にモデル訓練に使用される最適化および統計的方法に関して、線形代数、微積分、確率の理解が必要です。
- プログラミングスキル: 実践的な実装のためのPythonやTensorFlow、PyTorchなどの人気の深層学習ライブラリの経験。
画像超解像
低解像度の画像は、以下の式を使用して高解像度の画像からモデル化できます。ここで、Dは劣化関数、Iyは高解像度画像、Ixは低解像度画像、そして$\sigma$はノイズです。
$$I_{x}=D(I_y; \sigma) $$
劣化パラメータ D と $\sigma$ は不明であり、高解像度画像と対応する低解像度画像のみが提供されています。ニューラルネットワークのタスクは、HRおよびLR画像データのみを使用して劣化の逆関数を見つけることです。
超解像技術と手法
このタスクを解決するために使用される多くの方法があります。以下を取り上げます:
- プレアップサンプリングスーパー解像度
- ポストアップサンプリング超解像
- 残差ネットワーク
- マルチステージ残差ネットワーク
- 再帰ネットワーク
- 進行再構築ネットワーク
- マルチブランチネットワーク
- 注意に基づくネットワーク
- 生成モデル
各例についていくつかのアルゴリズムの例を見ていきます。
プレアップサンプリングスーパー解像度
このブランケットに含まれる方法は、バイキュービック補間やディープラーニングなどの従来の技術を使用して、アップサンプリングされた画像を洗練させます。
最も人気のある手法であるSRCNNは、深層学習を初めて使用したものであり、印象的な結果を達成しました。
SRCNN

ソース
SRCNNは、3つのレイヤーからなるシンプルなCNNアーキテクチャです。1つはパッチ抽出、1つは非線形マッピング、そして1つは再構成のためのレイヤーです。パッチ抽出レイヤーは、入力から密なパッチを抽出し、畳み込みフィルターを使用してそれらを表現するために使用されます。非線形マッピングレイヤーは、チャネル数を変更し、非線形性を追加するために使用される1×1の畳み込みフィルターで構成されています。おそらくお分かりのように、最後の再構成レイヤーは高解像度の画像を再構成します。
MSE損失関数はネットワークの訓練に使用され、PSNR(後述の指標セクションで話し合います)は結果の評価に使用されます。これらの両方については後ほどより詳しく説明します。
VDSR

ソース
非常に深い超解像(VDSR)はSRCNNの改良版であり、以下の機能が追加されています:
- 名前が示すように、小さい 3×3 の畳み込みフィルターを持つ深いネットワークが、大きな畳み込みフィルターを持つ小さいネットワークの代わりに使用されます。これは VGG アーキテクチャに基づいています。
- ネットワークは、上の図に示されているように、直接的なマッピング(SRCNNのような)を学ぶのではなく、出力画像と補間された入力の残差を学ぼうとします。これにより、タスクが簡素化されます。初期の低解像度画像は、最終的な高解像度出力を得るためにネットワークの出力に追加されます。
- 勾配クリッピングは、高い学習率で深層ネットワークをトレーニングするために使用されます。
ポストアップサンプリング超解像
前アップサンプリングSRの特徴抽出プロセスは高解像度空間で行われるため、必要な計算能力も高めです。後アップサンプリングSRは、低解像度空間で特徴抽出を行い、最後にのみアップサンプリングを行うことでこれを解決し、計算を大幅に削減します。また、アップサンプリングには単純なバイキュービック補間を使用する代わりに、デコンボリューション/サブピクセル畳み込みの形式で学習されたアップサンプリングを使用しており、ネットワークをエンドツーエンドでトレーニング可能にしています。
この構造に従って、いくつかの人気のあるテクニックについて話し合いましょう。
FSRCNN

ソース
上の図に見られるように、SRCNNとFSRCNNの主な違いは次のとおりです。
- 最初に前処理やアップサンプリングは行われませんでした。特徴抽出は低解像度空間で行われました。
- 最初の5×5畳み込みの後に1×1畳み込みが使用され、チャネルの数を減らし、計算量とメモリを減らす。この手法は、Inceptionネットワークの開発方法に似ています。
- 大きな畳み込みフィルターの代わりに、複数の3×3畳み込みが使用されます。これは、VGGネットワークのように、アーキテクチャを簡素化してパラメーターの数を減らす方法と似ています。
- アップサンプリングは学習された逆畳み込みフィルターを使用して行われ、モデルが改善されます。
FSRCNNは最終的にSRCNNよりも良い結果を出し、しかも速いです。
ESPCN
ESPCNは、アップサンプリングのために逆畳み込み層を置き換えるためのサブピクセル畳み込みの概念を導入します。これにより、関連する2つの問題が解決されます:
- デコンボリューションは高解像度空間で行われるため、より計算コストが高くなります。
- これは、デコンボリューションにおけるチェッカーボード問題を解決します。この問題は、畳み込みの重なり操作によって発生します(以下に示されています)。

ソース
サブピクセル畳み込みは、下記の図に示すように、深度を空間に変換することで機能します。低解像度画像の複数のチャンネルからのピクセルが、高解像度画像の単一のチャンネルに再配置されます。例として、サイズが5×5×4の入力画像は、最終的な4つのチャンネルのピクセルを単一のチャンネルに再配置し、10×10のHR画像を生成します。

ソース
では、下の図に基づいたいくつかのアーキテクチャについてさらに議論しましょう。

ソース
残差ネットワーク
EDSR

ソース
EDSRアーキテクチャはSRResNetアーキテクチャに基づいており、複数の残差ブロックで構成されています。EDSRの残差ブロックは上記に示されています。SRResNetとの主な違いは、バッチ正規化(BN)層が取り除かれていることです。著者は、BNが入力を正規化し、ネットワークの範囲を制限すると述べています。BNを取り除くことで精度が向上します。また、BN層はメモリを消費し、その削除により最大40%のメモリ削減が実現され、ネットワークのトレーニングがより効率的になります。

ソース
MDSR
MDSRはEDSRの拡張であり、2倍、3倍、4倍の対応する解像度出力を持つ複数の入力および出力モジュールを備えています。最初に、スケール特有の入力用の前処理モジュールがあり、5×5カーネルを持つ2つの残差ブロックで構成されています。前処理層では大きなカーネルが使用されており、ネットワークを浅く保ちながら、高い受容野を実現しています。スケール特有の前処理モジュールの最後には、全ての解像度のデータに共通する残差ブロック、すなわち共有残差ブロックがあります。最後に、共有残差ブロックの後にスケール特有のアップサンプリングモジュールがあります。MDSRの全体的な深さは単一スケールのEDSRに対して5倍ですが、パラメータの数は2.5倍であり、5倍ではありません。これは共有パラメータによるものです。MDSRは、スケール特有のEDSRモデルの合計よりもパラメータが少ないにもかかわらず、スケール特有のEDSRと同等の結果を達成します。
CARN
論文「カスケーディング残差ネットワークによる高速で正確かつ軽量な超解像」では、著者たちは従来の残差ネットワークに基づいて以下の進展を提案しています:
- ローカルおよびグローバルレベルの両方で階層的なメカニズムを使用し、複数の層からの特徴を取り入れて、ネットワークがより多くの情報を受け取る能力を持つようにする。
- CARNに加えて、より軽量なアーキテクチャを持ち、結果の劣化があまりない小型のCARN-Mが再帰的ネットワークアーキテクチャの助けを借りて提案されています。

ソース
上記のCARNにおけるグローバルな接続が視覚化されています。各カスケードブロックの1×1畳み込みによる culminates は、すべての前のカスケードブロックと初期入力からの入力を受け取り、その結果、情報の効果的な転送を実現します。

ソース
カスケードブロック内の各残差ブロックは、主入力とすべての以前の残差ブロックからの接続を持つ1x1の畳み込みで終わります。これは、グローバルカスケードの機能に似ています。
ResNetの残差ブロックは、新たに設計されたResidual-Eブロックに置き換えられ、これはMobileNetの深さごとの畳み込みからインスパイアを受けています。深さごとの畳み込みの代わりに、グループ畳み込みが使用されており、結果として、グループサイズに応じて1.8倍から14倍の計算量の減少が示されています。
パラメーターの数をさらに減らすために、共有残差ブロック(再帰ブロック)が使用されるため、元の数の最大で3倍までパラメーターの数が減少します。上記の(d)に示すように、再帰共有ブロックはパラメーターの合計数を削減するのに役立ちます。
マルチステージ残差ネットワーク
低解像度空間と高解像度空間での特徴抽出のタスクを別々に扱うために、性能向上のためにいくつかのアーキテクチャでマルチステージ設計が考慮されています。最初のステージでは粗い特徴を予測し、後のステージでそれを改善します。それでは、これらのマルチステージネットワークの1つに関わるアーキテクチャについて話し合いましょう。
BTSRN

ソース
上の図からわかるように、BTSRNは2つのステージから構成されています:低解像度(LR)ステージと高解像度(HR)ステージです。LRステージは6つの残差ブロックで構成されているのに対し、HRステージには4つの残差ブロックが含まれています。HRステージでの畳み込みはLRステージよりも計算が多く必要です。なぜなら入力サイズが大きいためです。両方のステージのブロック数は、精度とパフォーマンスのトレードオフを実現するように決定されています。
LRステージの出力は、HRステージに送信される前にアップサンプリングされます。これは、デコンボリューション層の出力と最近傍補完アップサンプリングの出力を加えることによって行われます。
著者たちは、上の図の(d)に示されている新しい残差ブロック
EDSRと同様に、バッチ正規化は再センタリングと再スケーリングを防ぐために避けられています。その理由は、それが有害であると判明しているからです。これは、超解像が回帰タスクであるため、ターゲット出力が入力の一次統計と高い相関関係にあるからです。
再帰ネットワーク
再帰型ネットワークは、CARN-M上で見られるように、畳み込み層で共有ネットワークパラメータを使用してメモリ使用量を削減します。再帰ユニットに関与する他のいくつかのアーキテクチャについて話しましょう。

ソース
DRCN
深い再帰的畳み込みネットワーク(DRCN)は、同じ畳み込み層を複数回適用することを含みます。上の図に見られるように、残差ブロック内の畳み込み層は共有されています。

ソース
すべての中間共有畳み込みブロックからの出力と入力は再構成層に送られ、すべての入力を使用して高解像度の画像が生成されます。出力を生成するために複数の入力が使用されるため、このアーキテクチャはネットワークのアンサンブルと考えることができます。
DRRN
深い再帰残差ネットワーク(DRRN)は、単純な畳み込み層の代わりにネットワーク内に残差ブロックを持つことでDRCNを改良したものです。すべての残差ブロック内のパラメータは、上の画像に見られるように他の残差ブロックと共有されています。

ソース
グラフで見るように、DRRNはSRCNN、ESPCN、VDSR、DRCNを上回っており、パラメータの数も同等です。
進化的再構築ネットワーク
一般的にCNNは単一のショットで出力を提供しますが、大きなスケールファクター(例えば8倍)で高解像度の画像を得ることは、ニューラルネットワークにとって難しい課題です。これを解決するために、一部のネットワークアーキテクチャは画像の解像度を段階的に上げます。さて、このスタイルに従ういくつかのネットワークについて説明しましょう。
LAPSRN
ソース
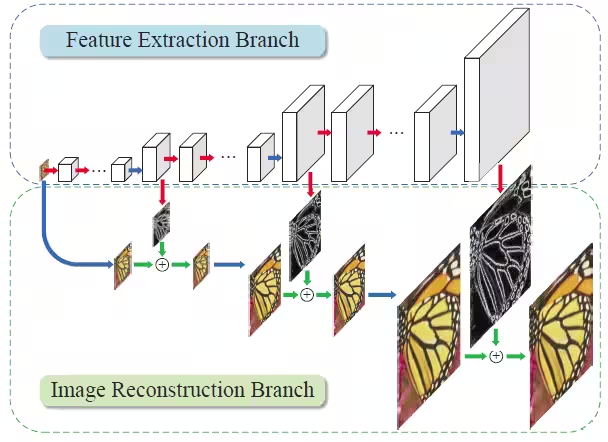
LAPSRN、またはMS-LAPSRNは、ラプラスピラミッド構造で構成されており、段階的アプローチを使用して画像を2倍、4倍、8倍にアップスケールすることができます。
上の図に示すように、LAPSRNは複数のステージで構成されています。このネットワークは、特徴抽出ブランチと画像再構築ブランチの2つのブランチで構成されています。各反復ステージは、下の図に示されているように、特徴埋め込みブロックと特徴アップサンプリングブロックで構成されています。入力画像は、低解像度空間で特徴を抽出するために特徴埋め込み層を通過し、その後、転置畳み込みを使用してアップサンプリングされます。出力されたものは残差画像であり、これは補間された入力に加えられて高解像度画像を得るために使用されます。特徴アップサンプリングブロックの出力も次のステージに渡され、これによりこのステージの高解像度出力が洗練され、次のレベルにスケールされます。より低解像度の出力がさらなるステージの洗練に使用されるため、共有学習が行われ、ネットワークの性能が向上します。

ソース
ネットワークのメモリフットプリントを削減するために、特徴埋め込みや特徴アップサンプリングなどのパラメーターは、段階を通じて再帰的に共有されます。

ソース
特徴埋め込みブロック内で、個々の残差ブロックは、パラメータの数をさらに減らすために共有畳み込みパラメータ(上の図に示されている)で構成されています。
著者たちは、各LR入力が複数のHR表現を持つ可能性があるため、L2損失関数がすべての表現にわたって滑らかな出力を生成し、その結果、画像がシャープに見えなくなると主張しました。これに対処するために、外れ値をより良く処理できるシャルボニエ損失関数が使用されます。
マルチブランチネットワーク
今までのところ、私たちはトレンドを見てきました:より深いネットワークはより良い結果をもたらします。しかし、深いネットワークのトレーニングは情報の流れの問題のために難しいです。残差ネットワークはショートカット接続を使用することで、これをある程度解決しています。マルチブランチネットワークは、情報が通過できる複数のブランチを持つことで情報の流れを改善し、複数の受容野からの情報の統合をもたらし、より良いトレーニングを実現します。この技術を採用しているいくつかのネットワークについて議論しましょう。
CMSC
他の超解像フレームワークと同様に、カスケード多段階クロスネットワーク(CMSC)には、特徴抽出層、カスケードサブネット、および再構築層があります - 下に示されています。

ソース
カスケードされたサブネットワークは、(b)に示されているように、2つのブランチで構成されています。各ブランチは異なるサイズのフィルターを持っており、したがって異なる受容野を生成します。モジュール全体で異なる受容野からの情報を融合することで、情報の流れが改善されます。MSCの複数のブロックが互いに重ねられ、出力とHR画像との違いを徐々に減少させます。すべてのブロックからの出力は、最終的なHR出力を得るために再構成ブロックに一緒に渡されます。
IDN
情報蒸留ネットワーク(IDN)は、超解像のタスクで高速かつ正確な結果を達成するために提案されています。他の多枝ネットワークと同様に、IDNは深いネットワーク内の情報フローを改善するために複数の枝の能力を活用しています。
IDNアーキテクチャは、特徴抽出を行うFBlock、複数のDBlock、および学習したアップスケーリングを達成するための転置畳み込みを行うRBlockで構成されています。この論文の貢献は、強化ユニットと圧縮ユニットの2つのユニットからなるDBlockにあります。

強化ユニットの構造は上の図に示されています。入力はサイズ3×3の3つの畳み込みフィルタを通過し、その後スライスされます。スライスの一部は最初の入力と連結され、ショートカット接続を介して最終層に渡されます。残りのスライスは、別のサイズ3×3の畳み込みフィルタのセットを通過します。最終出力は、両方の入力と最終層の和を取ることで生成されます。このような構造を持つことで、短距離情報と長距離情報の両方を同時にキャプチャするのに役立ちます。
圧縮ユニットは、強化ユニットの出力を受け取り、1×1の畳み込みフィルターを通してチャンネル数を圧縮(または減少)させます。
注意に基づくネットワーク
これまでに議論したネットワークは、すべての空間的な位置とチャネルに同じ重要性を与えています。一般的に、画像内の異なる領域に選択的な注意を与えることで、はるかに良い結果を得ることができます。これから、これを達成するためのいくつかのアーキテクチャについて議論します。
SelNet

ソース
SelNetは、畳み込みブロックの最後に新しい選択ユニットを提案し、どの情報を選択的に渡すかを決定するのに役立ちます。選択モジュールは、ReLu活性化に続いて1×1の畳み込みとシグモイドゲーティングで構成されています。選択ユニットは、選択モジュールと恒等接続の乗算です。
ネットワークの終わりに、学習したアップスケーリングを実現するためにサブピクセル層(ESPCNに似たもの)が保持されます。ネットワークは残差の高解像度(HR)画像を学習し、それが補間された入力に加えられて最終的な高解像度画像が得られます。
RCAN
この記事全体を通して、より深いネットワークがパフォーマンスを向上させることを観察してきました。より深いネットワークを訓練するために、Residual Channel Attention Networks(RCAN)はチャネルアテンションを持つRIRモジュールを提案しています。これについて詳しく議論しましょう。

ソース
RCANの入力は、特徴抽出のために単一の畳み込みフィルターを通過し、その後、長いスキップ接続を通じて最終層にバイパスされます。長いスキップ接続は、LR画像から低周波信号を運ぶために追加され、一方、メインネットワーク(すなわちRIR)は高周波情報のキャプチャに重点を置いています。
RIRは複数のRGブロックで構成されており、各ブロックは上記の図に示されている構造を持っています。各RGブロックには、複数のRCABモジュールとショートスキップ接続と呼ばれるスキップ接続があり、低周波信号を伝達するのに役立ちます。

ソース
RCABは、チャンネルアテンションを実現するためのGAPモジュールを含む構造(上記参照)を持ち、SqueezeNetのSqueeze and Exciteブロックに似ています。チャンネルごとのアテンションは、畳み込みブロックのシグモイドゲーティング関数からの出力に掛け算されます。この出力は、その後、ショートカット入力接続に加えられ、RCABブロックの最終的な出力値が得られます。
生成モデル
これまでに議論したネットワークは、予測された高解像度画像と出力された高解像度画像とのピクセル差を最適化します。この指標はうまく機能しますが、理想的ではありません。人間は画像をピクセルの違いで区別するのではなく、むしろ知覚品質によって区別します。生成モデル(またはGAN)は、知覚的な品質を最適化し、人間の目に心地よい画像を生成しようとします。最後に、いくつかのGAN関連のアーキテクチャを見てみましょう。
SRGAN
ソース
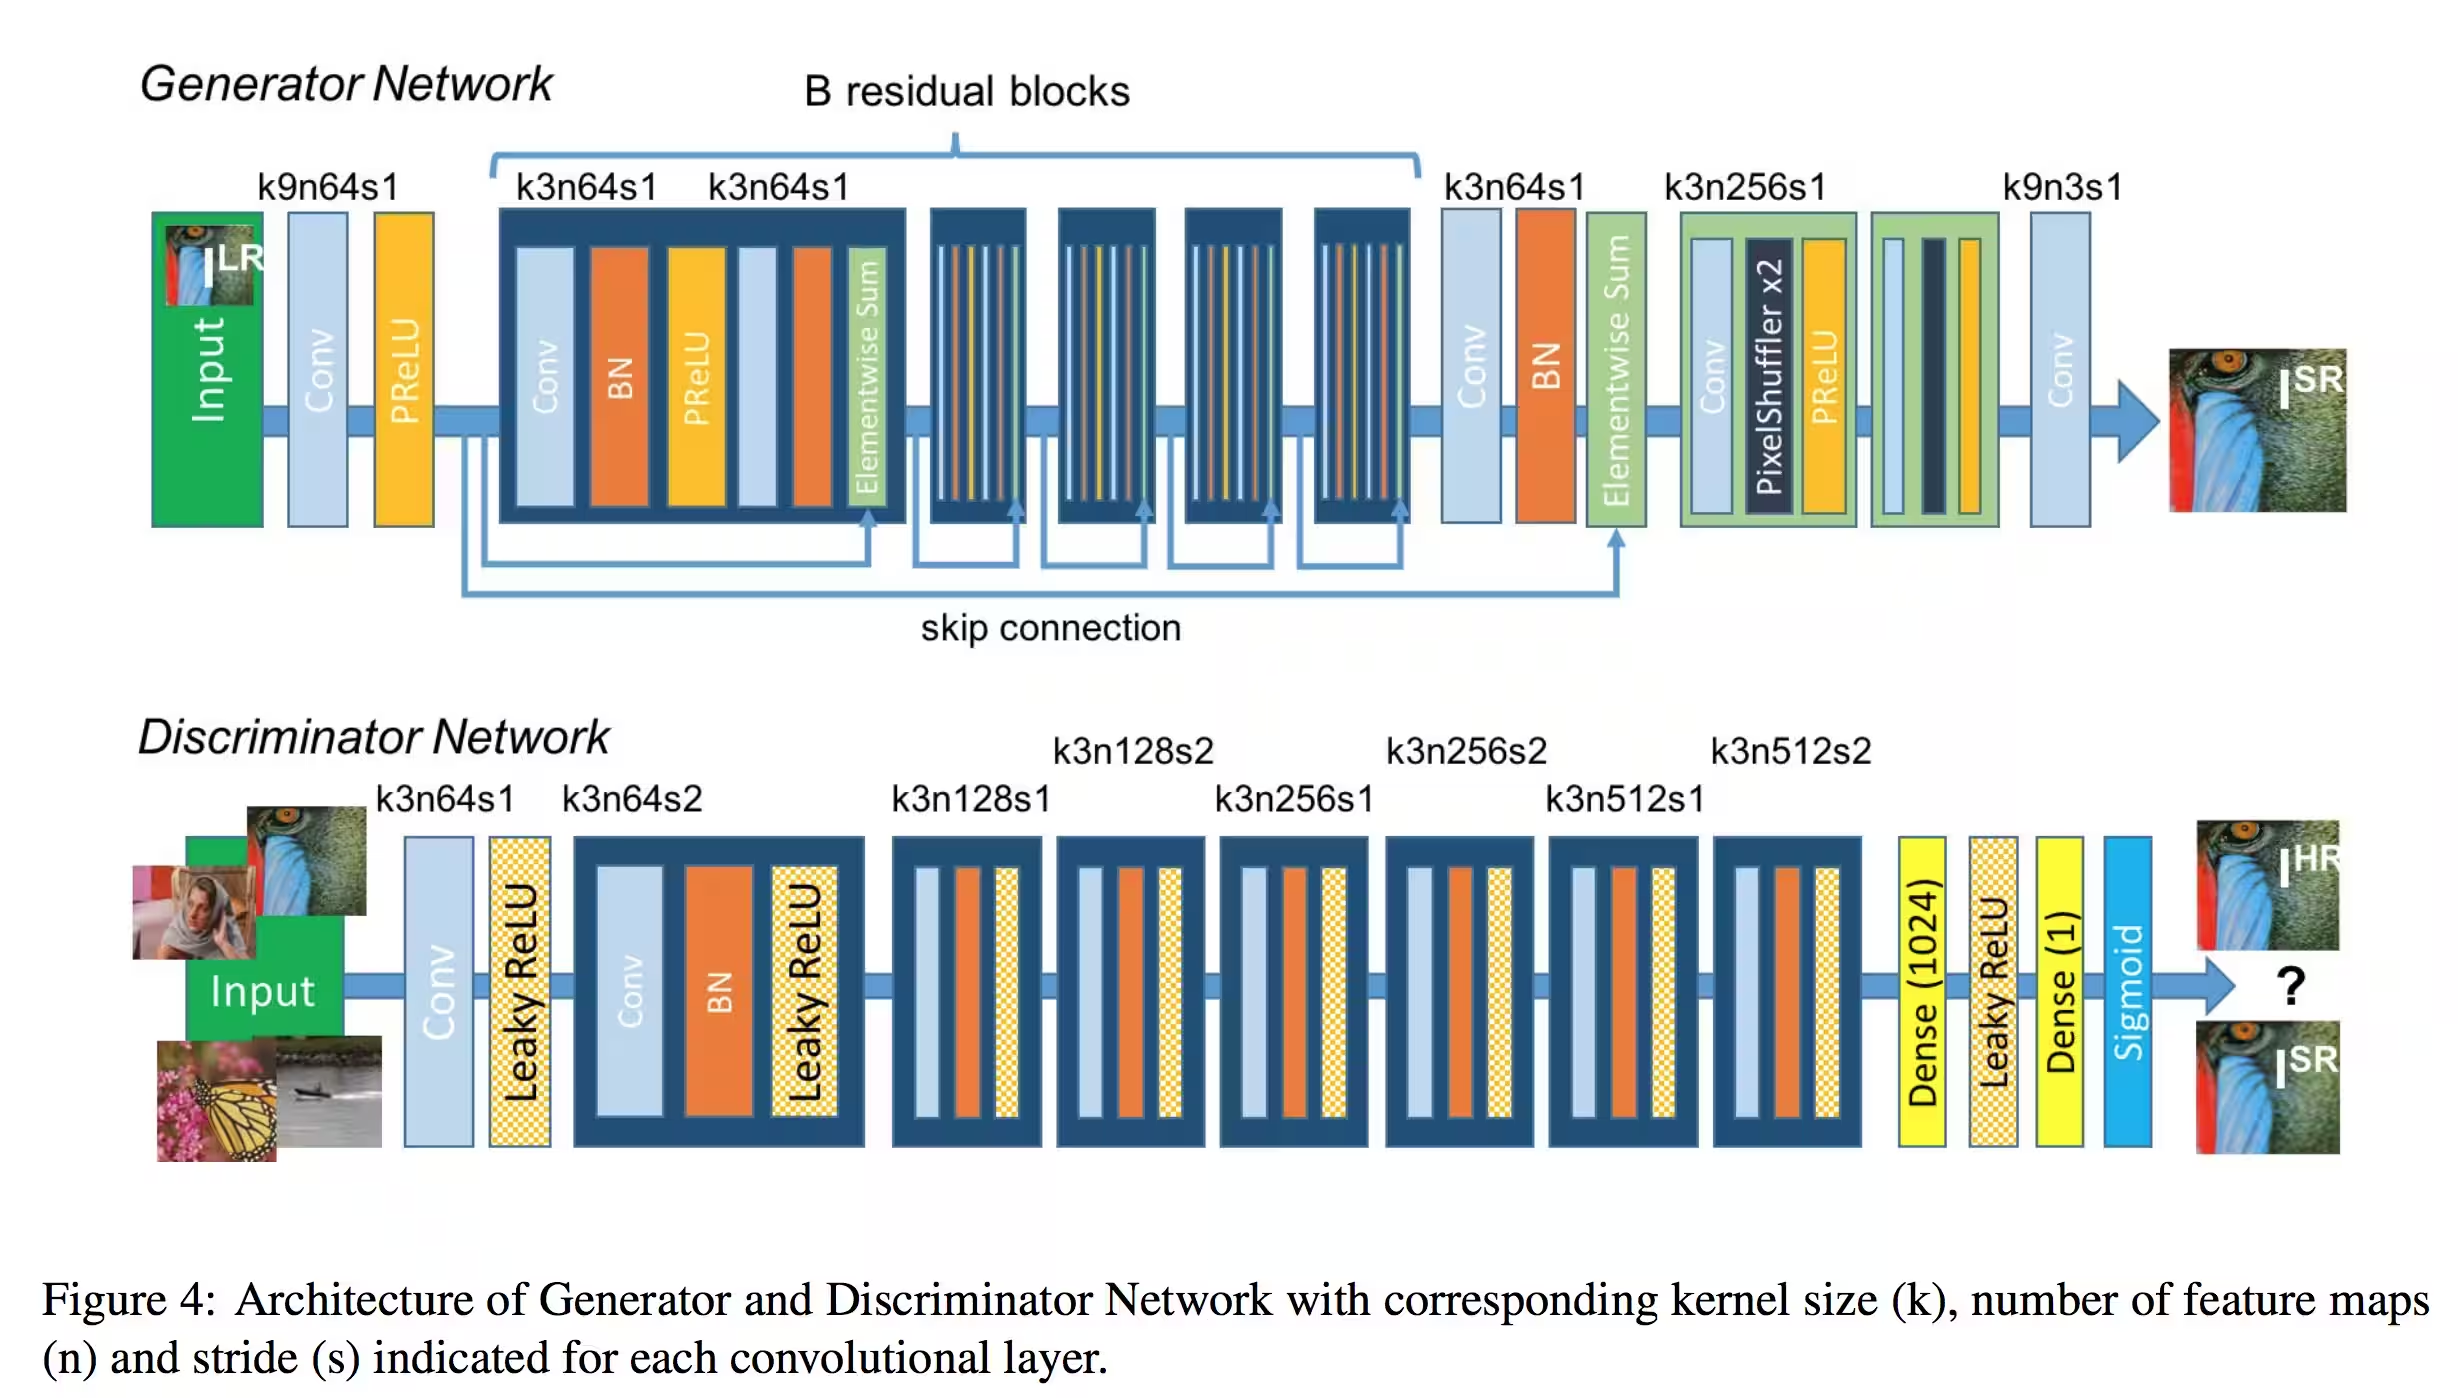
SRGANは、視覚的に魅力的な画像を生成するためにGANに基づいたアーキテクチャを使用しています。バックエンドとしてSRResnetネットワークアーキテクチャを使用し、結果を洗練させるためにマルチタスク損失を採用しています。この損失は3つの項から成り立っています:
- MSE損失はピクセルの類似性を捉えています。
- 深層ネットワークを使用して高レベルの情報を捉えるために使われる知覚類似性損失
- 敵対的損失は識別器からのものです
得られた結果は比較的低いPSNR値を持っていたが、モデルはより多くのMOS、つまり結果においてより良い知覚品質を達成しました。
EnhanceNet
EnhanceNetは、残差学習を用いた全畳み込みネットワークを使用しており、より細かいテクスチャ情報を捉えるために損失関数に追加の項を用いています。SRGANで説明された損失に加えて、スタイル転送におけるものに似たテクスチャ損失が用いられ、より細かいテクスチャ情報を捉えています。

ソース
ESRGAN
ESRGANはSRGANの上に相対的判別器を追加することによって改善されています。利点は、ネットワークが画像が本物か偽物かを判断するだけでなく、生成された画像と比較して本物の画像をより現実味がないように見せるように訓練されることです。これにより、判別器を欺くのが助けられます。SRGANではバッチ正規化も削除され、より良い情報の流れのためにDense Blocks(DenseNetに触発されたもの)が使用されます。これらのDense BlocksはRRDBと呼ばれます。
データセット
以下は、スーパー解像ネットワークのトレーニングに使用される一般的なデータセットのいくつかです。
- DIV2K: 800の訓練用、100の検証用、100のテスト用。2K解像度の画像が提供されており、2倍、3倍、4倍のダウンサンプリング係数を持つ高解像度および低解像度の画像が含まれています。NTIRE17チャレンジで提案されました。
- Flickr2K: FLICKRからの2650枚の2K画像。
- ウォータールー:ウォータールー探査データベースには、4,744の純粋な自然画像とそれらから作成された94,880の歪んだ画像が含まれています。
損失関数
このセクションでは、ネットワークを訓練するために使用できるさまざまな損失関数について議論します。
- ピクセルロス: これは、超解像ネットワークのトレーニングで使用される最も単純で一般的なロス関数の種類です。モデルを評価するためにL2、L1、またはその他の差分メトリックが使用されます。ピクセルロスでのトレーニングはPSNRを最適化しますが、知覚品質を直接最適化するわけではないため、人間の目にとって心地よくない画像を生成する可能性があります。
- 知覚損失: 知覚損失は、生成された画像の高レベルの特徴を与えられたHR出力画像と一致させようとします。これは、VGGのような事前学習済みネットワークを使用し、予測画像と出力画像の間の特徴出力の差を損失として利用することで達成されます。この損失関数はSRGANで導入されました。
- シャルボニエ損失:この損失関数は、一般的なL2損失の代わりにLapSRNで使用されます。結果は、シャルボニエ損失が外れ値に対処するのが得意であり、一般的に滑らかなL2損失で生成された画像と比較して、より鮮明な画像を生成することを示しています。
- テクスチャ損失: EnhanceNetで導入されたこの損失関数は、スタイル転送損失関数に触発されて、特徴出力のグラム行列を最適化しようとします。この損失関数は、ネットワークがHR画像のテクスチャ情報を捉えるように訓練します。
- 敵対的損失:すべてのGAN関連アーキテクチャで使用される敵対的損失は、識別器を欺くのに役立ち、一般的により良い知覚品質の画像を生成します。ESRGANは、相対的識別器を使用することによってこれに追加のバリエーションを加え、ネットワークにただ偽の画像をよりリアルにするだけでなく、リアルな画像をより偽に見せるよう指示します。
メトリクス
このセクションでは、さまざまなモデルの性能を比較するために使用されるさまざまな指標について議論します。
PSNR: ピーク信号対雑音比は、結果の品質を測定するために最も一般的に使用される手法です。これは、下記の式を使用してMSEから直接計算できます。ここで、Lは最大のピクセル値(8ビット画像の場合は255)です。

SSIM: この指標は、下の式を使用して2つの画像の知覚品質を比較するために使用され、両方の画像の平均 ($\mu$)、分散 ($\sigma$)、および相関 (c) を考慮します。
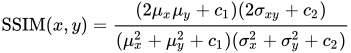
- MOS: 平均意見スコアは、モデルの結果を決定する手動の方法であり、人間に画像を0から5の範囲で評価するように求められます。結果は集計され、平均結果が指標として使用されます。
ソース
今この時点では、あなたはこんな感じかもしれません:

これまでに議論した人気のあるアーキテクチャの一つ、ESPCNをコーディングしましょう。
inputs = keras.Input(shape=(None, None, 1))
conv1 = layers.Conv2D(64, 5, activation="tanh", padding="same")(inputs)
conv2 = layers.Conv2D(32, 3, activation="tanh", padding="same")(conv1)
conv3 = layers.Conv2D((upscale_factor*upscale_factor), 3, activation="sigmoid", padding="same")(conv2)
outputs = tf.nn.depth_to_space(conv3, upscale_factor, data_format='NHWC')
model = Model(inputs=inputs, outputs=outputs)
ご存知の通り、ESPCNは特徴抽出のための畳み込み層と、アップサンプリングのためのサブピクセル畳み込みで構成されています。私たちは、サブピクセル畳み込みを実行するためにTensorFlowのdepth_to_space関数を使用しています。
def gen_dataset(filenames, scale):
    # The model trains on 17x17 patches
    crop_size_lr = 17
    crop_size_hr = 17 * scale

    for p in filenames:
        image_decoded = cv2.imread("Training/DIV2K_train_HR/"+p.decode(), 3).astype(np.float32) / 255.0
        imgYCC = cv2.cvtColor(image_decoded, cv2.COLOR_BGR2YCrCb)
        cropped = imgYCC[0:(imgYCC.shape[0] - (imgYCC.shape[0] % scale)),
                  0:(imgYCC.shape[1] - (imgYCC.shape[1] % scale)), :]
        lr = cv2.resize(cropped, (int(cropped.shape[1] / scale), int(cropped.shape[0] / scale)),
                        interpolation=cv2.INTER_CUBIC)

        hr_y = imgYCC[:, :, 0]
        lr_y = lr[:, :, 0]

        numx = int(lr.shape[0] / crop_size_lr)
        numy = int(lr.shape[1] / crop_size_lr)
        for i in range(0, numx):
            startx = i * crop_size_lr
            endx = (i * crop_size_lr) + crop_size_lr
            startx_hr = i * crop_size_hr
            endx_hr = (i * crop_size_hr) + crop_size_hr
            for j in range(0, numy):
                starty = j * crop_size_lr
                endy = (j * crop_size_lr) + crop_size_lr
                starty_hr = j * crop_size_hr
                endy_hr = (j * crop_size_hr) + crop_size_hr

                crop_lr = lr_y[startx:endx, starty:endy]
                crop_hr = hr_y[startx_hr:endx_hr, starty_hr:endy_hr]

                hr = crop_hr.reshape((crop_size_hr, crop_size_hr, 1))
                lr = crop_lr.reshape((crop_size_lr, crop_size_lr, 1))
                yield lr, hr
私たちはモデルのトレーニングにDIV2Kデータセットを使用します。2k解像度の画像を17×17のパッチに分割して、トレーニングのためにモデル入力として提供します。著者たちはRGB画像をYCrCb形式に変換し、次にYチャンネルの入力をESPCNを使用してアップスケールします。CrおよびCbチャンネルはバイキュービック補間を用いてアップスケールされ、すべてのアップスケールされたチャンネルが一緒に縫い合わされて最終的な高解像度(HR)画像が得られます。このように、トレーニング中は低解像度データのYチャンネルと高解像度画像をモデルに提供する必要があります。
結論
この記事では、スーパー解像度とは何か、その応用、スーパー解像度アルゴリズムの分類、利点と制限について説明しました。次に、開始するための公開されているデータセットや、使用できるさまざまな種類の損失関数とメトリクスを見ていきました。最後に、ESPCNアーキテクチャのコードを見ていきました。
超解像について学び続けたい場合は、研究論文のコレクションとそれに対応するコードへのリンクを含むこのリポジトリをお勧めします。