グラディオを使用して実装された蒸留安定拡散の包括的ガイド

このチュートリアルでは、安定拡散(SD)の蒸留版を深く掘り下げて探ります。このチュートリアルでは、モデルを生き生きとさせるためにGradioを使用することも含まれています。私たちの旅は、安定拡散の知識蒸留版の理解を深め、その重要性を学ぶことから始まります。
さらに、関連する研究論文で説明されているモデルアーキテクチャを分解して説明しようとします。
コードデモに参加することで、モデルの利用に関する実践的な理解を得ることができ、バランスの取れた学習体験に貢献します。また、基盤となるモデルについてさらに学びたい場合は、以前のStable Diffusionに関するブログ投稿もぜひご覧ください。
紹介
SDモデルは、一般的に最も有名なオープンソースモデルの一つですが、特にテキストから画像への生成能力において重要です。SDは卓越した能力を示し、いくつかのテキストから画像への生成アプリケーションにおいて基盤となっています。SDモデルは潜在拡散モデルであり、これらのモデルの拡散操作は意味的に圧縮された空間で行われます。SDモデル内では、U-Netが繰り返しサンプリングを実行し、ランダムに生成された潜在コードから徐々にノイズを除去します。このプロセスは、提供されたテキスト説明やプロンプトに合わせた画像を生成するために協力して動作するテキストエンコーダーと画像デコーダーの両方によってサポートされています。ただし、このプロセスは計算コストが高く、しばしば使用を妨げるという問題があります。この問題に対処するために、多くのアプローチが導入されています。
拡散モデルの研究は、古典的なアーキテクチャを圧縮して、より小さく高速なモデルを実現する可能性を解き放ちました。SDの蒸留版を達成するために実施された研究は、サンプリングステップを減少させ、元のアーキテクチャを変更することなくネットワークの量子化を適用します。このプロセスは、より高い効率を示しています。この蒸留版モデルは、リソース制約がある場合でも有効性を示しています。わずか13 A100日の訓練と小規模なデータセットで、このコンパクトモデルは元の安定拡散モデル(SDM)を効果的に模倣する能力を持つことが証明されました。ゼロからSDMを訓練する際に関連するコストが6,000 A100日を超え、2,000万ペアを含むことを考えると、研究はネットワーク圧縮がコンパクトで多用途な拡散モデルを構築する際に特にコスト効率の良いアプローチとして浮かび上がることを示しています。

ソース
前提条件
機械学習の基礎知識:
特に拡散モデルに関するニューラルネットワークの理解。
潜在空間や画像生成のような概念への親しみ。
ハードウェア要件:
より高速な推論のためのGPU (NVIDIA CUDA対応)を搭載したマシン(例:A100、H100、または少なくともRTX 20xx/30xxシリーズのGPU)。
環境設定:
Jupyter Notebookまたは任意のIDE(例:VS Code、PyCharm)へのアクセス。-
仮想環境(例:
venv、conda)に基本的な慣れを持ち、コンフリクトを避ける。 事前学習済みモデルチェックポイント:
Hugging Face Model Hubのようなプラットフォームから蒸留されたSDモデルのチェックポイントにアクセスする。
蒸留安定拡散とは何ですか?
Stable Diffusionは拡散モデルと呼ばれるディープラーニングモデルに属しています。この大規模なテキストから画像(T2I)拡散モデルは、ノイズの多いランダムデータからノイズを除去することによって動作します。SDモデルは通常、数十億の画像データセットで訓練されており、モデル訓練中に学習した内容から新しいデータを生成するように訓練されています。
拡散の概念は画像にランダムノイズを追加することから始まります。ここでは画像を猫の画像としましょう。徐々に画像にノイズを追加することで、その画像は認識できないほどの非常にぼやけた画像に変わります。これをフォワードディフュージョンと呼びます。

ソース
次に、最も重要な部分である逆拡散が来ます。ここでは、オリジナルの画像がノイズを反復的に除去することで復元されます。逆拡散を行うためには、画像に追加されたノイズの量を理解することが不可欠です。これには、追加されたノイズを予測するための深層ニューラルネットワークモデルのトレーニングが必要であり、これをStable Diffusionではノイズ予測器と呼びます。ノイズ予測器はU-Netモデルの形を取ります。
最初のステップは、ランダムな画像を作成し、その画像内のノイズを予測するノイズ予測器を使用することです。その後、この推定されたノイズを元の画像から引き算し、このプロセスを反復的に繰り返します。数回の反復の後、最終的には猫または犬を表す画像が得られます。

ソース
しかし、このプロセスは効率的ではなく、プロセスを加速するために潜在拡散モデルが導入されました。安定拡散は潜在拡散モデルとして機能します。高次元の画像空間で作業するのではなく、まず画像を潜在空間に圧縮します。この潜在空間は48倍小さく、処理する数が大幅に少なくなるという利点があります。これが、顕著に速いパフォーマンスの理由です。安定拡散は、変分オートエンコーダーまたはVAEニューラルネットワークと呼ばれる技術を使用します。このVAEはエンコーダーとデコーダーの2つの部分から成り立っています。エンコーダーは画像を低次元の画像に圧縮し、デコーダーは画像を復元します。
トレーニング中、モデルはノイズの多い画像を生成する代わりに、潜在空間でテンソルを生成します。画像に直接ノイズを導入するのではなく、Stable Diffusionは潜在空間で潜在ノイズによって画像を破壊します。このアプローチは、より小さな潜在空間で操作することでかなり速いプロセスが得られるため、効率性が選ばれています。
しかし、ここでは画像について話しています。問題は、テキストから画像がどこから来るのかということです。
SDMでは、テキストプロンプトがトークナイザに渡され、プロンプトがトークンや数値に変換されます。トークンは単語を表す数値であり、コンピュータがこれらの単語を理解するために使用されます。これらの各トークンは、その後、埋め込みと呼ばれる768次元のベクトルに変換されます。次に、これらの埋め込みはテキストトランスフォーマーによって処理されます。最終的に、トランスフォーマーからの出力がノイズ予測器U-Netに供給されます。

ソース
SDモデルは潜在空間にランダムテンソルを初期化します。このランダムテンソルは、乱数生成器のシードによって制御できます。このノイズが潜在空間における画像です。ノイズ予測器は、この潜在的なノイズのある画像とプロンプトを入力し、潜在空間のノイズ(4x64x64テンソル)を予測します。
さらに、この隠れノイズは隠れ画像から差し引かれ、新しい隠れ画像が生成されます。これらのステップは繰り返され、サンプリングステップによって調整可能です。次に、デコーダVAEが隠れ画像をピクセル空間に変換し、プロンプトに合った画像を生成します。
全体として、潜在拡散モデルは、確率、生成モデル、および拡散プロセスの要素を組み合わせて、潜在空間から複雑でリアルなデータを生成するための枠組みを作成します。
Stable Diffusionを使用することは、画像を生成するために潜在的なノイズ除去を反復的に行う必要があるため、計算コストが高くなる可能性があります。モデルの複雑さを軽減するために、Nota AIからDistilled Stable Diffusionモデルが導入されました。この蒸留版は、SDMの特定の残差および注意ブロックを削除することでUNetを簡素化し、モデルサイズを51%削減し、CPU/GPUでのレイテンシを43%改善しました。この研究は、より大きな成果を達成しながらも、限られた予算でトレーニングされています。
研究論文で議論されたように、知識蒸留SDMでは、システムの最も計算集約的な部分であるU-Netが簡素化されています。テキストと時間ステップの情報を組み込んだU-Netは、潜在表現を生成するためにデノイジングステップを経ます。U-Netにおけるステップごとの計算はさらに最小化され、より効率的なモデルが得られます。SDM-v1を圧縮することによって得られたモデルのアーキテクチャは、以下の画像に示されています。

元の研究論文からの画像
コードデモ
この記事に記載されているリンクをクリックし、distilled_stable_diffusion.ipynbノートブックに移動します。ノートブックを実行するための手順に従ってください。
必要なライブラリをインストールすることから始めましょう。DSDライブラリに加えて、Gradioもインストールします。
!pip install --quiet git+https://github.com/huggingface/diffusers.git@d420d71398d9c5a8d9a5f95ba2bdb6fe3d8ae31f
!pip install --quiet ipython-autotime
!pip install --quiet transformers==4.34.1 accelerate==0.24.0 safetensors==0.4.0
!pip install --quiet ipyplot
!pip install gradio
%load_ext autotime
次に、パイプラインを構築し、最初の画像を生成して、その生成した画像を保存します。
Import the necessary libraries

from diffusers import StableDiffusionXLPipeline
import torch
import ipyplot
import gradio as gr

pipe = StableDiffusionXLPipeline.from_pretrained("segmind/SSD-1B", torch_dtype=torch.float16, use_safetensors=True, variant="fp16")
pipe.to("cuda")


prompt = "an orange cat staring off with pretty eyes, Striking image, 8K, Desktop background, Immensely sharp."
neg_prompt = "ugly, poorly Rendered face, low resolution, poorly drawn feet, poorly drawn face, out of frame, extra limbs, disfigured, deformed, body out of frame, blurry, bad composition, blurred, watermark, grainy, signature, cut off, mutation"

image = pipe(prompt=prompt, negative_prompt=neg_prompt).images[0]

image.save("test.jpg")

ipyplot.plot_images([image],img_width=400)
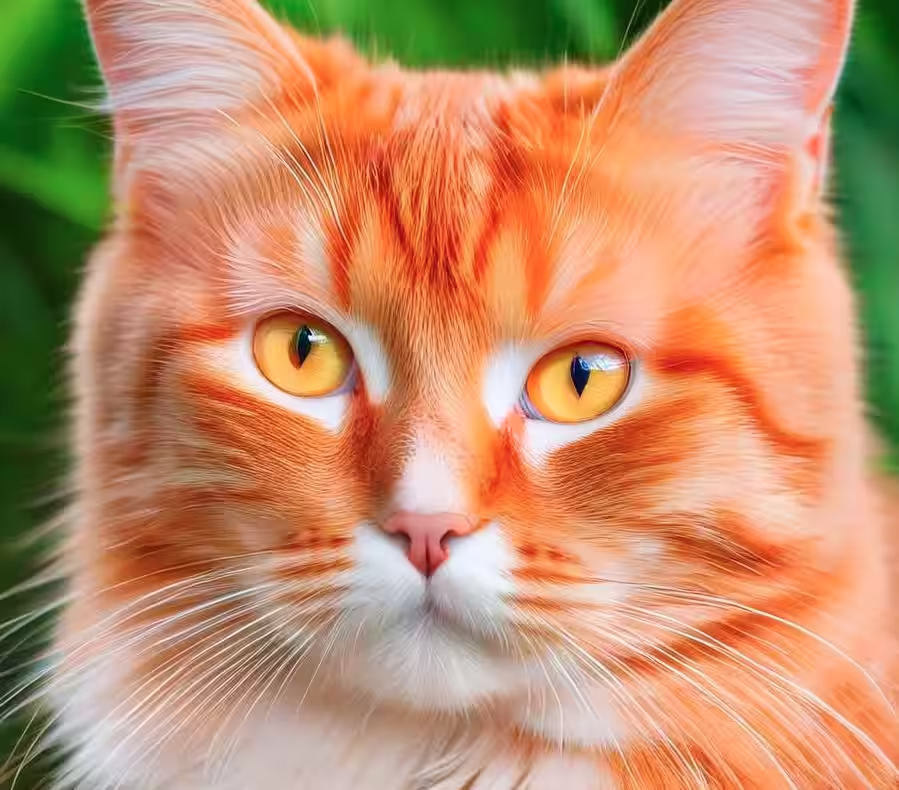
画像結果
上記のコードは、'diffusers'モジュールから‘StableDiffusionXLPipeline’クラスをインポートします。必要なライブラリをインポートした後、‘StableDiffusionXLPipeline’クラスのインスタンスを‘pipe’という名前で作成します。次に、パイプラインに「segmind/SSD-1B」と呼ばれる事前トレーニングされたモデルをロードします。このモデルは、dtype引数で指定した16ビット浮動小数点精度を使用するように設定されており、安全なテンソルが有効になっています。バリアントは「fp16」に設定されています。‘GPU’を使用するため、パイプラインをCUDAデバイスに移動して計算を高速化します。
コードをさらに強化しましょう。これは、画像生成に対するプロンプトに影響を与えるガイダンススケールを調整することによって行われます。この場合、スケールは7.5に設定されています。パラメータ「num_inference_steps」は30に設定されており、この数は画像生成プロセス中に実行されるステップ数を示しています。
allimages = pipe(prompt=prompt, negative_prompt=neg_prompt,guidance_scale=7.5,num_inference_steps=30,num_images_per_prompt=2).images
Gradioを使ってウェブUIを構築する
Gradioは、誰でも使えるように、ユーザーフレンドリーなウェブインターフェースを通じて機械学習モデルを展示する最も迅速な方法を提供します。Gradioを使ってシンプルなUIを構築する方法を学びましょう。
Gradioインターフェイスを構築するために使用する画像を生成する関数を定義します。
def gen_image(text, neg_prompt):
    return pipe(text,
                negative_prompt=neg_prompt,
                guidance_scale=7.5,
                num_inference_steps=30).images[0]
次に、このコードスニペットはGradioライブラリを利用して、gen_imageという関数を使用してAI生成画像を生成するためのシンプルなWebインターフェースを作成します。
txt = gr.Textbox(label="prompt")
txt_2 = gr.Textbox(label="neg_prompt")
2つのテキストボックス(txtとtxt_2)は、gr.Textboxクラスを使用して定義されています。これらのテキストボックスは、ユーザーがテキストデータを入力できる入力フィールドとして機能します。これらのフィールドは、プロンプトとネガティブプロンプトを入力するために使用されます。
#Gradio Interface Configuration
demo = gr.Interface(fn=gen_image, inputs=[txt, txt_2], outputs="image", title="Generate A.I. image using Distill Stable Diffusion😁")
demo.launch(share=True)
- 最初に、インターフェースが入力を受け取ったときに実行される関数として
gen_imageを指定します。 - インターフェースの入力コンポーネントを定義します。これにはプロンプトとネガティブプロンプト用の2つのテキストボックス(
txtとtxt_2)が含まれます。 outputs="image": 画像出力を生成し、インターフェースのタイトルを設定しますtitle="Distill Stable Diffusionを使用してA.I.画像を生成する😁"- この
launchメソッドはGradioインターフェイスを開始するために呼び出されます。share=Trueパラメータは、インターフェイスが共有可能であるべきことを示しており、他の人がアクセスして使用できるようにします。

要約すると、このコードはユーザー入力のための二つのテキストボックスを持つGradioインターフェースを設定し、処理のための関数(gen_image)に接続し、出力が画像であることを指定し、共有のためにインターフェースを起動します。テキストボックスにプロンプトとネガティブプロンプトを入力することで、提供された関数を通じてAI生成画像を生成できます。
SSD-1Bモデル
最近、Segmindはオープンソースの基盤モデルSSD-1Bを発表し、最も早い拡散テキストから画像へのモデルであると主張しています。SSD-1Bは蒸留シリーズの一部として開発され、SDXL 1.0モデルと比較してサイズが50%削減され、速度が60%向上しています。これらの改善にもかかわらず、SDXL 1.0と比べて画像品質の妥協はわずかです。さらに、SSD-1Bモデルは商業ライセンスを取得しており、企業や開発者がこの最先端技術を自社の製品に組み込む機会を提供しています。
このモデルはSDXLの蒸留版であり、より高品質な画像を迅速に生成し、なおかつ手頃な価格で提供できることが証明されています。
NotaAI/bk-sdm-small
Nota AIのSDの別の蒸留版は、T2I生成に非常に一般的です。ブロックを取り除いた知識蒸留安定拡散モデル(BK-SDM)は、効率的な汎用テキストから画像への合成のために設計された、構造的に合理化されたSDMのバージョンを表しています。そのアーキテクチャは、(i) ステーブルディフュージョンv1.4のU-Netから複数の残差ブロックと注意ブロックを取り除くこと、(ii) 完全なトレーニングセットの0.1%未満である0.22M LAIONペアのみを使用して蒸留による事前学習を行うことを含んでいます。トレーニングにおいて非常に制限されたリソースを使用しているにもかかわらず、このコンパクトなモデルは、知識の効果的な移転を通じて元のSDMを模倣する能力を示しています。
蒸留版は本当に速いですか?
さて、問題は、これらのSDの蒸留版は本当に速いのかということであり、確かめる方法は一つだけです。
この評価では、拡散ファミリーに属する4つのモデルを評価します。評価の目的で、segmind/SSD-1B、stabilityai/stable-diffusion-xl-base-1.0、nota-ai/bk-sdm-small、CompVis/stable-diffusion-v1-4を使用します。SSD-1BとSDXLについての詳細な比較分析については、リンクをクリックしてください。
すべてのモデルを読み込み、それらを比較しましょう。
import torch
import time
import ipyplot

from diffusers import StableDiffusionPipeline, StableDiffusionXLPipeline, DiffusionPipeline
以下のコードスニペットでは、Stable Diffusionファミリーから4つの異なる事前学習モデルを使用し、テキストから画像への合成のためのパイプラインを作成します。
#text-to-image synthesis pipeline using the "bk-sdm-small" model from nota-ai
distilled = StableDiffusionPipeline.from_pretrained(
    "nota-ai/bk-sdm-small", torch_dtype=torch.float16, use_safetensors=True,
).to("cuda")

#text-to-image synthesis pipeline using the "stable-diffusion-v1-4" model from CompVis
original = StableDiffusionPipeline.from_pretrained(
    "CompVis/stable-diffusion-v1-4", torch_dtype=torch.float16, use_safetensors=True,
).to("cuda")

#text-to-image synthesis pipeline using the original "stable-diffusion-xl-base-1.0" model from stabilityai
SDXL_Original = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0", torch_dtype=torch.float16,
    use_safetensors=True, variant="fp16"
).to("cuda")

#text-to-image synthesis pipeline using the original "SSD-1B" model from segmind
ssd_1b = StableDiffusionXLPipeline.from_pretrained(
    "segmind/SSD-1B", torch_dtype=torch.float16, use_safetensors=True,
    variant="fp16"
).to("cuda")
モデルが読み込まれ、パイプラインが作成されると、これらのモデルを使用していくつかの画像を生成し、各モデルの推論時間を確認します。ここで注意すべきは、すべてのモデルパイプラインを単一のセルに含めるべきではないということです。そうしないと、メモリの問題に直面する可能性があります。
モデル
推論時間
stabilityai/stable-diffusion-xl-base-1.0
82212.8 ミリ秒
segmind/SSD-1B
59382.0 ミリ秒
CompVis/安定した拡散v1-4
15356.6 ミリ秒
nota-ai/bk-sdm-small
10027.1 ミリ秒
bk-sdm-smallモデルは最も少ない推論時間を要し、さらにモデルは高品質の画像を生成することができました。
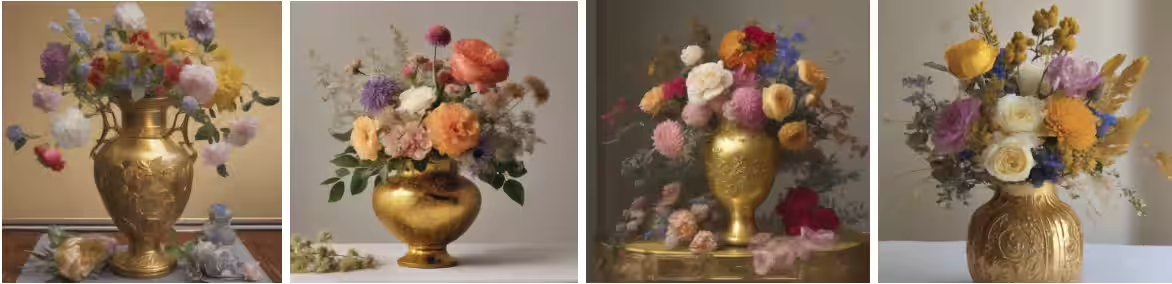
stabilityai/stable-diffusion-xl-base-1.0

segmind/SSD-1B

CompVis/安定した拡散-v1-4

nota-ai/bk-sdm-small
結論としての考え
この記事では、Stable Diffusionモデルの簡潔な概要を提供し、Distilled Stable Diffusionの概念を探求しました。Stable Diffusion(SD)は、シンプルなプロンプトを通じて新しい画像を生成するための強力な技術として登場します。さらに、SDファミリー内の4つのモデルを検討し、bk-sdm-smallモデルが最も短い推論時間を示したことを強調しました。これは、KDモデルが元のモデルと比べてどれほど効率的であるかを示しています。
蒸留モデルには特定の限界があることを認識することも重要です。第一に、完璧なフォトリアリズムには達しておらず、読みやすいテキストのレンダリングは現在の能力を超えています。さらに、構成理解を必要とする複雑なタスクに直面すると、モデルの性能が低下する可能性があります。また、顔や一般的な人間の表現が正確に生成されない場合もあります。このモデルのトレーニングデータは主に英語のキャプションで構成されているため、他の言語に適用する際には効果が低下することがあることにも注意が必要です。
さらに、ここで言及しておくべきことは、ここで使用されているモデルは、動揺を引き起こすような、苦痛を与えるような、または攻撃的な画像を生成するために使用されるべきではないということです。これらの高性能なモデルを蒸留することの主な利点の一つは、高品質の画像を生成しながら、計算要件を大幅に削減できることです。
参考文献
- 安定した拡散
- SSD 1Bによる推論 — 50%小型化され、60%高速化された蒸留型Stable Diffusion XLモデル
- SSD-1Bの発表: 効率的なT2I生成への飛躍
- ステーブルディフュージョンパイプライン
- 蒸留された安定拡散推論
- nota-ai/bk-sdm-small
- stabilityai/stable-diffusion-xl-base-1.0
- BK-SDM: ステーブルディフュージョンの軽量で高速かつ安価なバージョン