YOLOv10: 高度なリアルタイムエンドツーエンドオブジェクト検出

紹介
リアルタイムの物体検出は、自律走行車や監視システムから拡張現実やロボティクスに至るまで、現代のさまざまなアプリケーションで利用されています。リアルタイムの物体検出の本質は、画像やビデオフレーム内の複数の物体を瞬時に正確に特定し、分類することにあります。
これまでの年月の間に、リアルタイム物体検出の効率と精度を向上させるための多くのアルゴリズムが開発されてきました。「You Only Look Once」(YOLO)シリーズは、その速度と性能から注目されるアプローチとして登場しました。YOLOアルゴリズムは、物体検出を単一の回帰問題として定式化することで革命をもたらし、完全な画像からバウンディングボックスとクラス確率を一度の評価で直接予測します。この効率的なアプローチは、YOLOをリアルタイム検出機能の代名詞にしました。
研究者たちは最近、リアルタイム検出のためのCNNベースの物体検出器に注目しており、YOLOモデルは性能と効率のバランスから人気を集めています。YOLO検出パイプラインにはモデルの前方処理と非最大抑制(NMS)後処理が含まれていますが、両者には限界があり、精度と遅延のトレードオフが最適でない結果をもたらします。
このYOLOシリーズの最近の追加はYOLOv10-N/S/M/B/L/Xであり、前のバージョンを基にしています。YOLOv10は、さまざまな環境における検出精度、速度、および頑健性を向上させるための高度な技術を統合しています。YOLOv10の強化により、即時かつ信頼性の高い物体認識を必要とするアプリケーションにとって強力なツールとなり、リアルタイム検出で達成可能な限界を押し広げています。実験により、YOLOv10はさまざまなモデルスケールにおける計算と精度のトレードオフにおいて、以前の最先端モデルを大幅に上回ることが示されています。
前提条件
- 深層学習の概念に関する基本的な理解。
- CNN(畳み込みニューラルネットワーク)に関する知識。
- PythonおよびPyTorch/TensorFlowの経験。
- トレーニングのためのGPU設定(例:NVIDIA CUDA環境)。
- 物体検出の原則(例:バウンディングボックス、IoU)に関する知識。
YOLOv10とは何ですか?
YOLOモデルは通常、トレーニング中に一対多のラベル割り当て戦略を使用します。これは、1つの真のオブジェクトが複数の正例サンプルに対応することを意味します。この戦略は性能を向上させますが、推論中に最良の予測を選択するために非最大抑制(NMS)が必要であり、これが推論を遅くし、性能をNMSのハイパーパラメータに敏感にします。これにより、YOLOモデルは最適なエンドツーエンドのデプロイメントを達成することがさらに妨げられます。
YOLOv10研究論文で議論されたように、1つの可能な解決策は、リアルタイムアプリケーションのための効率的なエンコーダとクエリ選択技術を導入したRT-DETRのようなエンドツーエンドDETRアーキテクチャを採用することです。しかし、DETRの複雑さは精度と速度のバランスを妨げる可能性があります。もう一つのアプローチは、冗長な予測を減らすために1対1の割り当て戦略を使用してCNNベースの検出器のエンドツーエンド検出を探ることですが、これらはしばしば推論のオーバーヘッドを追加したり、パフォーマンスが低下したりします。
研究者たちは、特徴抽出と融合を強化するために、さまざまなバックボーンユニット(DarkNet、CSPNet、EfficientRep、ELAN)およびネックコンポーネント(PAN、BiC、GD、RepGFPN)を実験してきました。さらに、モデルスケーリングや再パラメータ化手法も調査されています。これらの努力にもかかわらず、YOLOモデルは依然として計算の冗長性と非効率性に直面しており、精度向上の余地があります。
最近の研究論文は、ポストプロセッシングとモデルアーキテクチャを改善することでこれらの課題に対処しています。NMS(非最大抑制)を必要とせず、推論中のNMSを排除する一貫した二重アサインメント戦略を提案し、効率を向上させます。また、研究には、軽量な分類ヘッド、空間・チャネルのデカプルダウンサンプリング、および冗長性を削減するためのランクガイドブロック設計を組み込んだ効率と精度主導のモデル設計戦略も含まれています。精度の面では、大規模カーネル畳み込みや効果的な部分自己注意モジュールを探求しています。YOLOV10は、二重ラベルアサインメントと一貫したマッチングメトリックを使用してYOLOモデルのためのNMSフリートレーニング戦略を導入し、高い効率と競争力のある性能を達成するのに役立ちます。
YOLOv10の進展
YOLOv10 (N/S/M/B/L/X) は、COCO ベンチマークでのパフォーマンス向上を成功させました。特に、YOLOv10-S と X は、RT-DETR-R18 および R101 よりも高速でありつつ、類似のパフォーマンスを発揮します。YOLOv10-B は、YOLOv9-C と比較してレイテンシを46%削減し、同じパフォーマンスを維持します。YOLOv10-L と X は、より少ないパラメータで YOLOv8-L と X を上回っており、YOLOv10-M は、より少ないパラメータで YOLOv9-M/MS のパフォーマンスに匹敵します。
YOLOv10モデルの6つのサイズ:

YOLOv10の6つの異なるサイズ(出典)
一貫した二重割り当てを伴うNMSなしのトレーニングは、YOLOv10-Sのエンドツーエンドのレイテンシを4.63ms削減し、44.3%の平均適合率(AP)を維持しながら強力なパフォーマンスを発揮します。
- 効率重視のモデル設計により、1180万パラメータと20.8ギガ浮動小数点演算(GFLOPs)を削減し、YOLOv10-Mのレイテンシーを0.65ms減少させています。
- 精度重視のモデル設計は、YOLOv10-SでAPを1.8、YOLOv10-Mで0.7向上させ、遅延の増加はそれぞれわずか0.18msと0.17msにとどまり、その効果を証明しています。
YOLOv10におけるデュアルラベルアサインメントとは何ですか?
YOLOモデルにおける一対一のマッチングは、各グラウンドトゥルースに単一の予測を割り当てるため、NMS後処理の必要がなくなりますが、監視の強度が低下し、精度も下がります。この問題に対処するために、1対多と1対1の戦略を組み合わせた二重ラベル割り当てが使用されます。1対1のヘッドが追加され、構造と最適化が1対多の分岐と同一であり、トレーニング中に共同で最適化されます。
これにより、モデルは多対一の割り当てに関する豊富な監視を活用でき、効率的でエンドツーエンドの推論のために一対一のヘッドを使用します。一対一のマッチングはトップワン選択を使用し、ハンガリー法の性能を少ないトレーニング時間で実現します。
一貫したマッチングメトリックとは何ですか?
予測をグラウンドトゥルースのインスタンスに割り当てる際、1対1および1対多のアプローチは、予測がインスタンスとどれだけ一致しているかを測定するためのメトリックを使用します。このメトリックは、分類スコア、バウンディングボックスのオーバーラップ(IoU)、および予測のアンカーポイントがインスタンス内にあるかどうかを組み合わせています。
一貫したマッチング指標は、1対1および1対多のマッチングプロセスの両方を改善し、両方のブランチが同じ目標に最適化されることを確実にします。この二重アプローチは、1対多のブランチからより豊かな監視信号を得ながら、1対1のブランチから効率的な推論を維持することを可能にします。
メトリックフォーミュラ
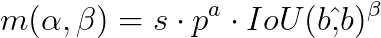
- ( p ) は分類スコアです
- (ベータとベータハット)は予測された境界ボックスと真実の境界ボックスです
- ( s ) は空間事前情報です
- (アルファ)と(ベータ)は、分類とローカリゼーションのバランスを取るためのハイパーパラメータです。
一対一のパラメータを一対多のパラメータに比例させることによって
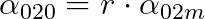
そして
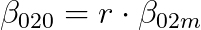
マッチングメトリックは、両方のブランチを整列させて同じ最良のポジティブサンプルを特定します。この整列は、監視ギャップを減らし、パフォーマンスを向上させるのに役立ちます。
この一貫したマッチングメトリックは、1対1ブランチによって選択された予測が1対多ブランチの上位予測と高度に一致することを保証し、より効果的な最適化をもたらします。したがって、このメトリックは改善された監視とより良いモデルパフォーマンスを示しています。
モデルアーキテクチャ
YOLOv10は、以下のコンポーネントで構成されており、これらはモデル設計の重要な要素であり、効率と精度を達成するのに役立ちます。

YOLOv10モデルデザインは公式YOLOv10論文からのものです。
- 軽量分類ヘッド: 軽量分類ヘッドアーキテクチャは、2つの深層分離可能な畳み込み(3×3)に続いて1×1の畳み込みを含みます。これにより計算の需要が減少し、モデルがより迅速かつ効率的になり、特にリアルタイムアプリケーションやリソースが限られたデバイスへの配置において有益です。
- 空間チャネル分離ダウンサンプリング: YOLOモデルでは、ダウンサンプリング(画像のサイズを減少させ、チャンネル数を増加させること)は通常、ストライド2の3×3標準畳み込みを使用して行われます。このプロセスは計算コストが高く、多くのパラメーターが必要です。
このプロセスをより効率的にするために、空間チャネルデカップリングダウンサンプリングが提案され、2つのステップが含まれています。
1.ポイントワイズ畳み込み: このステップは、画像サイズを変更せずにチャンネルの数を調整します。2.深さ方向畳み込み: このステップは、計算量やパラメータの数を大幅に増加させることなく、画像サイズを縮小(ダウンサンプリング)します。
これらの操作をデカップリングすることにより、計算コストと必要なパラメータの数が大幅に削減されます。このアプローチは、ダウンサンプリング中により多くの情報を保持し、低遅延でより良いパフォーマンスを実現します。
- ランクガイド付きブロック設計: ランクガイド付きブロック配分戦略は、パフォーマンスを維持しつつ効率を最適化します。ステージは固有のランクによってソートされ、最も冗長なステージの基本ブロックはCIBに置き換えられます。このプロセスは、パフォーマンスの低下が検出されるまで続けられます。この適応アプローチは、さまざまなステージとモデルスケールにわたる効率的なブロック設計を保証し、パフォーマンスを損なうことなくより高い効率を達成します。さらなるアルゴリズムの詳細は付録に記載されています。
- 大カーネル畳み込み: このアプローチは、より深い段階で選択的に大カーネルの深さ優先畳み込みを活用し、シャローな特徴の汚染や遅延の増加の問題を回避しつつ、モデルの能力を向上させます。構造的再パラメータ化の使用により、推論効率に影響を与えることなく、トレーニング中の最適化が改善されます。さらに、大カーネル畳み込みはモデルのサイズに基づいて調整され、パフォーマンスと効率が最適化されます。
- 部分自己注意(PSA):部分自己注意(PSA)モジュールは、YOLOモデルに自己注意を効率的に統合します。特徴マップの一部分にのみ自己注意を選択的に適用し、注意メカニズムを最適化することにより、PSAは最小限の計算コストでモデルのグローバルな表現学習を強化します。このアプローチにより、完全な自己注意メカニズムに典型的な過剰なオーバーヘッドを避けつつ、パフォーマンスが向上します。
SOTAモデルとの比較
YOLOv10は、さまざまなモデルスケールにおいて、最先端のパフォーマンスとエンドツーエンドのレイテンシを成功裏に達成しています。ベースラインのYOLOv8モデルと比較して、YOLOv10は平均精度(AP)と効率を大幅に向上させています。具体的には、YOLOv10のバリアント(N/S/M/L/X)は、1.2%から1.4%のAP向上を実現しており、28%から57%のパラメータ削減、23%から38%の計算削減、37%から70%のレイテンシ低下を達成しています。
他のYOLOモデルと比較すると、YOLOv10は精度と計算コストの間で優れたトレードオフを示しています。YOLOv10-NおよびSは、それぞれYOLOv6-3.0-NおよびSを1.5および2.0 AP上回り、パラメータと計算量は大幅に少なくなっています。YOLOv10-BおよびMは、性能を維持または改善しながら、YOLOv9-CおよびYOLO-MSと比較して遅延をそれぞれ46%および62%削減しています。YOLOv10-LはGold-YOLO-Lを68%少ないパラメータ、32%低い遅延、1.4%のAP改善で上回っています。
さらに、YOLOv10は性能とレイテンシの両面でRT-DETRを大幅に上回っています。YOLOv10-SとXは、性能が類似しているにもかかわらず、それぞれRT-DETR-R18とR101よりも1.8倍および1.3倍速いです。
これらの結果は、YOLOv10がリアルタイムのエンドツーエンドデテクターとしての優位性を強調しており、異なるモデルスケールにおいて最先端のパフォーマンスと効率を示しています。この効果は、オリジナルの一対多トレーニングアプローチを使用することでさらに検証され、私たちのアーキテクチャ設計の影響が確認されます。

モデル比較

レイテンシと精度(左)およびサイズと精度(右)のトレードオフに関する他のモデルとの比較。(ソース)
デモ
YOLOv10を実行するために、まずリポジトリをクローンし、必要なパッケージをインストールします。
!pip install -q git+https://github.com/THU-MIG/yolov10.git
現在、YOLOv10には独自のPyPIパッケージがありません。したがって、ソースからコードをインストールする必要があります。
しかし、始める前に、私たちが使用しているGPUを確認しましょう。
!nvidia-smi

次に、必要なライブラリをインストールします。
!pip install -r requirements.txt
!pip install -e .
これらのインストールは、モデルが正しく機能するために必要なすべてのツールとライブラリを持っていることを保証するために必要です。
!wget https://github.com/THU-MIG/yolov10/releases/download/v1.1/yolov10s.pt
このコマンドを実行すると、wgetは提供されたURLにアクセスし、YOLOv10小モデルの事前訓練済み重みyolov10s.ptをダウンロードして、現在のディレクトリに保存します。
完了したら、urlを生成するためにapp.pyファイルを実行します。
python app.py
ゼロ時
/0:18
1×
YOLOv10を使用した物体検出タスク
画像に関する推論
YOLOv10は、さまざまなサイズのCOCOデータセットで事前トレーニングされたウェイトファイルを提供します。まず、ウェイトをダウンロードします。
!mkdir -p {HOME}/weights
!wget -P {HOME}/weights -q https://github.com/THU-MIG/yolov10/releases/download/v1.1/yolov10n.pt
!wget -P {HOME}/weights -q https://github.com/THU-MIG/yolov10/releases/download/v1.1/yolov10s.pt
!wget -P {HOME}/weights -q https://github.com/THU-MIG/yolov10/releases/download/v1.1/yolov10m.pt
!wget -P {HOME}/weights -q https://github.com/THU-MIG/yolov10/releases/download/v1.1/yolov10b.pt
!wget -P {HOME}/weights -q https://github.com/THU-MIG/yolov10/releases/download/v1.1/yolov10x.pt
!wget -P {HOME}/weights -q https://github.com/THU-MIG/yolov10/releases/download/v1.1/yolov10l.pt
!ls -lh {HOME}/weights
次のコード行は、YOLOモデルを使用して入力画像dog.jpegを処理し、モデルの学習に基づいてその中のオブジェクトを検出し、検出されたオブジェクトが強調表示された出力画像を保存します。結果は指定されたディレクトリに保存されます。
%cd {HOME}

!yolo task=detect mode=predict conf=0.25 save=True \
model={HOME}/weights/yolov10n.pt \
source={HOME}/data/dog.jpeg

import cv2
import supervision as sv
from ultralytics import YOLOv10

model = YOLOv10(f'{HOME}/weights/yolov10n.pt')
image = cv2.imread(f'{HOME}/data/dog.jpeg')
results = model(image)[0]
detections = sv.Detections.from_ultralytics(results)

bounding_box_annotator = sv.BoundingBoxAnnotator()
label_annotator = sv.LabelAnnotator()

annotated_image = bounding_box_annotator.annotate(
    scene=image, detections=detections)
annotated_image = label_annotator.annotate(
    scene=annotated_image, detections=detections)

sv.plot_image(annotated_image)

0: 640x384 1人、1匹の犬、8.3ms スピード: 1.8ms 前処理、8.3ms 推論、0.9ms 後処理、形状 (1, 3, 640, 384) の画像あたり
このセルは、YOLOv10モデルを使用して入力画像に推論を実行し、結果を処理して検出を抽出し、監視ライブラリを使用してバウンディングボックスとラベルで画像に注釈を付けて結果を表示します。
結論
このブログでは、YOLOシリーズの新しいメンバーであるYOLOv10について議論しました。YOLOv10は、物体検出のためのYOLOの後処理とモデルアーキテクチャの両方の進歩に適応しています。主なアプローチには、一貫した二重割り当てによるNMSフリーのトレーニングが含まれており、より効率的な検出が実現されています。これらの改善により、YOLOv10は、パフォーマンスとレイテンシの両方で他の先進的な検出器を上回るリアルタイム物体検出器となっています。
この記事を楽しんでいただけたことを願っています!私たちのブログのパート2にご注目ください。そこでYOLOv10と他のYOLOモデルを比較します。
参考文献
- オリジナルの研究論文
- Githubリポジトリ