生成AIにおけるマルチモーダル学習の利用方法

紹介
AIのトレンドは、生成AIの革新とその複数のモダリティで操作する能力を通じて、人工知能の風景を変貌させています。生成AIの進化は、テキスト、画像、ビデオ、音声コンテンツを生成する方法を変えました。以前のAIシステムは、特定のタスクを実行し、単一のモダリティ(ユニモーダルAI)内で動作していました。例えば、テキストベースのモデルは書かれたコンテンツのみを生成し、画像モデルは視覚要素のみを生成します。マルチモーダル生成AIの開発は重要な進展を示しており、AIシステムが複数のデータモダリティにわたって情報を処理できるようになります。
私たちの記事では、生成AIにおけるマルチモーダリティを探り、その基本原理と実際の応用について論じます。OpenAIのGPT-4、Google DeepMindのGemini、MetaのImageBindなどの人気のあるマルチモーダルAIモデルを比較し、業界の重要な課題にも取り組みます。
前提条件
- 生成AIモデルがさまざまなデータタイプでどのように機能するかを理解するための機械学習(ML)と深層学習のメカニズムに対する理解。
- テキストから画像、テキストからテキスト、テキストから音声への生成モデルであるGPT、DALL-E、Stable Diffusionについての徹底的な理解は、コンテンツ生成のための強固な基盤を築きます。
- 単一モーダルAIと多モーダルAIの確固たる理解は、生成AIシステムにおけるデータ融合およびクロスモーダル学習技術の機能についての重要な洞察を提供します。
マルチモーダル生成AIとは何を指しますか?
マルチモーダル生成AIとは、複数のデータモダリティからコンテンツを処理し、生成する人工知能システムを指します。AIにおいて「モダリティ」は、テキスト、画像や動画などの視覚コンテンツ、音声ファイル、スマートデバイスからのデータなど、さまざまなデータ形式を表します。

従来のAIと生成AIを比較するには、AI対GenAIに関する私たちの記事をご覧ください。
マルチモーダルAIは、複数の入力タイプを通じてより豊かな結果を生成するために、クロスモーダル学習を使用します。マルチモーダル生成AIシステムを考えてみましょう。このシステムは、シーンの説明を読み、対応する画像を分析して、新しいコンテンツ(音声ナレーションや詳細な画像など)を生成します。これは、両方のモダリティからのデータを統合することで達成されます。情報の融合により、AIは深い理解を発展させ、現実の複雑さを正確に反映した応答を生成します。
マルチモーダルAI vs. ジェネレーティブAI
研究者は、実践において頻繁に重なるにもかかわらず、マルチモーダルAIと生成AIの違いを理解する必要があります。
- 生成的AI: 生成的AIは、新しいコンテンツを生成する人工知能システムを開発します。これには、DALL-EやStable Diffusionのようなツールからの視覚的出力が含まれます。また、テキスト、音声、ビデオなどのメディア形式も生成できます。
- マルチモーダルAI:マルチモーダルAIは、さまざまなデータタイプを統合し、それを処理します。最近の生成的AIに関する多くの進展は、マルチモーダルアプローチから生まれていますが、すべてのマルチモーダルAIシステムが生成モデルとして機能するわけではありません。生成的AIのマルチモーダルモデルは、異なるデータソースを組み合わせて、創造的かつ複雑な結果を生成することで、これらの概念を統合しています。
マルチモーダルAIと生成AIは、二つのアプローチの対立ではなく、統一されたシステムを作り出すために協力します。さまざまなモダリティからの複数のデータ入力を組み合わせることで、生成モデルの創造性と信頼性が高まり、多様で豊かなデータソースが供給されます。
マルチモーダルAIはどのように機能するのか?
マルチモーダルAIは、統一された計算フレームワークを通じてさまざまなデータタイプを処理し統合する能力に基本的に依存しています。このプロセスには、データ処理、クロスモデルの整合、データ融合、およびデコーディングが必要です。

データ処理
マルチモーダルAIの核心はデータ処理に依存しています。これには、複数のモダリティからの生データを変換する専門的な前処理手法が含まれます。
例えば、テキストデータは前処理中にトークン化が必要ですが、画像データは視覚的特徴を抽出するために畳み込みニューラルネットワークを活用します。AIモデルのための音声データの変換には、AIモデルへの入力として使用される前にスペクトログラムに変換することが含まれます。
クロスモーダルアライメント
モデルは、抽出した特徴を正確に整合させる必要があります。クロスモーダル学習手法を通じて、モデルは多様なデータタイプ間に意味のある関連を作り出す方法を学ぶことができます。例えば、テキストベースの説明は、画像認識システムがオブジェクトをより正確に識別するのに役立ちます。逆に、画像はテキスト生成を改善する文脈を提供することができます(例:オブジェクトの色を指定する)。
この相互作用は、モデルがクロスアテンションを実行することを必要とし、これはモデルのアーキテクチャの異なる部分が各モダリティの関連する側面に焦点を合わせることを可能にするメカニズムです。例えば、「赤い球」を説明しているテキストトークンが、画像内の赤い球体オブジェクトを表す対応する視覚特徴と整合することがあります。
データ融合
データ融合のプロセスは、同期された特徴を一つの統一された表現に結合することを含みます。融合層は、特定のタスクに関連する各モダリティから最も重要な詳細を特定するため、重要な役割を果たします。いくつかの融合技術があります。
- 初期融合: 初期段階で生の特徴を統合することで、モデルは組み合わせたデータから直接学習できるようになります。
- レイトフュージョン: 各モダリティを個別に処理し、その出力を組み合わせる。
- ハイブリッドフュージョン: ハイブリッドフュージョンは、複数のネットワーク段階を通じて各モダリティの部分的な表現を組み合わせ、早期および後期のフュージョン要素を統合します。
デコーディング/生成
デコーダー段階は、トランスフォーマーまたは再帰型ニューラルネットワークを使用して、統一された表現を生成タスクのターゲット出力に変換します。モデルの構造によっては、結果として得られる出力はテキスト、画像、またはさまざまな他の形式として現れることがあります。このシステムは、その統合されたマルチモーダル知識を使用して新しいコンテンツを生成します。
生成AIの例におけるマルチモーダルの使い方
テキスト、画像、音声、およびその他の要素がどのように効果的に統合されるかを示すいくつかのマルチモーダル生成AIの例を検討します。

拡散モデルを用いたテキストから画像への生成
プロセス: ユーザーは「月明かりに照らされた静かな湖」のような説明的なテキストプロンプトを提出します。
- 結果: モデルは、テキストの説明と視覚的特徴を関連付ける方法を学習したため、それに対応する画像を生成します。
- アプリケーション: これにはデジタルアート、マーケティングキャンペーン、コンセプトデザイン作業が含まれます。
音声視覚的物語生成
- テキストとビデオの統合: ユーザーがテキスト入力を通じてシーンを描写すると、AIシステムは適切な音声効果を伴うアニメーションビデオを生成します。
一般的なパイプライン:
- テキストエンコーダー: シーンの説明をエンベディングに変換します。
- ビデオジェネレーター: ビデオ生成プロセスには、フレームを生成するためにGANまたは拡散モデルが必要です。
- 音声合成:対応する音声を生成する。
スピーチ・トゥ・イメージモデル
- 説明: これらのモデルは、感情的な手がかりを含むことがある音声入力を受け取り、画像を生成します。
- 技術的アプローチ: システムは、対応する画像を生成するために使用される音声の文字起こしまたは意味的埋め込みへの変換から始まります。
- 課題: これは、堅牢な音声認識能力と高度なクロスモーダルアライメントを必要とします。
文脈に基づく提案を伴うリアルタイム字幕
- ライブイベント: AIシステムは、ライブスピーチを聞いてテキストキャプションを作成し、画面に表示します。また、カメラを通じて観客の反応を監視し、字幕の詳細とスタイルを調整します。
- 影響: この方法は、動的かつ文脈に応じたキャプションを通じて、ユーザーのアクセシビリティと関与を向上させます。
画像キャプショニングと感情分析
- マルチモーダル入力: 視覚的な表現は、イベントを説明するテキストや音声と組み合わされています。
- 結果: 生成された説明は、物体や個人の詳細な特定とその感情状態を提供します。
- ユーティリティ: ソーシャルメディア、写真共有アプリケーション、またはボディカメラからの映像を分析するための法執行機関において有用です。
これらの例は、生成型AIにおけるマルチモーダルの使用が、コンテンツ開発とユーザーエンゲージメントの可能性を大幅に広げる方法を強調しています。複数のデータストリームを統合したAI駆動のソリューションを使用することで、組織や個人は、より革新的で文脈に即した出力を生成することができます。
マルチモーダルAIアーキテクチャ
堅牢なマルチモーダルAIシステムの開発は、エンコーダーデコーダーフレームワーク、注意メカニズム、およびトレーニング目標によってサポートされています。

エンコーダーデコーダーフレームワーク
マルチモーダルディープラーニングは、頻繁にトランスフォーマーに基づくエンコーダーデコーダーフレームワークを主要な方法として使用します。そのようなシステムでは:
- エンコーダ: モダリティ(テキスト、画像、音声など)は専門のエンコーダによって処理されます。
- マルチモーダルフュージョン: これらの専門的なエンコーダーからの出力は、共通の埋め込み空間に投影され、交差注意層がモダリティの整合性を学習することを可能にします。
- デコーダー: デコーダーは、融合されたマルチモーダル表現を最終出力に変換します。それはテキスト、画像、または他の形式かもしれません。
注意メカニズム
効果的なマルチモーダルシステムは、さまざまなモダリティ間で最も関連性の高いコンポーネントにモデルが集中できるように、注意機構を必要とします。例えば、モデルは画像のテキスト説明を生成する際に、特定の単語に一致する画像の特定の領域に集中することができます。
トレーニング目標
マルチモーダルモデルの一般的なトレーニング目標には次のようなものがあります:
- 対照学習: この訓練目標の目的は、同一のインスタンスからの異なるモダリティの表現が類似性に向かって収束することです。
- 生成損失: テキスト、画像、またはその他のコンテンツを生成するには、クロスエントロピーなどの損失関数を最小化する必要があります。
- 再構築損失: オートエンコーダーのようなシステムは、再構築学習プロセスを通じて欠落したモダリティを復元するモデルを訓練します。
次のコードを考えてみましょう:
import torch
import torch.nn as nn
import torch.nn.functional as F

class Mult_Mod_Att_Fus(nn.Module):
    def __init__(self, txt_dim, img_dim, aud_dim, fus_dim, num_heads=4):
        super(Mult_Mod_Att_Fus, self).__init__()

        # We performed the linear projections to a share fusion dimension
        self.txt_fc = nn.Linear(txt_dim, fus_dim)
        self.img_fc = nn.Linear(img_dim, fus_dim)
        self.aud_fc = nn.Linear(aud_dim, fus_dim)

        # Multi-head Self-Attention for Fusion
        self.attn = nn.MultiheadAttention(embed_dim=fus_dim, num_heads=num_heads, batch_first=True)

        # This is our final MLP for learned fusion
        self.fusion_fc = nn.Linear(fus_dim, fus_dim)

    def forward(self, txt_feat, img_feat, aud_feat):
        # Fusion dimension through projection of each modalitity
        proj_txt = self.txt_fc(txt_feat)  # (batch, seq_len, fus_dim)
        proj_img = self.img_fc(img_feat)
        proj_aud = self.aud_fc(aud_feat)

        # We  Stack modalities into sequence
        fus_inp = torch.stack([proj_txt, proj_img, proj_aud], dim=1)

        # Here we can apply Multi-Head Attention for feature alignment
        attn_out, _ = self.attn(fus_inp, fus_inp, fus_inp)

        # Pass through fusion MLP for final feature aggregation
        fused_rep = self.fusion_fc(attn_out.mean(dim=1))

        return fused_rep

Example Usage:
txt_feat = torch.randn(3, 255)
img_feat = torch.randn(3, 33)
aud_feat = torch.randn(3, 17)

encoder = Mult_Mod_Att_Fus(txt_dim=255, img_dim=33, aud_dim=17, fus_dim=128, num_heads=4)
fused_rep = encoder(txt_feat, img_feat, aud_feat)

print("Fused representation shape:", fused_rep.shape)  # Expected: (3, 128)
PyTorchモデルは、自己注意を通じてテキスト、画像、音声データを組み合わせてマルチモーダル融合を実現します。このモデルは、それぞれのモダリティを共有の融合空間に投影するために異なる線形層を使用します。変換された特徴は一緒に積み重ねられ、単一の統合された入力テンソルが得られます。マルチヘッド自己注意を通じて、このモデルはさまざまなモダリティが動的に相互作用し合い、お互いに影響を与えることを可能にします。
全結合層は、整列した特徴出力を次元が(バッチサイズ、融合次元)の融合表現に変換します。この使用例では、モデルはテキストの255次元、画像の33次元、音声の17次元のランダムな入力テンソルを受け取り、各バッチサンプルの128次元の融合表現を生成します。
マルチモーダルAIの応用
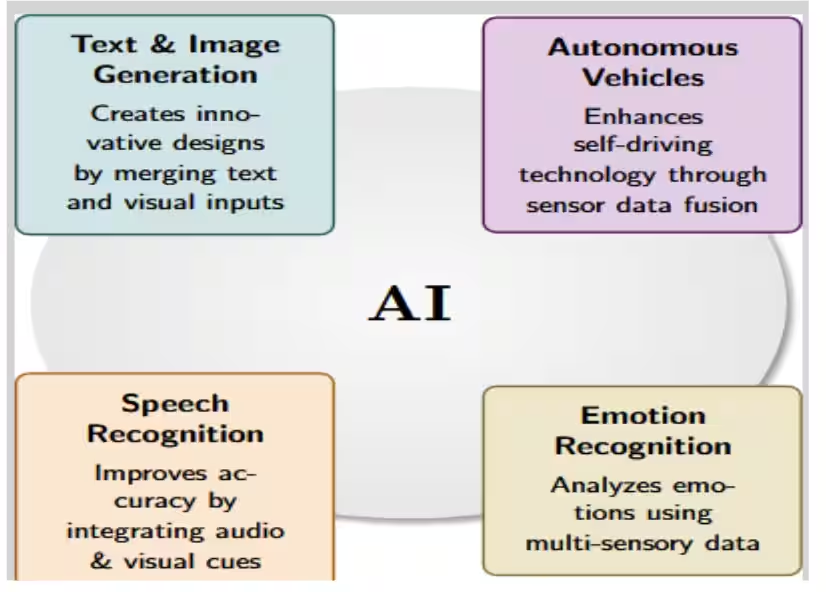
異なるモダリティを組み合わせることで、多モーダルAIシステムは人間のような文脈の認識を持ってタスクを実行することができます。これにより、自律型車両、音声認識、感情分析、テキストおよび画像合成のための生成AIアプリケーションなど、現実世界での使用に効果的になります。
自律走行車
自動運転車の利用は、マルチモーダルAIが実際のアプリケーションでいかに効果的に機能するかを示しています。自律走行車の動作は、カメラの画像、LiDARの点群、レーダー信号、GPS情報など、数多くのセンサーからのデータ入力に依存しています。異なるセンサーストリームからのデータ融合により、車両は周囲を正確に認識することができます。生成AIは、歩行者が歩道から出てくるなどの未来の出来事を予測することで、自律走行車の技術を改善することができます。
音声認識
従来の音声認識モデルは、話された音声信号を文字に変換します。マルチモーダルAIは、口の動きの読み取りやテキストメタデータなどのコンテキストを追加することで、従来の音声認識を強化できます。
もし音声データと口の動きを読む技術が騒がしい環境で使用されると、はるかに良い結果が得られます。これは、マルチモーダルAIが実際の応用でどのように機能するかを示す例となります。さらに、マルチモーダル生成AIモデルは、関連する要約テキストや図表や図などの視覚的表現を統合した箇条書きを生成しながら、音声を文字起こしすることができます。
感情認識
人間の感情を理解するためには、顔の表情(視覚)、声のトーン(音声)、およびテキストコンテンツ(存在する場合)における微妙な信号を観察する必要があります。堅牢な感情認識は、複数の信号を組み合わせたマルチモーダルAIシステムから生まれます。ビデオ会議アプリケーションは、ユーザーが混乱や無関心の兆候を示しているかどうかを特定し、それによってプレゼンターが特定のトピックを明確にするように促すことがあります。
テキストと画像生成のためのAIモデル
テキストから画像への生成には、テキストと視覚的なプロンプトの両方を統合するモデルが含まれます。あなたのデザインの部分的なスケッチと、希望する外観を説明する書かれた説明があると考えてみましょう。
異なるモダリティからの入力を融合することによって、マルチモーダルAIシステムは高品質なデザインの代替案を生み出すことができます。これは、ファッション、インテリアデザイン、広告分野での創造的なギャップを埋めるのに役立ちます。
視覚データと共に全体の知識グラフや大規模なテキストコーパスを統合することにより、文脈が豊かで基盤のしっかりした出力を生成することができます。AIシステムは、数千の建物画像を分析しながら完全な建築書を読み取り、革新的なデザインを生み出すことができます。
主要なマルチモーダル生成AIモデルの比較
GPT-4、Gemini、画像結合は、各自が独自の機能と強みを持つ先進的なマルチモーダル生成AIモデルです。
GPT-4 オープンAIは、テキストと画像データを処理できる大規模言語モデルである GPT-4 を導入しました。ここにその主な特徴があります:
マルチモーダル処理: テキストと画像の入力sをサポートしています(GPT-4 Turbo)。GPT-4は音声および動画処理のためのネイティブ機能が欠けています。さらに、画像理解はテキストの能力に比べて限られています。
パフォーマンス: テキスト生成、数学的問題解決、および複雑な推論において卓越した能力を示します。
コンテキストウィンドウ: GPT-4 Turboモデルは、テキストベースの人工知能システムの中で最大級の128Kトークンの大規模なコンテキストウィンドウを提供します。Google DeepMind Gemini 2.0
Gemini 2.0は、Google DeepMindによって作成されたマルチモーダルAIモデルであり、複数のデータタイプを扱う能力によって際立っています。多機能なマルチモーダル機能:テキスト、音声、ビデオ、画像、コードをサポートしています。
Google統合: このサービスは、効率的な知識アクセスのためにGoogle検索、Docs、YouTube、その他のプラットフォームとの直接統合を提供します...
AIベンチマーキング: ジェミニ 2.0は、マルチモーダル理解、深層学習、研究主導のアプリケーションにおいて優れたパフォーマンスで知られるトップティアのAIモデルに属しています。
MetaのImageBind
Meta AIによって開発されたImageBindは、さまざまなデータタイプを理解し、接続するために設計されたモデルです。このモデルは、画像、テキスト情報、音声信号、深度読み取り、サーマル画像、IMUデータの6つのデータモダリティを処理します。ImageBindは、異なるデータ形式のための共有表現を確立し、異なるモダリティ間でのスムーズな相互作用を可能にします。
さまざまなAIアプリケーションに取り組む開発者や研究者にとって役立ちます:
- クロスモーダル検索: クロスモーダル検索機能により、ユーザーはテキストによる説明を使用して画像を見つけたり、視覚コンテンツからテキストを抽出したりできます。
- 埋め込み算術: 複数のソースからのデータを統合して、より複雑な概念の表現を作成できます。
こちらが要約された 比較表 です:
| 機能 | GPT-4(OpenAI) | ジェミニ 2.0 (グーグル ディープマインド) | ImageBind(Meta AI) |
|---|---|---|---|
| 主要な強み | 高度なテキスト生成、推論、コーディング、そして限られた画像処理 | テキスト、画像、音声、動画、コードをネイティブにサポートするフルマルチモーダルAI | 6つのデータタイプにわたるクロスモーダル学習とセンサーフュージョン |
| マルチモーダル能力 | テキストと画像(GPT-4 Turboは基本的な画像理解ができますが、ネイティブの動画や音声サポートはありません) | テキスト、画像、音声、動画、コード(真のマルチモーダル処理) | 画像、テキスト、音声、深度、サーマル、及びIMU(動作センサー) |
| 特別な機能 | 強い言語推論、コーディングタスク、および問題解決 | 高度なマルチモーダル理解とクロスモーダル推論 | 埋め込みベースの学習とクロスモーダル検索 |
| 最適な使用例 | チャットボット、ビジネス自動化、コーディングアシスタント、テキストベースの研究 | マルチモーダルAIアプリケーション、研究、マルチメディア処理、およびインタラクティブなAIタスク | ロボティクス、AR/VR、自律システム、センサー駆動のAI |
| 独自の利点 | テキストが多い論理的思考、執筆、コーディングのタスクに優れている | テキスト、画像、音声、そして動画にわたるシームレスなマルチモーダルAI | 優れたセンサー融合とマルチモーダルデータバインディング |
| 理想的な対象 | 開発者、企業、NLPおよびコーディングにおける研究 | AI研究者、インタラクティブなマルチモーダルアプリケーション、リアルタイムAI | 自律システム、ロボティクス、自動運転車、AR/VRアプリケーション |
ユーザーは、この表を参照することで、自分のニーズに最も適したAIシステムを特定できます。この表は、各モデルの基本的な強みと能力、理想的な使用例を示しています。
生成モデルの背後にある原則を深く探求するために、私たちの生成AIに関する入門ガイドは貴重な情報で満載です。
マルチモーダルトレーニングにおける課題
マルチモーダル生成AIの可能性は immense ですが、広範な採用を妨げるいくつかの課題が未だに存在します。
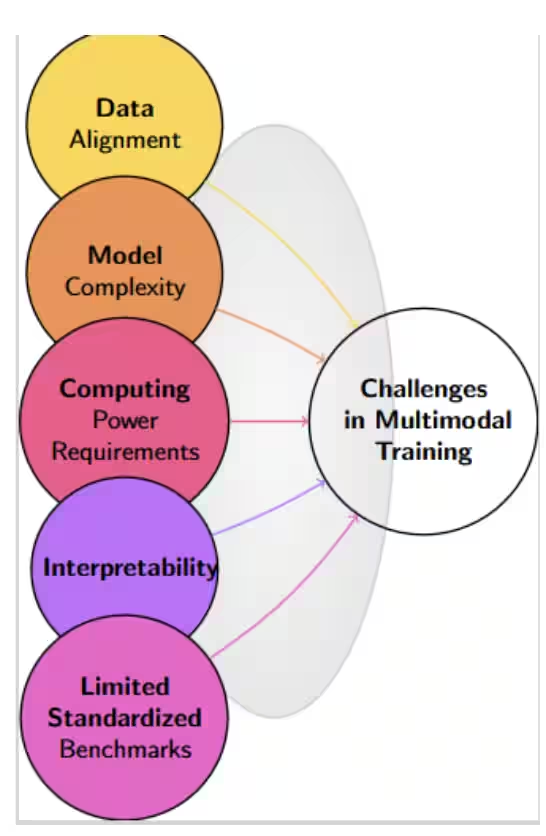
- データ整合性: マルチモーダルデータセットは、テキストがそれぞれの画像や音声クリップに対応することを確実にするために、慎重なキュレーションと整合が必要です。不適切なデータ整合性は、トレーニングの一貫性の欠如と信頼性のないパフォーマンス結果をもたらします。
- モデルの複雑性:マルチモーダルAIアーキテクチャは、単一モダリティモデルよりも多くのパラメータを必要とします。これによりGPUリソースの要求が増加し、トレーニング時間が延長されます。
- 計算力要件: 大規模なマルチモーダルモデルを訓練する際の費用は、この技術を大きな財政資源と研究所を持つ組織にのみ利用可能にしています。
- 解釈可能性: マルチモーダルシステムの意思決定プロセスを理解することは、ユニモーダルモデルを分析するよりも複雑です。各モダリティの入力を追跡する必要があるため、モデルの動作を解釈することがずっと難しくなります。
- 限られた標準化ベンチマーク: テキストおよびビジョンタスクのためのベンチマークは利用可能ですが、包括的なマルチモーダルAIアプリケーションはまだ新しいものです。これにより、モデルを一貫して比較することが難しくなります。
この業界は、既存の課題に対処するために、より強力なデータキュレーションパイプラインや、効率的なモデルアーキテクチャ(スパーストランスフォーマーや専門家の混合など)を開発し、改善されたアライメント戦略を取り入れています。これらの課題に適切に対処することは、マルチモーダル深層学習の進展にとって重要です。
マルチモーダルAIの未来
マルチモーダルAIの未来は非常に有望であり、その改善につながる複数の道があります。
- リアルタイムアプリケーション:ハードウェアアクセラレーターの改善により、マルチモーダルAIシステムがライブ(拡張現実)AR/VR(仮想現実)体験やビデオ会議翻訳などのリアルタイム環境に展開されるようになります。
- パーソナライズされたコンテキスト対応型AI: テキストメッセージやソーシャルメディアのフィード、音声コマンドなどのパーソナライズデータソースから学習の洞察を得るAIモデルは、非常にカスタマイズされたユーザー体験を可能にします。しかし、これには厳格なプライバシーとセキュリティ対策が必要です。
- 倫理とバイアスの軽減:モデルが複数のデータタイプを取り入れるにつれ、バイアスのある不適切な出力の可能性が高まります。今後の研究では、バイアスの検出と解釈可能性を優先します。
- ロボットとの統合: ロボットが視覚情報や音声言語を処理する能力は、環境に適応することを可能にします。これは、医療、物流、農業などの分野を変革するでしょう。
- 継続的および生涯学習: 生成AIのマルチモーダルモデルにとっての新たな課題は、以前の情報を保持しながら知識ベースを継続的に更新し、新しいタイプのデータに即座に適応する能力です。
今後数年で、マルチモーダルAIが製品やサービスの不可欠な部分になる世界を目にすることになるでしょう。これにより、技術的なインタラクションが強化され、機械の能力が広がります。
FAQセクション
生成AIにおける多モーダル学習とは何ですか?
生成AIの多モーダル学習アプローチは、複数のデータタイプを活用して新しいコンテンツを理解し生成するためのモデルを訓練します。多モーダルシステムは、テキストのみの単一のモダリティに依存するのではなく、複数の情報源からの情報を組み合わせることで、より豊かな出力を生成します。
マルチモーダルAIはどのように生成モデルを改善するのですか?
マルチモーダルAIにおけるさまざまなデータタイプの組み合わせは、生成モデルに追加のコンテクストを提供し、あいまいさを最小限に抑えながら全体的な品質を向上させるのに役立ちます。追加のテキストメタデータや音声ヒントは、テキストから画像を生成するモデルがより正確な画像を生成できるようにします。
マルチモーダル生成AIの例は何ですか?
マルチモーダル生成AIには、視覚データからテキストを生成する画像キャプショニングシステム、テキストから画像を生成するモデル(DALL-EやMidjourneyなど)、音声コマンドやテキストクエリに応答する仮想アシスタントが含まれます。高度なモデルは、現在、動画コンテンツ、3Dグラフィックス、および触覚フィードバックデータを処理できるようになっています。
マルチモーダルAIは画像とテキストをどのように処理しますか?
マルチモーダルモデルは、CNNまたはトランスフォーマーベースの視覚ネットワークを使用して画像特徴を抽出し、言語モデルを使用してテキスト埋め込みを生成します。このモデルは、注意メカニズムを通じて視覚的要素がテキストトークンとどのように関連しているかを理解するために、視覚的特徴とテキスト的特徴を統合します。
マルチモーダルAIはリアルタイムアプリケーションで使用できるか?
ハードウェアとアルゴリズムの改善により、リアルタイムのマルチモーダルAIアプリケーションがますます実用的になっています。
例えば、ライブビデオ会議ツールは、テキストや画像を音声データと組み合わせて、即時の結果を提供します。
結論
AIは急速に進化しており、マルチモーダル生成AIがこの変革の分野で道を開いています。高度なマルチモーダルAIアーキテクチャは、データ融合とクロスモーダル学習と組み合わされることで、これらのモデルが複数のモーダリティにわたって複雑なデータを処理し生成することを可能にします。
応用範囲は、自動運転車から顔の感情検出、音声認識、さらにはテキストと画像を生成する複雑なAIシステムにまで及びます。
マルチモーダルAIの未来は有望に見えます。なぜなら、進行中の研究と実用的な実装が、既存の課題にもかかわらず限界を押し広げ続けているからです。トレーニング手法の進展、アーキテクチャの最適化、倫理的課題の解決を通じて、私たちは現実世界でより創造的な応用の出現を目にすることになるでしょう。
役立つリソース
- マルチモーダル大規模言語モデルに関する調査
- LLMはマルチモーダル生成と編集に出会う: 調査
- マルチモーダルAIとは何ですか?