Scikit-Learnによるロジスティック回帰の習得:完全ガイド

紹介
機械学習は、基本的な分類手法の一つとしてロジスティック回帰に大きく依存しています。「回帰」という用語がその名前に含まれているのは歴史的な背景によるものですが、ロジスティック回帰は主に分類目的で使用されます。このScikit-learnのロジスティック回帰チュートリアルでは、ロジスティック回帰の理論とPythonでの実装について詳細に説明し、Scikit-learnのパラメータやハイパーパラメータのチューニング手法についても詳しく解説しています。
これは、ロジスティック回帰がバイナリ分類とマルチクラスの問題をどのように簡単にするかを示しています。
このガイドの最後には、データセットとともにPythonのロジスティック回帰コードを使用するための強力な知識基盤を構築します。また、結果の解釈方法やモデルのパフォーマンスを向上させる方法も学びます。
前提条件
- 分類の基本概念、教師あり学習、モデル評価指標(精度、適合率、再現率)を理解する。
- NumPy、Pandas、Scikit-learnなどのライブラリを通じて、データ操作やモデル訓練にPythonを使用する能力。
- 線形代数の概念、基本的な確率論、統計を理解することは、ロジスティック回帰の数学的定式化を把握するための基礎を提供します。
- ロジスティック回帰はモデルのパフォーマンスを最適化するためにコスト関数を最小化するため、勾配降下法と損失関数の基本的な理解が必要です。
Scikit-learnの理解と機械学習におけるその役割
Scikit-learnは広く使われているオープンソースのPythonライブラリであり、機械学習タスクにとって不可欠なツールです。NumPy、SciPy、およびMatplotlibに基づくシンプルで強力なデータ分析およびマイニングツールを提供しています。そのAPIドキュメントとアルゴリズムは、機械学習エンジニアやデータサイエンティストにとって欠かせないリソースとなっています。
Scikit-learnは、最小限のコーディングで機械学習モデルを構築するための完全なパッケージとして説明できます。これらのモデルには、線形回帰、決定木、サポートベクターマシン、ロジスティック回帰などが含まれます。
このライブラリは、データ前処理、特徴量エンジニアリング、モデル選択、ハイパーパラメータの調整のためのツールを提供します。このPython Scikit-learnチュートリアルは、Scikit-learnの入門を提供します。
ロジスティック回帰の数学的基礎
ロジスティック回帰の背後にある数学を理解することは、単純な線形モデルがどのように拡張され、二項分類タスクを扱うための強力なツールになるのかを理解する手助けになります。
次のセクションでは、シグモイド関数、オッズ、ロジオッズの解釈、そしてロジスティック回帰の学習プロセスを規制するコスト関数などの概念を探ります。
シグモイド関数
シグモイド関数はロジスティック回帰の核心です。この関数は任意の実数を取り、0と1の間の値にマッピングします。これは数学的に次のように表現できます:
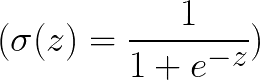
どこで、

σ(z)は常に0と1の間の値を返すため(入力zに関係なく)、入力特徴の線形結合を確率に変換します。これにより、ロジスティック回帰は入力を2つのクラスのいずれかに分類できます。
モデル解釈:オッズとログオッズ
ロジスティック回帰は、出力確率(これをpと呼びましょう)をオッズと対数オッズの観点から見ます。
- オッズは、ある出来事が発生する確率と発生しない確率の比率に過ぎません。

- オッズの自然対数を取ると、ログオッズ(またはロジット)が得られ、線形方程式を形成することができます。

- (ベータ)o(The Intercept)は、すべての予測因子(xi)がゼロに設定されているときの対数オッズを表します。
- (beta)n(特徴nの係数)は、他の変数を一定に保ちながら、予測変数xnを1単位増加させたときに、対数オッズがどれだけ変化するかを表します。
オッズはログオッズの指数変換と考えることができます:
- オッズが1より大きいとき、そのイベントが発生する可能性が高くなります。
- 1未満のオッズは、そのイベントが発生する可能性が低いことを示しています。
乳がん予測におけるロジスティック回帰係数の解釈:平均半径とオッズ比
以下のコードでは、Scikit-learnの乳がんデータセットを用いてロジスティック回帰モデルを訓練し、平均半径の特徴の係数を解釈しました。次に、腫瘍が悪性と分類される確率に対する平均半径の1単位の増加の効果を測定するためにオッズ比を計算しました。
from sklearn.datasets import load_breast_cancer
from sklearn.linear_model import LogisticRegression
import numpy as np

dataset = load_breast_cancer()
X, y = dataset.data, dataset.target

model = LogisticRegression().fit(X, y)

Let's consider the first feature: mean radius
coef = model.coef_[0][0]
oddsratio = np.exp(coef)

print(f"Coeff for mean radius: {coef:.2f}")
print(f"Odds ratio for mean radius: {oddsratio:.2f}")

#Coeff for mean radius: 1.33
#Odds ratio for mean radius: 3.77
結果は、平均半径係数が1.33であることを示しています。これは、平均半径が1単位増加するごとに、悪性である確率が1.33倍になることを意味します。
3.77のオッズ比(係数の指数)は、平均半径が1単位増加すると、悪性の確率がほぼ3倍、具体的には約3.77倍になることを示しています。
これらの位置は、モデルにおける主要な予測変数としての半径を意味します。これらの値を分析することは、特徴の重要性を分析しながら、医療専門家が情報に基づいた医療決定を下すのに役立ちます。
ロジスティック回帰の重要な洞察
- 出力を0と1の間に保ち、確率分類タスクに最適です。
- それは、確率を直接見るのではなく、予測因子と事象の対数オッズとの関係を捉えます。
- 係数を指数化することによって、さまざまな特徴が事象の発生確率にどのように影響するかをよりよく理解できる。
コスト関数(ログ損失)
線形回帰が平均二乗誤差を最小化することに焦点を当てるのとは異なり、ロジスティック回帰は独自のトレーニング方法を持っています。それはコスト関数(対数損失またはバイナリ交差エントロピー)を最小化することを目指します。この関数は、モデルの予測確率がクラスラベルとどれだけ正確に一致しているかを評価します。正確な予測は高い信頼度で報酬され、不正確な予測は罰されます。対数損失は次のように定義されます:

どこ :
- m は、私たちが扱っているトレーニングサンプルの数を表しています。
- yiは、i番目のサンプルに対する真のラベルを表し、0または1になる可能性があります。
- yiは、その同じサンプルに対するポジティブクラスの予測確率を指します。
この損失関数は、自信を持っているが間違った予測にペナルティを与え、モデルが適切にキャリブレーションされた確率推定を提供するように促します。勾配降下法のような最適化技術を使用して対数損失を最小化することで、データに最も適合するパラメータβが得られます。
ロジスティック回帰と線形回帰
一見すると、ロジスティック回帰は線形回帰と非常に似ているように思えるかもしれませんが、目的は異なります。
- 線形回帰は、住宅価格や株式市場のトレンドのような連続値を予測します。これは、入力特徴の線形結合を用いて実数を出力することで実現します。
- ロジスティック回帰は、メールがスパムであるかどうかなどの離散的な結果を予測します。単に実数を出力するのではなく、まず対数オッズを計算し、その後ロジスティック関数を使用して、その結果を0と1の間の確率に変換します。
Pythonによる重回帰分析に関するガイドをチェックして、回帰技術についてさらに学んでください。このチュートリアルでは、Pythonでの重回帰分析の実装に焦点を当て、データ前処理、評価指標、性能の最適化などの重要なトピックを扱います。
ロジスティック回帰 Scikit-learn の例 (二項分類)
以下のPythonロジスティック回帰の例は、Scikit-learnに組み込まれた標準リソースである乳がんウィスコンシンデータセットを使用しています。
from sklearn.datasets import load_breast_cancer
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

dataset loading
dataset = load_breast_cancer()
X, y = dataset.data, dataset.target

Split into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=40
)

Logistic Regression model initialization
model = LogisticRegression(
    penalty='l2',
    C=2.0,
    solver='liblinear',
    max_iter=1000
)

model training
model.fit(X_train, y_train)

prédictions
y_pred = model.predict(X_test)

model evaluation
accuracy = accuracy_score(y_test, y_pred)

print("Accuracy:", accuracy)
上記のスクリプトは、Scikit-learnを使用したシンプルな機械学習パイプラインを表示しています。
- ライブラリをインポートし、乳がんデータセットを読み込んでいます。
- データを特徴とラベルに分割する。
- 私たちはそれをトレーニングセットとテストセットに分け、いくつかの設定(L2 ペナルティ、C=2.0、ソルバーとして「liblinear」を使用し、反復回数を1000に制限)を設定したロジスティック回帰モデルを設定します。
- モデルを訓練した後、テストデータに対していくつかの予測を行います。
- 最後に、モデルがどれだけうまく機能しているかを確認するために、精度スコアを計算して、未確認データをどれだけ効果的に分類するかを見ます。
不均衡データセットを扱う際には、精度、再現率、F1スコアなどの高度な評価指標の使用を検討すべきです。これらの評価指標を探求するには、ディープラーニングメトリクスに関するガイドを参照してください。これらの指標はディープラーニング用に説明されていますが、その説明はロジスティック回帰にも適用できます。
実世界のプロジェクトでは、欠損値の処理やスケーリングなどのタスクに頻繁に遭遇します。Pythonでのデータの正規化を理解するためには、scikit-learnを使用したPythonにおけるデータの正規化に関する記事をご覧ください。
Scikit-learnのロジスティック回帰のパラメータとソルバー
Scikit-learnのLogisticRegressionを使用する場合、正しいパラメータを知っていることがモデルのパフォーマンスに違いをもたらします。以下の表には、重要なscikit-learnのロジスティック回帰のパラメータと、使用できるさまざまなソルバーが表示されています。
| パラメーター | 説明 |
|---|---|
| ペナルティ | 正則化に使用するノルムの種類を定義します。オプションにはL1、L2、エラスティックネット、およびなしが含まれます。L1はスパース性を促進し、L2は係数を安定させます。 |
| C | これは正則化強度の逆数を示します。小さい値は正則化を強化し(より単純なモデル)、大きい値はそれを減少させます(より複雑なモデル)。デフォルトは1.0です。 |
| ソルバー | 最適化に使用されるアルゴリズム。一般的なソルバー:liblinear: L1/L2ペナルティをサポート。lbfgs: Scikit-learnのデフォルトソルバー。sag(確率的平均勾配)& saga(確率的平均勾配拡張): 確率的勾配降下法の変種。 |
| 最大反復回数 | 収束の最大反復回数を設定します。モデルが収束に苦しんでいるときは、これを増やすと役立ちます。 |
| 切片を適合させる | これはモデルが切片を計算するかどうかを決定します。これを偽に設定すると、切片が0に強制されますが、一般的には真に設定することをお勧めします。 |
これらのパラメータを理解することで、データセットや特定のニーズに合わせてロジスティック回帰モデルをカスタマイズするのに役立ちます。
ペナルティタイプ: 適切な正則化アプローチの選択
Scikit-learnは3つの正則化手法を提供しています:L1(Lasso)、L2(Ridge)、およびElasticNet:
- L1 正則化は、一部の係数をゼロに設定することでスパースモデルを作成します。これにより、高次元データを持つデータセットにおける特徴選択タスクに適しています。
- L2正則化は係数をゼロに近づけるが、除去することはなく、これにより安定性が向上し、効果的な多重共線性の管理が可能になる。
- Elastic Netは、相関のある特徴が存在する場合に特徴選択と係数の安定性を達成するために、l1_ratioパラメータを通じて
および 正則化を統合します。
適切なペナルティの選択は、目的に合わせて調整する必要があります:より良い解釈可能性と特徴選択能力のために L1 を使用し、より安定した予測のために L2 を使用し、両方の特徴が必要な場合にはエラスティックネットを使用します。
ソルバー選択: 異なるシナリオの最適化アルゴリズム
ソルバーパラメータは、ロジスティック回帰に対する最大尤度推定を計算する最適化アルゴリズムを決定します。さまざまなソルバーは、異なるペナルティタイプへの適合性や、異なるデータセットサイズの処理において独自のパフォーマンスプロファイルを示しながら、異なる計算特性を示します。
liblinearソルバー
liblinearは古いバージョンのscikit-learnでデフォルトのソルバーであり、今でも小規模なデータセットに対して効率的に動作します。このソルバーはL1およびL2正則化を可能にします。二項分類で動作し、多クラスの問題に対しては一対他の戦略を使用できます。
使用例:
from sklearn.linear_model import LogisticRegression
liblinear_m = LogisticRegression(solver='liblinear', penalty='l1', C=1.0)
lbfgs ソルバー Scikit-learn は、デフォルトのソルバーとして制限付きメモリ ブロイデン-フレッチャー-ゴールドファーブ-シャノ (L-BFGS) アルゴリズムを使用します。L-BFGS 最適化アルゴリズムは、準ニュートン法のファミリーに属します。逆ヘッセ行列を推定することにより、最適なパラメーターを効率的に見つけることができます。
使用例:
lbfgs_model = LogisticRegression(solver='lbfgs', penalty='l2', C=1.0)
多クラスの問題において、標準多項式損失関数は、L2 正則化と組み合わせた場合、lbfgs ソルバーから利益を得ます。このソルバーは、他のアルゴリズムと比較して、プロセスをより少ない反復で完了することができますが、非常に大きなデータセットに対してはメモリを多く消費する可能性があります。
サガソルバー
SAGAアルゴリズムは、大規模データにおいて特にエラスティックネット正則化を使用すると優れた性能を発揮します。このソルバーはL1およびL2正則化において効率的に動作します。しかし、必要とされる計算資源は問題の複雑さに応じて異なる場合があります。使用例:
saga_model = LogisticRegression(solver='saga', penalty='elasticnet', l1_ratio=0.5, C=1.0)
要約
以下の表はソルバーの比較を示しています:
| ソルバー | 正則化がサポートされています | 最適な使用例 | 制限 |
|---|---|---|---|
| リブリニア | L1、L2 | スパースデータ; 小さなデータセットに適しています。 | 密なデータやスケーリングされていないデータセットには非効率的であり、大きなC値に対して苦労する可能性があります。 |
| LBFGS | L2 | 中規模から大規模のデータセット、特に密度の高いもの。 | 非常に大きなデータに対してメモリを大量に消費します |
| サガ | L1、L2、エラスティックネット | 大規模または高次元の問題 | パフォーマンスは適切なスケーリングに依存します; 一部のケースではリソースを多く消費します |
ソルバー選定のためのヒント
- liblinearは、特に小さなデータセットを扱う場合に、スパースデータやバイナリ分類タスクに選択してください。
- 中規模のデータセット、特に密なデータセットには、デフォルトのソルバーとしてlbfgsを選択してください。
- sagaを使用するのは、大規模な問題に直面しているときや、弾性ネット正則化が必要なときです。
Scikit-learnの他のソルバー
- sag: 同様にスケーリングされた特徴を持つ大規模データセットは、このソルバーでうまく機能します。このソルバーは、L2 正則化のみをサポートしています。最良の結果を得るには、最適な収束のために特徴のスケーリングを適用することが推奨されます。
- ニュートン共役勾配法(newton-cg):これは、多項損失関数をサポートするため、多クラス分類問題に使用できます。ただし、lbfgsよりも遅くなる可能性があります。
- ニュートン-コレスキー: これは、高度に構造化された問題のために設計された最適化されたバリアントのニュートン-CGを表します。
データセットのサイズと正則化の要件に合ったソルバーを選ぶことで、効率的かつ正確なロジスティック回帰モデルのトレーニングを実現できます。
ロジスティック回帰のハイパーパラメータチューニング
ハイパーパラメータの調整、例えば正則化の強さを制御するCや、適切なペナルティおよびソルバーを選択することは、パフォーマンスに大きな影響を与えることがあります。
ハイパーパラメータチューニングの技術
ハイパーパラメータ調整のためのいくつかの手法を考えてみましょう。例えば、グリッドサーチ、ランダムサーチ、そしてグリッドサーチです。
- グリッドサーチ:グリッドサーチは、さまざまなパラメータを設定し、最適な組み合わせを見つけるために徹底的に探索するのに役立ちます。実装は非常に簡単ですが、グリッドやデータセットが大きい場合、より多くの計算能力が必要になることがあります。
- ランダム化検索: ランダム化検索は、選択した範囲内のパラメータの組み合わせをランダムにサンプリングします。これにより、グリッド検索よりも迅速に良好な解を見つけることができる場合が多いです。RandomizedSearchCVを使用して実装できます。
- ベイズ最適化:この方法は、目的関数の確率モデルを構築し、以前の結果に基づいて評価する新しいハイパーパラメータの値を選択する、より高度なアプローチを取ります。
Scikit-learnにおけるグリッドサーチの実装
例えば、次のコードを考えます。
from sklearn.model_selection import GridSearchCV
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.datasets import load_breast_cancer

dataset loading
dataset = load_breast_cancer()

X, y = dataset.data, dataset.target

Split into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=40
)

Parameter grid to explore
param_grid = {
    'C': [0.01, 0.1, 1, 10, 100],
    'penalty': ['l2'],
    'solver': ['lbfgs', 'saga']
}

log_r = LogisticRegression(max_iter=400)
grid_s = GridSearchCV(
    estimator=log_r,
    param_grid=param_grid,
    cv=5,
    scoring='accuracy',
    n_jobs=-1
)

grid_s.fit(X_train, y_train)
print("Best Parameters:", grid_s.best_params_)
print("Best Score:", grid_s.best_score_)
上記のスクリプトは、乳がんデータセットをインポートし、それをトレーニングセットとテストセットに分割してから、GridSearchCVを使用してロジスティック回帰モデルのハイパーパラメータを調整します。このプロセスでは、C の異なる正則化パラメータの値を、lbfgs および saga ソルバーを使用して L2 ペナルティでテストします。この構成により、モデルは最大400回の反復を行うことができます。
次の警告が表示されることがあります:「ConvergenceWarning: lbfgsが収束しませんでした。」これは、いくつかのパラメータの組み合わせを使用して、lbfgsソルバーが割り当てられたイテレーション制限内で収束に失敗することを示します。この問題を解決するには、max_iterを増やすか、ソルバーとC値を調整してください。
さらに、パラメーターグリッドを構築する際に異なるパラメーターがどのように機能するかを理解する必要があります。すべてのソルバーがすべてのペナルティタイプをサポートしているわけではなく、penalty='elasticnet'とsolver='lbfgs'のような組み合わせはエラーを引き起こすことがあります。
Cパラメータ:ファインチューニングの正則化強度
Cが小さい場合(例えば0.001のように)、モデルは訓練データに完璧に適合しようとするのではなく、シンプルさを優先します。これによりオーバーフィッティングを抑えることができますが、アンダーフィッティングを引き起こす可能性もあります。一方、Cがかなり大きい場合(例えば100のように)、モデルは訓練誤差を減らすことを目指し、これによりオーバーフィッティングが発生する可能性がありますが、データのより複雑なパターンを捉えることができます。
Cの調整に系統的にアプローチするには次のことが含まれます:
- 対数スケール(0.001、0.01、0.1、1、10、100、1000)での探索から始めましょう。
- パフォーマンスがピークに達する範囲を見つけます。
- 特定された最適範囲内で、より詳細な検索を行ってください。
特徴数、サンプルサイズ、ノイズレベルなどのデータセットの特性は、最適なC値に重大な影響を与えます。大きなノイズを持つデータセットは、より強い正則化を必要とし、これはより低いC値を使用することで達成できます。
ハイパーパラメータチューニングの実用的なヒント
この表は、ロジスティック回帰を使用した GridSearchCV の適用に関する簡単なヒントを提供します。これらのヒントは、ハイパーパラメータ調整の結果を改善し、モデルのパフォーマンスを向上させるのに役立ちます。
| ヒント | 説明 |
|---|---|
| 小さなC範囲と単純なペナルティを使用する | 小さな値のセットから始めてください。例えば、Cとして0.01、0.1、1、10などを使用し、最初のテストをシンプルに保つために「l1」や「l2」のようなペナルティを使用してください。 |
| 適切なソルバーを選択してください | 選択するソルバーがデータセットとペナルティに適合していることを確認してください。たとえば、‘liblinear’はL1とL2で動作しますが、大きなデータセットでは遅くなる可能性があります。一方、‘lbfgs’、‘saga’、および‘newton-cg’は、より大きなデータを処理するのに適しています。 |
| 収束警告の処理 | ソルバーが収束しないという警告が表示された場合は、max_iter を増やすか、ソルバーと C の値を調整してください。 |
| 機能を標準化する | ロジスティック回帰は特徴量の大きさに敏感であるため、パイプラインで標準化(例えば、StandardScaler)を適用して、最適化アルゴリズムの収束を効率的に助ける必要があります。 |
| 適切なCVフォルダーを選択する | データセットのサイズに応じて、5分割交差検証または10分割交差検証を使用してください。一般に、フォルドを増やすことでハイパーパラメータの推定精度が向上し、オーバーフィッティングのリスクが減少します。 |
| 不均衡データの処理 | データが不均衡な場合は、class_weight='balancedを設定するか、少数クラスのパフォーマンスを向上させるためにカスタムウェイトを定義することを検討してください。 |
| 複数の指標を使用する | 精度にのみ依存しないようにしましょう。特に不均衡なデータセットを扱う際には、GridSearchCVのスコアリング機能を使用して、F1、精度、または再現率などの他のメトリックを追跡してください。 |
| 学習曲線を確認する | 最適なパラメータを見つけた後は、モデルが一般化されており、あまり単純すぎず複雑すぎないことを確認するために、学習曲線や検証曲線をチェックしてください。 |
Scikit-Learnにおける多クラスロジスティック回帰
ロジスティック回帰は主に二項結果のために設計されていますが、Scikit-learnは2つの主要なアプローチを通じてマルチクラスシナリオに適用する方法を提供しています:
- 一対その他 (OvR)
- 多項ロジスティック回帰
一対全て(OvR)戦略
One-vs-Rest(OvR)手法は、nクラスのシナリオをn個の個別の二項分類問題に変換します。
仕組み:
- 各クラスごとに異なる分類器が訓練されています。
- 各分類器は、一つのクラス(陽性)を他のすべて(陰性)から分離することを学びます。
- 予測を行う際、すべての分類器がサンプルを評価し、最も高い信頼度スコアを持つものが選ばれます。
Scikit-learnを使用してOvR戦略を設定するには、以下の設定を使用します:
model = LogisticRegression(multi_class='ovr', solver='liblinear', max_iter=200)
OvRの利点:
- 単純なバイナリ分類器を使用して簡単に実装できます。
- 計算の面で効率的です。
- すべてのScikit-learnソルバーとスムーズに動作します。
OvRの限界:
- OvR(One-vs-Rest)メソッドは、複数の分類器が同じインスタンスをポジティブと予測する状況を引き起こす可能性があり、最終的なクラス割り当てを決定するのが混乱することがあります。
- クラス間の潜在的な相関関係を考慮していません。
- クラスが不均衡な場合、うまく機能しない可能性があります。
多項戦略
多項ロジスティック回帰(ソフトマックス回帰)は、すべてのクラスを同時に扱うためにバイナリロジスティック回帰を拡張します。
仕組み:
- 各バイナリ分類のために別々のモデルをトレーニングするのではなく、私たちはただ一つのモデルのトレーニングに集中します。
- ソフトマックス関数が登場し、生のスコアをすべてのクラスにわたる確率に変換します。
- 確率の合計は1になり、有効な確率分布が保証されます。
- 最後に、最も高い確率を持つクラスを選択します。
このアプローチをScikit-learnで実装するには、次の設定を使用します。
model = LogisticRegression(multi_class='multinomial', solver='lbfgs', max_iter=400)
多項ロジスティック回帰の利点:
- モデルは独立してではなく、共同で関係を構築します。
- 全体として、より適切に調整された確率の推定を提供します。
- クラスが重なると、より良いパフォーマンスを発揮する傾向があります。
多項ロジスティック回帰の制限:
- 互換性のあるソルバーが必要です、例えば「lbfgs」、「newton-cg」や「saga」など。
- それはより計算集約的です。
OvRとMultinomialの選択
適切なマルチクラス戦略の選択は、いくつかの重要な要素に依存します:
- データセットのサイズ: データセットが小さい場合、One-vs-Rest の方がよりシンプルなモデルのため、より良い選択かもしれません。
- クラス関係: 多項分布法は、クラス間に強い関係がある場合やオーバーラップする傾向がある場合に、しばしばより良い結果を出します。
- 計算リソース: 多くのクラスにおいて、OvRはよりリソース効率の良い選択肢となることがあります。
- 確率キャリブレーション: 多項分布は異なるクラス間でより良くキャリブレーションされた確率を提供することができる。
他の分類モデルとの比較
ロジスティック回帰以外にも多くの分類モデルがあり、それぞれに長所と短所があります。以下の表では、それらのいくつかを考察します:
| 分類モデル | プロ | コンス |
|---|---|---|
| 決定木 | 解釈が簡単で、非線形関係を扱え、データを正規化する必要がありません | 剪定や正則化を行わないと過剰適合しやすい |
| サポートベクターマシン (SVM) | 複雑で高次元のデータを扱い、より高次元のマッピングのために異なるカーネル関数をサポートします。 | 複雑なパラメータ調整(C、カーネル設定)、大規模データセットでは遅いです |
| ランダムフォレスト | 複数の決定木を使用することで過剰適合を減少させ、高い予測性能を実現します。 | ロジスティック回帰や単一の決定木よりも解釈が難しく、大規模なデータセットでは遅いです。 |
| ロジスティック回帰 | 解釈可能であり、小規模から中規模のデータセットに適しており、線形決定境界を持ち、適切に校正された確率を提供します。 | 線形の決定境界に制限されており、高度に非線形な問題に対しては効果的ではありません。 |
ロジスティック回帰を使用するタイミングは?
- 解釈可能性が主要な優先事項である場合(例えば、医療や金融などの分野で)。
- 線形の決定境界を持つ小規模から中規模のデータセットの場合。
- もし正確に調整された確率が必要な場合。
ランダムフォレストやニューラルネットワークは、データが高い非線形性を示す場合や、モデルの解釈可能性を気にせずに高い精度が求められる場合に、より良い選択肢となることがあります。
FAQセクション
Scikit-learnでのロジスティック回帰の仕組みは? Scikit-learnは、lbfgsやliblinearなどのアルゴリズムを使用して、ロジスティック損失関数を最小化する係数を決定します。ロジスティック回帰モデルをトレーニングするには、.fit(X, y)関数を使用し、残りのプロセスは自動的にScikit-learnに処理させます。
ロジスティック回帰モデルを他の分類モデルの代わりに使用すべき時はいつですか? ロジスティック回帰は、次のような場合に良い出発点です:
- あなたは迅速かつ簡単な分類器が必要です。
- 係数(対数オッズ)を解釈する必要があります。
- あなたのデータは特徴空間内で線形の境界に従う傾向があります。
- あなたは中程度のデータセットサイズを持っています。
ただし、データが大きく非常に非線形である場合や、単純さではなく最高レベルの精度を目指す場合は、SVMやニューラルネットワークのような高度なモデルを検討できます。
ロジスティック回帰の最適なソルバーは何ですか?
正しい手法は、データの次元と性質によります。liblinearとlbfgsは、小規模から中規模のデータセットでよく機能します。大規模またはスパースなデータセットを扱う場合、sagaが際立ちます。なぜなら、L1およびL2正則化を効果的に扱うからです。
ロジスティック回帰における係数の解釈方法は?
ロジスティック回帰モデルの係数は、特徴量の単位増加が対数オッズの結果にどのように影響するかを示しています。正の係数はこの特徴量の増加がポジティブな結果の可能性を高めることを意味し、負の係数はその逆を示唆します。
ロジスティック回帰は非線形関係を扱えるか?
本質的にはありません。ロジスティック回帰は、特徴と対数オッズの関係が線形である必要があります。しかし、モデルに入力する前に多項式特徴や相互作用項を生成することで、モデルが非線形パターンを検出できるようになります。ニューラルネットワーク、ランダムフォレスト、またはカーネルを持つSVMなどの高度なモデルは、非線形関係を直接モデル化することを可能にします。
結論
分類モデルであるロジスティック回帰は、簡潔な実装と解釈のしやすさを提供するため、基礎的なツールとして際立っています。また、線形に分離可能なデータに対しても良好なパフォーマンスを発揮します。ロジスティック回帰は、意思決定に必要な透明性を提供する適切に調整された確率のため、医療や金融などの分野で有用です。特定のタスクにおいてランダムフォレストやニューラルネットワークがより高い精度を示すものの、ロジスティック回帰は特徴の重要性や決定境界を理解するための基準モデルとして残ります。
機械学習技術は、ハイパーパラメータチューニング、正則化、特徴量エンジニアリング技術を通じて研究者がロジスティック回帰を最適化することを可能にします。Scikit-learnの柔軟なデザインにより、ユーザーはさまざまなソルバーやマルチクラス戦略をテストして最適な結果を得ることができます。ロジスティック回帰は、バイナリ分類タスクに適用される場合でも、マルチクラス問題に適応される場合でも、機械学習アプリケーションにおいて重要な価値を提供します。これは、シンプルさと効果性のギャップを埋めます。
参考文献とリソース
- Scikit-Learn (Python) を使ったロジスティック回帰のトレーニング方法
- マルチクラスロジスティック回帰
- LogisticRegression
- 推定器のハイパーパラメータを調整する
- 多項式および一対残りロジスティック回帰の決定境界
- Sklearnのロジスティック回帰のハイパーパラメータ最適化
- 線形モデル
- sklearnのLogisticRegressionにおける「newton-cg」と「newton-cholesky」ソルバーの違いは何ですか?
- Scikit-Learnでロジスティック回帰が収束しない問題の解決方法