NLP処理を高速化するためのGPUでトークナイザーを実行する方法

紹介
自然言語処理(NLP)において、機械学習モデルは残念ながら人間のテキストをそのまま理解することはできません。代わりに、これらの生データを機械学習モデルが理解できる構造化されたコードに変換する必要があります。このプロセスはトークン化と呼ばれます。
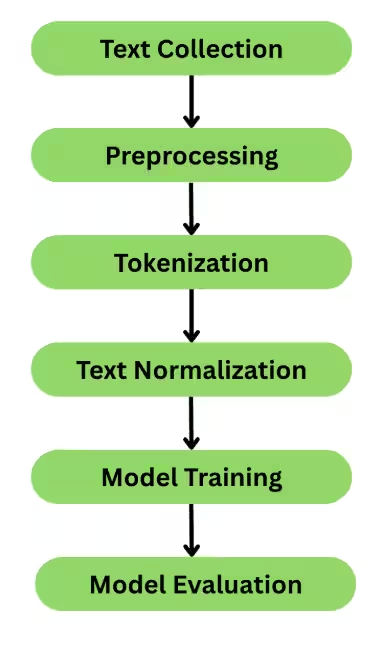
トークン化は、自然言語処理(NLP)パイプラインにおける重要な最初のステップです。それは、テキストをBERTやGPTのようなモデルが処理できるトークンに変換することを含みます。これらのトークンは、トークン化戦略に応じて、単語、サブワード、文字、または句読点になることがあります。
ここにトークン化された文の簡単な例があります。
こんにちは!私はPythonでトークナイザーを作る方法を学んでいます。
こんにちは、私はPythonでトークナイザーを作る方法を学んでいます。
しかし、従来のCPUベースのトークナイゼーションは、大規模またはリアルタイムの推論中にボトleneckになることがあります。従来のGPUは、文字列の処理、正規表現、辞書の検索が関与しているため、トークナイザーの負荷に苦しんでおり、これはベクトル化と行列の乗算に最適化されています。しかし、Hugging Faceは、GPU上で効率的に動作できる速いRustベースのトークナイザーを提供しています。この記事では、トークナイザーを詳細に探り、GPU上でトークナイザーを効率的に実行する方法を理解します。
トークナイザーとは何ですか?
トークナイザーは、生のテキストを小さな部分に分解します。通常はサブワードやトークンであり、これらは数値IDに変換されます。これらのトークンは、BERT、GPT、RoBERTaなどのトランスフォーマーベースのモデルにとって不可欠な入力です。
トークナイザーの種類には次のものがあります:
1. ワードトークナイザー
単語トークナイザーは、空白や句読点に基づいてテキストを分割します。これはシンプルで直感的ですが、語彙外(OOV)語をうまく処理することはできません。
例 (NLTKを使用):
import nltk
nltk.download('punkt')
from nltk.tokenize import word_tokenize

text = "Tokenization is essential for NLP models!"
tokens = word_tokenize(text)
print(tokens)
['Tokenization', 'is', 'essential', 'for', 'NLP', 'models', '!']
2. サブワードトークナイザー
これらの単語は、サブワードと呼ばれるより小さく意味のある単位に分割されます。珍しい言葉や複合語を扱うのに便利です。
a. バイトペアエンコーディング (BPE)
BPEは頻繁に出現する文字やサブワードのペアを反復的にマージします。
例 (Hugging Face tokenizersライブラリの使用):
from tokenizers import Tokenizer
from tokenizers.models import BPE
from tokenizers.trainers import BpeTrainer
from tokenizers.pre_tokenizers import Whitespace

Initialize tokenizer
tokenizer = Tokenizer(BPE())
tokenizer.pre_tokenizer = Whitespace()

Trainer and training corpus
trainer = BpeTrainer(special_tokens=["[UNK]", "[CLS]", "[SEP]", "[PAD]", "[MASK]"])
files = ["your_corpus.txt"]  # Replace with a path to your text file
tokenizer.train(files, trainer)

Encode text
output = tokenizer.encode("Tokenization is essential for NLP models!")
print(output.tokens)
b. WordPiece(BERTで使用)
BPEのようですが、尤度に基づく貪欲アルゴリズムを使用しています。
例 (Hugging Face transformersを使用)
from transformers import BertTokenizer

tokenizer = BertTokenizer.from_pretrained('bert-base-uncased')
tokens = tokenizer.tokenize("Tokenization is essential for NLP models!")
print(tokens)
出力:[‘トークン’, ‘##化’, ‘は’, ‘必須’, ‘です’, ‘nl’, ‘##p’, ‘モデル’, ‘!’]
c. センテンスピース
SentencePiece は入力を生のバイト列として扱い、多言語タスクに対して効果的に機能します。
import sentencepiece as spm

Train a SentencePiece model (one-time)
spm.SentencePieceTrainer.train(input='your_corpus.txt', model_prefix='m', vocab_size=5000)

Load and tokenize
sp = spm.SentencePieceProcessor(model_file='m.model')
tokens = sp.encode("Tokenization is essential for NLP models!", out_type=str)
print(tokens)
3. 文字レベルのトークナイザー
キャラクターレベルのトークナイザーでは、各文字がトークンとして扱われます。ここに単語を単一の文字に分割するためのシンプルなPythonコードがあります。
text = "Token"
tokens = list(text)
print(tokens)
GPUトークン化をサポートするツール
1. ハギングフェイストークナイザー(ファストトークナイザー)
Hugging Faceは、効率的な並列トークン化のためのRustベースのtokenizersライブラリに基づいたPreTrainedTokenizerFastを提供しています。「遅い」トークナイザは、HuggingFace Transformersライブラリ内でPythonで実装されたものであり、一方「速い」トークナイザは、HuggingFace Tokenizersライブラリによって提供されるRustベースのバージョンです。

ただし、遅いトークナイザーと高速トークナイザーの速度の違いは、多くのテキストを並行して処理する場合にのみ顕著になることに注意してください。単一の文の場合、高速バージョンは逆に遅くなることもあります。高速トークナイザーの重要な強みの一つは、「オフセットマッピング」と呼ばれるものです。
オフセットマッピングは、トークンが元のテキストのどの部分から来たのかを正確に教えてくれます。これにより、私たちは単語をそれらが分割されたトークンにマッピングすることができます。
本質的にはCPUベースですが、出力テンソルはすぐにGPUに移動できます。
from transformers import AutoTokenizer
tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased", use_fast=True)
inputs = tokenizer(["Tokenize this on GPU"], return_tensors="pt", padding=True)
inputs = {k: v.to("cuda") for k, v in inputs.items()}
2. バイトペアエンコーディングトークン化
例えば、もし「a」と「t」が「cat」、「bat」、「bats」などの単語において最も多く出現する場合、それは「at」に統合されます。更新されたコーパスは次のようになるかもしれません:(「c」、「at」), (「c」、「a」、「p」), (「c」、「a」、「n」), (「b」、「at」), (「b」、「at」、「s」)。BPEは頻繁なトークンペアを学習し続け、「c」と「at」→「cat」や「b」と「at」→「bat」といったように、長いサブワードを構築します。これにより、一般的なパターンに最適化された語彙を作成しつつ、少ない単位を通じて稀な単語を扱う柔軟性を保持します。
文字から始める: すべての単語は個々の文字に分割されます。例えば: lower → ['l', 'o', 'w', 'e', 'r']
最も頻繁に出現する文字やサブワードのペアを見つけて、マージします。 例えば、'l' と 'o' が一緒に頻繁に現れる場合 → マージします:
['lo', 'w', 'e', 'r']マージプロセスを繰り返す:
毎回、最も頻繁な隣接のペアがマージされます。
最終的には:
['low', 'er']
トークン化は、設定された語彙サイズに達するか、特定の数のマージが実行された時点で停止します。
以下の例の単語を使用したバイトペア符号化(BPE)のシンプルなPython実装があります:"cat"、"cap"、"can"、"bat"、および "bats"。
この例は:
- 単語トークンの頻度を数えます。
- 言葉を文字に分けてください。
- BPEのマージを段階的に適用します。
from collections import defaultdict, Counter

Sample corpus with word frequencies
corpus = {
    "cat": 5,
    "cap": 3,
    "can": 2,
    "bat": 4,
    "bats": 2
}

Step 1: Represent each word as a list of characters + word boundary token
def get_tokenized_corpus(corpus):
    return {
        tuple(word): freq for word, freq in corpus.items()
    }

Step 2: Count frequency of all adjacent symbol pairs
def get_pair_freqs(tokenized_corpus):
    pairs = defaultdict(int)
    for word, freq in tokenized_corpus.items():
        for i in range(len(word) - 1):
            pair = (word[i], word[i + 1])
            pairs[pair] += freq
    return pairs

Step 3: Merge the most frequent pair
def merge_pair(pair, tokenized_corpus):
    new_corpus = {}
    bigram = ' '.join(pair)
    replacement = ''.join(pair)

    for word, freq in tokenized_corpus.items():
        new_word = []
        i = 0
        while i < len(word):
            if i < len(word) - 1 and word[i] == pair[0] and word[i + 1] == pair[1]:
                new_word.append(replacement)
                i += 2
            else:
                new_word.append(word[i])
                i += 1
        new_corpus[tuple(new_word)] = freq
    return new_corpus

Step 4: Apply BPE for a few merges
tokenized_corpus = get_tokenized_corpus(corpus)
vocab = set(char for word in tokenized_corpus for char in word)

print("Initial vocabulary:", sorted(vocab))
print("Initial corpus:", tokenized_corpus)

num_merges = 5
for i in range(num_merges):
    pair_freqs = get_pair_freqs(tokenized_corpus)
    if not pair_freqs:
        break
    most_frequent = max(pair_freqs, key=pair_freqs.get)
    print(f"\nMerge {i+1}: Merging {most_frequent} → {''.join(most_frequent)}")
    tokenized_corpus = merge_pair(most_frequent, tokenized_corpus)
    vocab.add(''.join(most_frequent))
    print("Updated corpus:", tokenized_corpus)

print("\nFinal vocabulary:", sorted(vocab))
Initial vocabulary: ['a', 'b', 'c', 'n', 'p', 's', 't']
Initial corpus: {('c', 'a', 't'): 5, ('c', 'a', 'p'): 3, ('c', 'a', 'n'): 2, ('b', 'a', 't'): 4, ('b', 'a', 't', 's'): 2}

Merge 1: Merging ('a', 't') → at
Updated corpus: {('c', 'at'): 5, ('c', 'a', 'p'): 3, ('c', 'a', 'n'): 2, ('b', 'at'): 4, ('b', 'at', 's'): 2}

Merge 2: Merging ('b', 'at') → bat
...
3. NVIDIA RAPIDS cuDFのGPUサブワードトークナイザー
NVIDIAのRAPIDS cuDFライブラリは、GPUに最適化されたトークナイザーを提供し、サブワードトークナイザーに基づいています。
ディープラーニングのワークフロー、特にBERTのようなモデルを使用する場合、トークン化はしばしばパフォーマンスのボトルネックにつながります。spaCyやHuggingFaceのBertTokenizerFastのようなCPUベースのトークナイザーは、CPUとGPUの間でデータをコピーするのに多くの時間を費やし、レイテンシを引き起こします。
NVIDIA RAPIDSのcudf.str.subword_tokenizeは、これに対処するためにトークン化を完全にGPU上で実行します:
- 従来のトークナイザーよりも483倍速いです。
- GPUメモリにすべての中間出力を保持します。
- 高価なCPUからGPUへのメモリコピーを排除します。
- RAPIDS DataFrame ワークフローとシームレスに統合されます。
import cudf
from cudf.utils.hash_vocab_utils import hash_vocab
from cudf.core.subword_tokenizer import SubwordTokenizer

Step 1: Hash the BERT vocabulary (only needs to be done once)
hash_vocab('bert-base-cased-vocab.txt', 'voc_hash.txt')

Step 2: Initialize the tokenizer with the hashed vocab
cudf_tokenizer = SubwordTokenizer('voc_hash.txt', do_lower_case=True)

Step 3: Create a cuDF Series with input text
str_series = cudf.Series(['This is the', 'best book'])

Step 4: Tokenize using GPU
tokenizer_output = cudf_tokenizer(
    str_series,
    max_length=8,
    max_num_rows=len(str_series),
    padding='max_length',
    return_tensors='pt',  # Return PyTorch tensors
    truncation=True
)

Step 5: Access tokenized output (all in GPU memory)
print("Input IDs:\n", tokenizer_output['input_ids'])
print("Attention Mask:\n", tokenizer_output['attention_mask'])
print("Metadata:\n", tokenizer_output['metadata'])
出力 :
Input IDs:
tensor([[ 101, 1142, 1110, 1103,  102,    0,    0,    0],
        [ 101, 1436, 1520,  102,    0,    0,    0,    0]],
        device='cuda:0', dtype=torch.int32)

Attention Mask:
tensor([[1, 1, 1, 1, 1, 0, 0, 0],
        [1, 1, 1, 1, 0, 0, 0, 0]],
        device='cuda:0', dtype=torch.int32)

Metadata:
tensor([[0, 1, 3],
        [1, 1, 2]], device='cuda:0', dtype=torch.int32)
cudf.str.subword_tokenizeは、数百万のテキストエントリーを処理する必要がある場合や、リアルタイムでの大規模NLPプロジェクトに取り組む場合に使用できます。このトークナイザーは、プロダクション環境でspaCyやHuggingFaceのトークナイザーのボトルネックを置き換える必要がある場合にも使用可能です。
4. GPUを使用したSentenceTransformers
Sentence-transformersは、出力をGPUに移動してエンコーダーに合わせることができるトークナイザーもサポートしています。SentenceTransformer()に文を渡すと、自動的に入力をトークナイズし、事前学習されたトランスフォーマーモデルに入力し、隠れた状態に対してプーリング戦略—通常は平均プーリング—を適用して固定サイズの文埋め込みを生成します。これにより、使いやすさとスピードが深いカスタマイズよりも重要な意味検索、文の類似性、クラスタリングなどのタスクにおいて特に迅速な展開が可能になります。
from sentence_transformers import SentenceTransformer
model = SentenceTransformer('all-MiniLM-L6-v2').to("cuda")
embeddings = model.encode(["GPU tokenization"], device="cuda")
理想的な使用例は、意味検索、クラスタリング、テキスト分類、または文の類似性などの文埋め込みを含むタスクです。
GPUでのトークン化のベストプラクティス
GPUでトークン化を行う際に従うべきいくつかの戦略について話し合い、要約しましょう。これにより、処理が速くなります:
PreTrainedTokenizerFastをパフォーマンスのために使用してください。Hugging FaceのPreTrainedTokenizerFastは、特にパフォーマンスにおいて非常に最適化されていることで知られています。特に大規模なデータセットでは、Pythonベースのトークナイザーに比べて桁違いの性能を発揮します。利用可能な場合は、常にPreTrainedTokenizerよりもこちらを優先してください。- トークン化された出力をGPUに移動するには、
.to("cuda")を使用してください。トークナイザーは通常、デフォルトでCPU上で出力を返します。出力をGPU上のモデルに供給する場合、トークン化されたテンソル(input_ids、attention_maskなど)が明示的にCUDAに移動されていることを確認して、推論中のデータ転送オーバーヘッドを防ぎます: - 小さなバッチサイズを避けてください — それらはGPUを十分に活用できません。小さなバッチサイズはGPUの利用効率が悪化する原因となります。GPUは、大きなバッチが使用されるときに最も効果的に機能し、テンソル操作が効率的に並列化されます。メモリの利用可能性と計算スループットのバランスを考慮したバッチサイズ(例:32、64、またはメモリが許す場合はそれ以上)を使用してください。
- トレーニング用:データセット全体をバッチでトークン化し、キャッシュしてください。モデルをトレーニングしたり、同じデータセットに対して繰り返し推論を行う場合は、データセット全体を一度大きなバッチでトークン化し、出力をキャッシュしてください。こうすることで、冗長な前処理を避け、トレーニング中のスループットを最大化できます。
- 異なるバッチサイズのベンチマーク性能。すべてのハードウェア構成が同じバッチサイズで同じように良好に動作するわけではありません。トークン化とモデル推論のために異なるバッチサイズのベンチマークを実施し、あなたのセットアップに最適なサイズを特定してください。
time、nvidia-smi、またはtorch.utils.benchmarkなどのツールを使用して、処理速度とメモリ消費に関するメトリックを収集します。
これらの実践に従うことで、トークン化プロセスがNLPパイプラインの妨げにならず、GPUがパイプライン全体で効率的に使用されることが保証されます。これは、特に大規模に深層学習モデルをトレーニングしたり、チャットボットやリアルタイム推論システムのようなレイテンシに敏感なアプリケーションを展開する場合に重要です。
一般的な質問
Q: トークナイゼーションはGPUで実行できますか?
はい、トークナイゼーションはRAPIDSのようなフレームワークを使用してGPU上で実行可能です。これにより、真のGPU加速トークナイゼーションが実現します。さらに、Hugging Faceのトークナイザーは、GPUに転送できるテンソルを生成し、より迅速な下流処理を行うことができます。
Q: どのトークナイザーがGPUをサポートしていますか?
RAPIDSやFasterTransformerはネイティブサポートを提供しています。Hugging FaceはGPU互換の出力を持つ効率的なCPUトークナイザーを提供しています。
Q: GPUでトークン化する方が速いですか?
はい、GPUでトークン化することは、特に大規模なデータセットやバッチ処理の場合、GPUの並列処理機能のおかげで速くなります。RAPIDSやCuDFのようなフレームワークは、GPUコアを効率的に利用することでトークン化を加速します。ただし、小規模なワークロードの場合、データをGPUに転送する際のオーバーヘッドに比べて、速度向上は negligible かもしれません。
Q: トークナイザーはトレーニングする必要がありますか?
プレトレーニング済みのトークナイザーが一般的に使用されます(例:BERTトークナイザー)。また、Hugging Faceのtokenizersライブラリを使用してカスタムのトークナイザーをトレーニングすることも可能です。
Q: トークナイザーをどのように読み込むのですか?
from transformers import AutoTokenizer
tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")
結論
トークン化はNLPパイプラインにおける小さなステップのように見えるかもしれませんが、大規模なデータセットやリアルタイムアプリケーションで作業する際には、特にCPUに任せたままにすると重要なパフォーマンスボトルネックになります。GPUベースのトークン化を活用することで、この前処理フェーズを大幅に加速し、全体の機械学習や推論ワークフローをはるかに効率的にします。
Hugging Face の PreTrainedTokenizerFast や RAPIDS の SubwordTokenizer のようなライブラリは、大規模でのトークン化をこれまでになく簡単にしています。大きなモデルのトレーニング、チャットボットの提供、または大規模なテキストコーパスの分析を行っているかにかかわらず、GPUトークン化は賢くスケーラブルなソリューションを提供します。SentenceTransformer() のような高レベルのツールと、AutoTokenizer() + AutoModel() のような低レベルのオプションの両方を理解し、ベストプラクティスに従うことで、ニーズに応じた適切なアプローチを選択できます。
リソース
- SentenceTransformerとAutoTokenizer + AutoModelの理解
- cuDFのドキュメントへようこそ!
- センテンストランスフォーマー
- トークナイザー
- BERT言語モデルのためのGPUベースのトークナイザーを使って、データをライトスピードで前処理しよう
- バイトペアエンコーディングトークン化
- QAパイプラインにおける高速トークナイザー