uniqコマンドを使用してLinuxテキストファイル内の重複データを見つける方法
重複する内容が含まれているテキストファイルがある場合、それを削除する方法を学ぶ時が来ました。uniqコマンドの使い方を学びましょう。
重複した行や重複する単語があるテキストファイルを見たことがありますか?もしかしたら、コマンドの出力を定期的に扱っていて、それらの中から異なる文字列をフィルタリングしたいと思っているかもしれません。Linuxにおけるテキストファイルと冗長データの削除に関しては、uniqコマンドが最適な選択です。
この記事では、uniqコマンドについて詳しく説明し、テキストファイルから重複行を削除するためのコマンドの使用方法についての詳細なガイドを提供します。
uniqコマンドとは何ですか?
Linuxのuniqコマンドは、テキストファイル内の同一の行を表示するために使用されます。このコマンドは、テキストファイルから重複する単語や文字列を削除したい場合に便利です。uniqコマンドは隣接する行を比較して冗長なコピーを見つけるため、ソートされたテキストファイルでのみ機能します。
幸運なことに、sort コマンドを uniq と組み合わせて、コマンドに適した方法でテキストファイルを整理できます。重複行を表示するだけでなく、uniq コマンドはテキストファイル内の重複行の出現回数を数えることもできます。
uniqコマンドの使い方
uniqでは様々なオプションやフラグを使用することができます。その中には、繰り返し出現する行を印刷するなどの基本的な操作を行うものもあれば、Linuxでテキストファイルを頻繁に扱う上級者向けのものもあります。
基本構文
uniqコマンドの基本構文は次の通りです:
uniq option input output...ここでオプションはコマンドの特定のメソッドを呼び出すために使用されるフラグであり、入力は処理のためのテキストファイル、出力は出力を保存するファイルのパスです。
出力引数はオプションであり、スキップできます。ユーザーが入力ファイルを指定しない場合、uniqは標準出力からデータを入力として取ります。これにより、ユーザーはuniqを他のLinuxコマンドとパイプで接続できます。
例のテキストファイル
コマンドの入力としてテキストファイルduplicate.txtを使用します。
127.0.0.1 TCP
127.0.0.1 UDP
Do catch this
DO CATCH THIS
Don't match this
Don't catch this
This is a text file.
This is a text file.
THIS IS A TEXT FILE.
Unique lines are really rare.
このテキストファイルはすでにsortコマンドを使用してソートされていることに注意してください。別のテキストファイルを扱っている場合、以下のコマンドを使用してソートできます:
sort filename.txt > sorted.txt重複した行を削除する
uniqの最も基本的な使用方法は、入力から繰り返された文字列を削除し、一意の出力を印刷することです。
uniq duplicate.txt出力 :
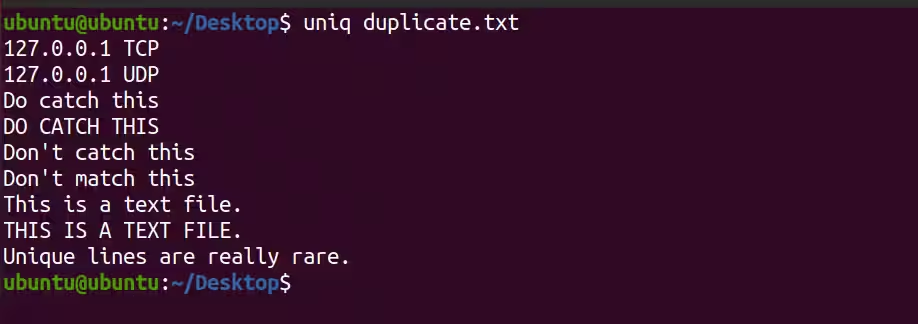
システムが これはテキストファイルです の2回目の出現を表示しないことに注意してください。また、前述のコマンドはファイル内の唯一の行のみを印刷し、元のテキストファイルの内容には影響を与えません。
繰り返し行を数える
テキストファイル内の繰り返し行の数を出力するには、デフォルトのコマンドに -c フラグを付けて使用します。
uniq -c duplicate.txt出力 :
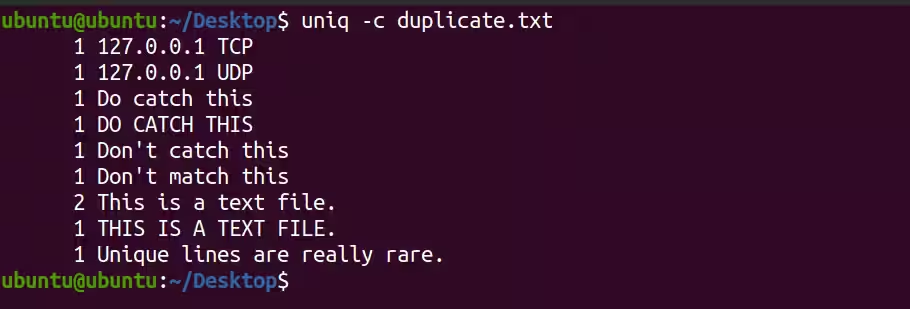
システムはテキストファイルに存在する各行のカウントを表示します。This is a text fileという行がファイル内に2回出現することが分かります。デフォルトでは、uniqコマンドは大文字小文字を区別します。
繰り返された行のみを印刷する
テキストファイルから重複行のみを印刷するには、-D フラグを使用してください。-D は重複を意味します。
uniq -D duplicate.txtシステムは次のように出力を表示します。
This is a text file.
This is a text file.
重複をチェックする際にフィールドをスキップする
特定のフィールド数をスキップして文字列をマッチングしたい場合は、コマンドに-fフラグを使用できます。-fはフィールドを表します。
次のテキストファイル fields.txt を考えてください。
192.168.0.1 TCP
127.0.0.1 TCP
354.231.1.1 TCP
Linux FS
Windows FS
macOS FS
最初のフィールドをスキップするには:
uniq -f 1 fields.txt出力 :
192.168.0.1 TCP
Linux FS
前述のコマンドは最初のフィールド(IPアドレスとOS名)をスキップし、2番目の単語(TCPとFS)を一致させました。その後、各一致の最初の出現を出力として表示しました。
比較する際に文字を無視する
フィールドをスキップするように、文字をスキップすることもできます。-s フラグを使用すると、重複行をマッチさせる際にスキップする文字数を指定できます。この機能は、次のようなリスト形式のデータを扱うときに役立ちます:
1. First
2. Second
3. Second
4. Second
5. Third
6. Third
7. Fourth
8. Fifthファイルlist.txtで最初の2文字(リスト番号)を無視するには:
uniq -s 2 list.txt出力 :

上記の出力では、最初の2文字が無視され、残りの文字がユニークな行として一致しました。
最初のN文字をチェックして重複を確認する
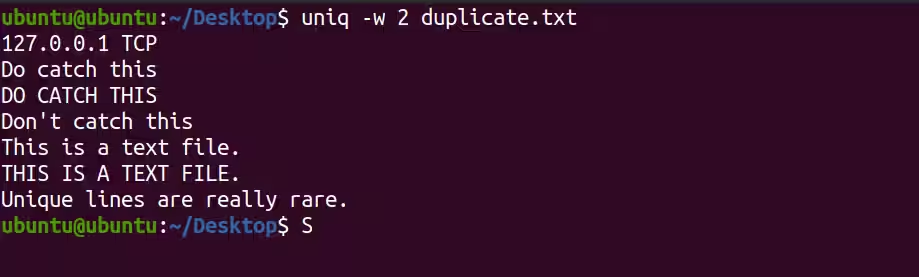
-w フラグを使用すると、重複を確認するために固定の文字数のみをチェックできます。例えば:
uniq -w 2 duplicate.txt前述のコマンドは最初の二文字のみ一致し、ユニークな行があれば表示します。
出力 :
大文字と小文字の区別をなくす
上述したように、uniqはファイル内の行を一致させる際に大文字と小文字を区別します。文字の大文字小文字を無視するには、コマンドに-iオプションを使用してください。
uniq -i duplicate.txt次の出力が表示されます。
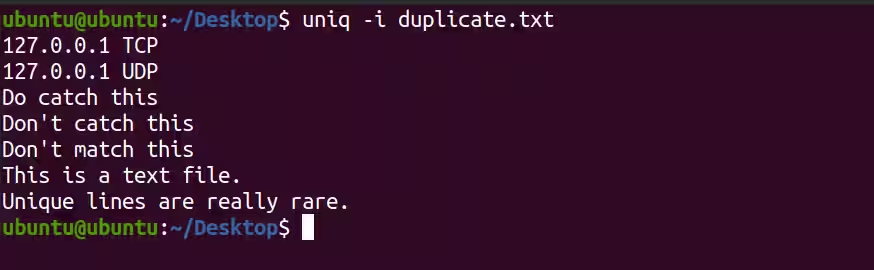
上記の出力で注意してください。uniqはこの行をキャッチしてくださいとこれはテキストファイルですを表示しませんでした。
出力をファイルに送信する
uniqコマンドの出力をファイルに送るには、以下のように出力リダイレクション(>)文字を使用できます:
uniq -i duplicate.txt > otherfile.txtテキストファイルに出力を送信している間、システムはコマンドの出力を表示しません。新しいファイルの内容はcatコマンドを使用して確認できます。
cat otherfile.txtLinuxでは、コマンドラインの出力をファイルに送るための他の方法も使えます。
uniqを使用して重複データを分析する
Linuxサーバーを管理しているとき、大部分の時間は端末で作業したりテキストファイルを編集したりすることになります。したがって、テキストファイル内の冗長な行のコピーを削除する方法を知っていることは、Linuxスキルセットにとって大きな資産となるでしょう。
テキストファイルを扱うことは、ファイル内のテキストをフィルタリングしたりソートしたりする方法がわからないとフustratingになります。作業を楽にするために、Linuxにはsedやawkなどのいくつかのテキスト編集コマンドがあり、これを使用することでテキストファイルやコマンドラインの出力を効率的に扱うことができます。