2025年におけるLinux向けのベスト5オープンソースOCRツール
OCRは光学文字認識を意味し、この種類のソフトウェアは画像、写真、またはスキャンした文書を編集可能で検索可能なテキストに変換するように設計されています。
それを使うことで、文書を手動で入力する必要がなくなります。文書は自動的に機械可読のテキスト形式に変換され、特定の状況で便利であり、時間と労力を節約することができます。
使いやすくても強力なOCRツールを探している場合、Linuxユーザー向けには、PythonライブラリからプロフェッショナルなSDKまで、オープンソースと商用の両方のオプションが利用可能です。
この記事では、手元にあるもの、写真であれ法律文書のスキャンコピーであれ、編集可能なテキストに変換するために使用できる、最高のオープンソースプログラムを紹介します。
1. ONLYOFFICE Docs の OCR ツール
もしあなたが文書、スプレッドシート、プレゼンテーション、図表、PDFをよく扱うのであれば、ONLYOFFICE Docsは、信頼性の高いOCR機能とフル機能のオープンソースオフィススイートの機能を兼ね備えているため、理想的な選択肢かもしれません。
LinuxおよびWindowsサーバー用のセルフホスト型ソリューションとして利用可能で、あらゆるウェブベースのDMS、CMS、またはファイル共有プラットフォームに簡単に統合でき、リアルタイムコラボレーションを可能にします。このスイートは、同じエンジンに基づき、あらゆるLinuxディストリビューションと互換性のある無料デスクトップアプリも提供します。
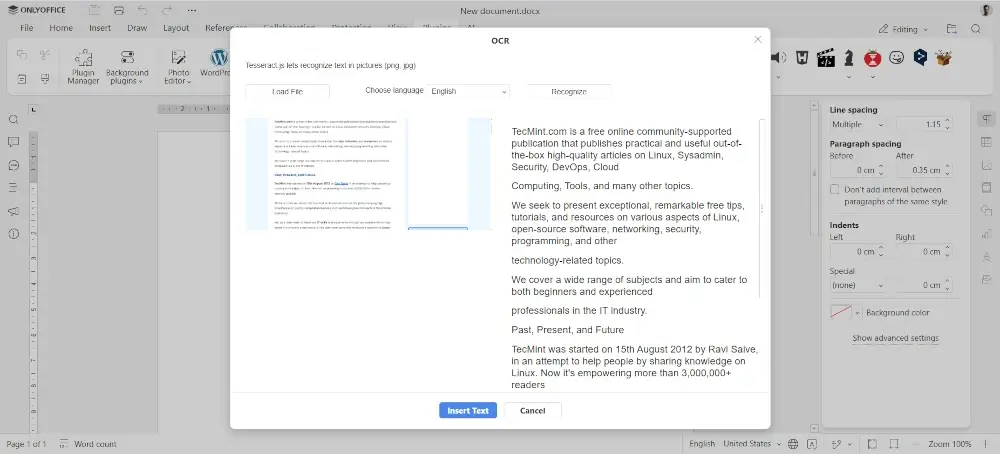
ONLYOFFICE Docsでは、OCRは2つの方法で動作するため、最適な方法を選ぶことができます。まず、組み込みプラグインマーケットプレイスにOCRプラグインがあります。これは事前にインストールされておらず、手動でのインストールが必要で、いくつかのクリック操作が必要です。
インストール後、OCRプラグインはPNGおよびJPG形式の画像や写真のテキストを認識し、認識したテキストを文書に挿入してさらに編集できるようにします。
ONLYOFFICEのOCRプラグインは、Tesseract OCRエンジンの上に構築されたJavaScriptライブラリであるTesseract.jsに基づいており、60以上の言語をサポートしています。
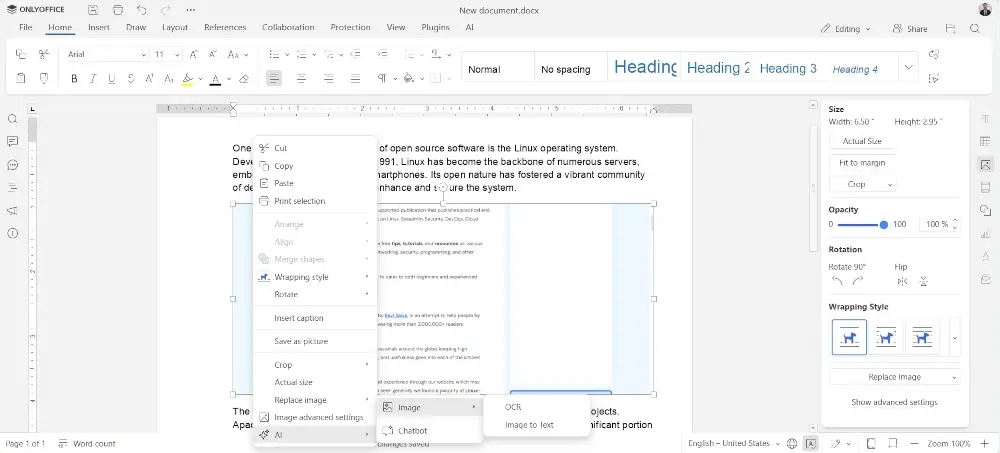
ONLYOFFICE DocsでのOCRの別の使用方法は、人工知能を活用するため、より多くの機会と機能を提供します。このスイートには特別なプラグインがあり、その主な目的は、すべての人気のあるAIアシスタントやチャットボットを統合し、それらの能力を文書編集作業に利用することです。例えば、文章生成、翻訳、文法やスタイルの修正、要約などです。
一部の最新のAIモデルはOCR目的で特別に設計されており、光学文字認識向けに調整されたオープンソースのLLMも見つけることができます。これらのモデルは、対応するAIプロバイダーによって発行された有効なAPIキーを持っていれば、ONLYOFFICE AIプラグインに追加することができます。追加すると、コンテキストメニューのOCRオプションを使用して、ドキュメント内の画像からテキストを認識することができます。
このAI搭載のOCR統合の最大の利点は、デフォルトのものを使用する必要がなく、画像を直接ドキュメント内で編集可能なテキストに変換できることです。Mistral、Anthropic、Ollama、GPT4ALL、LocalAIなど、信頼できる企業やプラットフォームが提供するさまざまなAIモデルの中から自由に選択でき、カスタムモデルも含まれます。
2. OCRmyPD
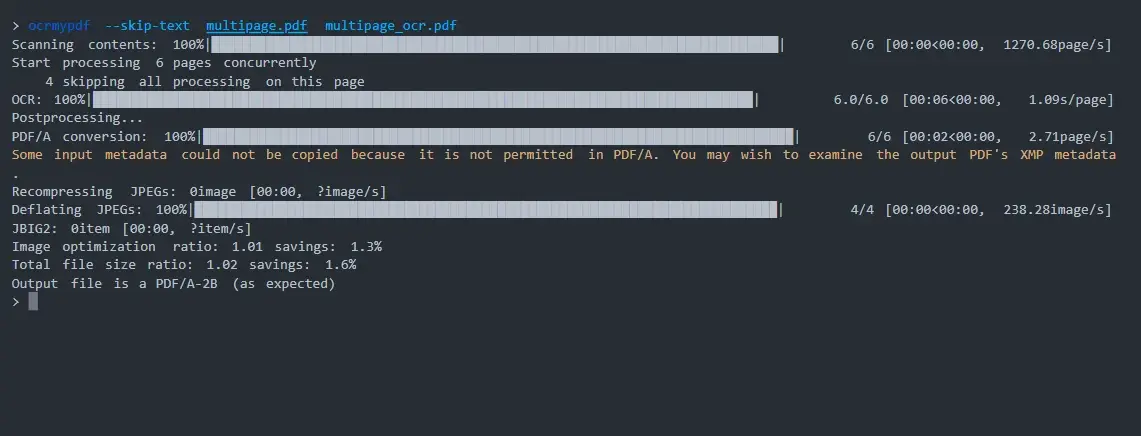
OCRmyPDFは、PDFページにOCRテキストレイヤーを追加してテキストを認識し、検索やコピー/貼り付け操作に適したものにするオープンソースのツールです。実際、PDFで認識されたテキストは、PDFエディタで開かない限り編集することはできません。
OCRmyPDF が行うことは、元のPDFのフォーマット要素を保持しながら、スキャンされたPDFに新しい検索可能なテキストレイヤーを追加することです。OCR変換の出力結果は、画像が最適化された新しい検索可能なPDF/Aファイルです。
このツールはTesseract OCRエンジンを使用しており、数千ページのファイルも簡単に処理できます。もう一つの利点は、データをプライベートに保つことができ、機密ファイルやPDFドキュメントを扱うことができる点です。
コマンドラインツールとして、OCRmyPDF はターミナルコマンドの知識を必要としますが、光学文字認識プロセスを自動化することができます。
3. gImageReader
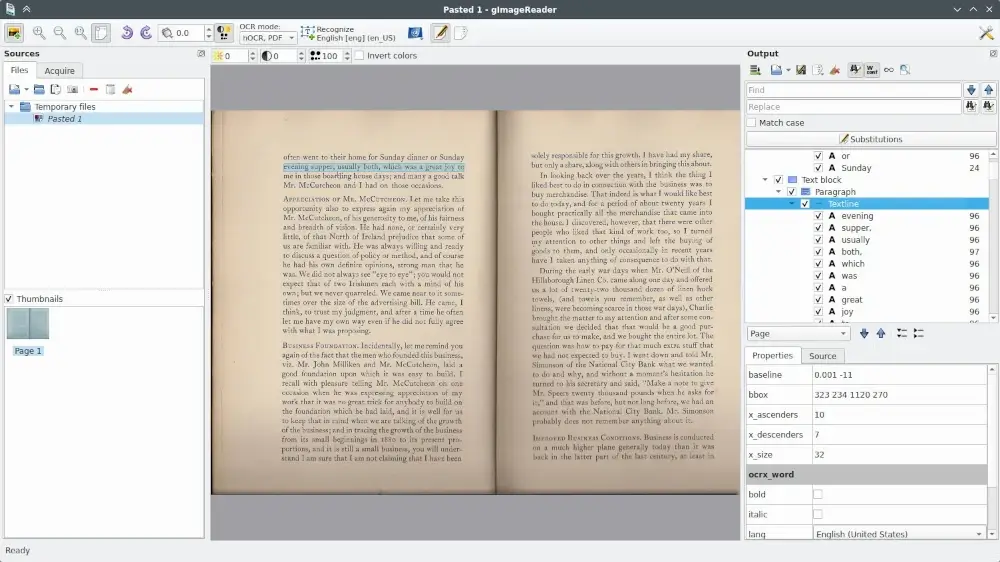
gImageReaderは、ユーザーフレンドリーなフロントエンドとして開発された無料でオープンソースのOCRプログラムであり、Tesseract OCRエンジンを使用しています。直感的なグラフィカルユーザーインターフェースのおかげで、Linuxユーザーは画像、写真、スキャンしたドキュメント、PDFファイルから簡単にテキストを抽出でき、編集可能なテキスト形式を取得するのが容易になります。このツールを使用する際、必要な認識領域を手動で選択することも、自動選択オプションに頼ることも可能です。
gImageReaderの利点の一つは、複数のファイルを一度に処理できる能力であり、多くの文書をより迅速に扱うことができる点です。
画像やPDFに加えて、gImageReaderはOCRによって取得された書式付きテキストのデータ表現のオープン標準であるhOCRもサポートしています。例えば、そのようなファイルをPDF形式に変換することも可能です。
もう一つ言及する価値があるのは多言語サポートです — gImageReaderは英語に加えていくつかの言語で利用可能です。
4. OCRFeeder
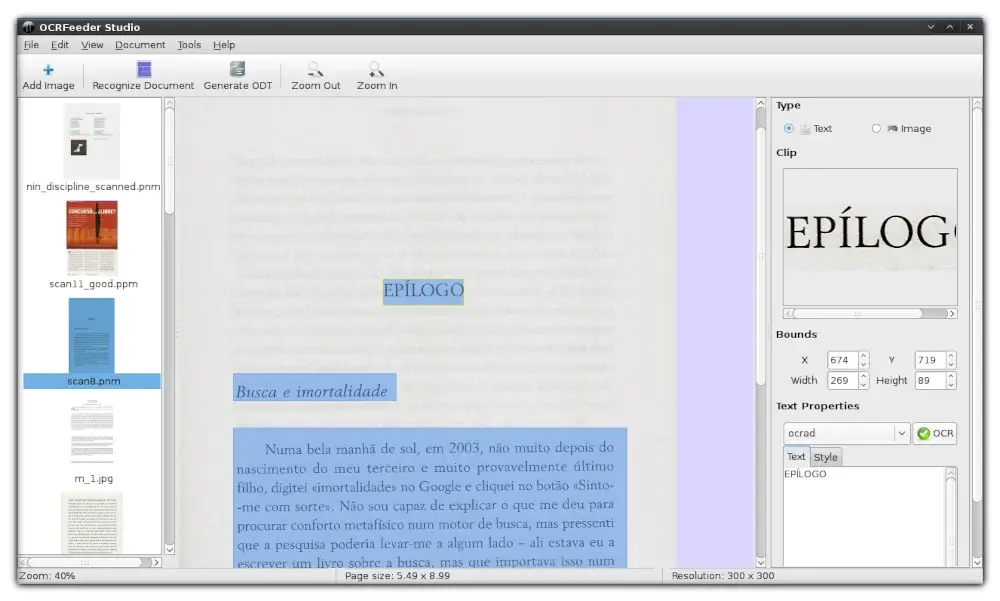
OCRFeederは、GNOMEデスクトップ環境向けのオープンソースOCRスイートです。このツールにはグラフィカルユーザーインターフェイスが付属しており、テキスト内の認識されなかった文字を素早く修正したり、バウンディングボックスを編集したり、段落スタイルやその他の要素を設定したり、入力画像を削除したり、OCR処理後のすべての手動修正を行うことができます。
OCRFeederを使うと、PDFをインポートして処理後にODTやHTMLなどの複数の形式で保存することができます。文書を光学文字認識のために開くと、プログラムは自動的にその内容を概略化し、テキスト文字に対して正確にOCRを実行します。
グラフィカルなインターフェースを持ちながらも、OCRFeederはコマンドライン操作もサポートしており、自動文書バッチ処理を提供するため、多くの時間と労力を節約できます。
5. 書類作業
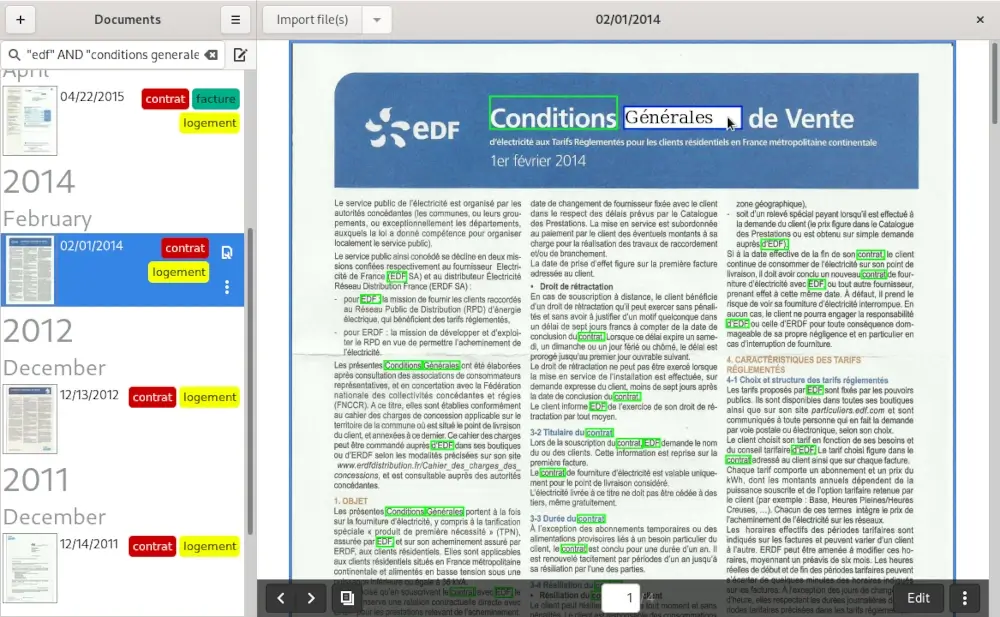
Paperworkは単なるオープンソースのOCRアプリケーション以上のものです。それはノート作成機能を備えたフル機能のドキュメント管理プラットフォームです。このソフトウェアの主なコンセプトは、Linuxユーザーがすべての電子文書を一か所に保存、整理、管理するのを支援することです。
もし書類の分類や整理に多くの時間を費やしたくないなら、Paperwork が違いを生みます。その「スキャンして忘れる」というアプローチにより、書類を一度スキャンすれば、必要になるまでその存在を忘れることができます。
このアプリケーションは、すべてのファイルを検索可能なドキュメントに変換するので、数語を入力するだけで目的のドキュメントをすばやく見つけることができます。また、ラベルを作成して、ファイルストレージ内のさまざまなカテゴリーに適用することもできます。
Paperworkはサードパーティのサービスと簡単に統合でき、Nextcloud、Syncthing、SparkleShare、その他のツールに接続して、異なるフォルダにあるすべてのファイルのための集中管理ストレージスペースを作成できます。
Paperworkは、画像のテキストをスキャンして編集可能な形式に変換し、必要な部分を選択、コピー、貼り付けできるようにします。
結論
OCRソフトウェアはニッチではありますが、すべてのLinuxユーザーが定期的に必要とするわけではありません。それでも、スクリーンショットやスキャンしたPDFを編集可能なテキストに変換したい場合には、このようなプログラムは非常に役立ちます。コマンドラインツールからグラフィカルインターフェースを持つアプリケーションまで、Linuxオペレーティングシステム用の適切な選択肢があります。
上記のリストにあるすべてのオプションは、それぞれ強みと弱みがあり、特定の状況下で最も効果的に機能します。しかし、それらはすべてオープンソースであり、OCRの作業に効率的に対応できます。