LinuxコマンドラインからMySQLクエリを実行する方法
もしあなたがデータベースサーバーの管理を担当している場合、時々クエリを実行して注意深く確認する必要があるかもしれません。MySQL/MariaDB シェルからそれを行うこともできますが、このヒントでは、Linux コマンドラインを使用して直接 MySQL/MariaDB のクエリを実行し、後で確認するために出力をファイルに保存することも可能になります(クエリが大量のレコードを返す場合に特に便利です)。
より高度なクエリに進む前に、まずコマンドラインから直接MYSQLクエリを実行するいくつかの簡単な例を見てみましょう。
例示データベースの設定
コマンドに入る前に、このガイド全体で使用する例のデータベースを設定しましょう。これにより、読者自身のシステムでこれらの手法を追体験し、練習することができます。
tecmintdb データベースの作成
まず、tecmintdb データベースと tutorials テーブルを作成しましょう:
mysql -u root -p -e "CREATE DATABASE IF NOT EXISTS tecmintdb;"
次に、データベース tecmintdb に tutorials という名前のデータベーステーブルを作成するには、以下のコマンドを実行します:
sudo mysql -u root -p tecmintdb << 'EOF'
CREATE TABLE IF NOT EXISTS tutorials (
    tut_id INT NOT NULL AUTO_INCREMENT,
    tut_title VARCHAR(100) NOT NULL,
    tut_author VARCHAR(40) NOT NULL,
    submission_date DATE,
    PRIMARY KEY (tut_id)
);

INSERT INTO tutorials (tut_title, tut_author, submission_date) VALUES
('Getting Started with Linux', 'John Smith', '2024-01-15'),
('Advanced Bash Scripting', 'Sarah Johnson', '2024-02-20'),
('MySQL Database Administration', 'Mike Williams', '2024-03-10'),
('Apache Web Server Configuration', 'Emily Brown', '2024-04-05'),
('Python for System Administrators', 'David Lee', '2024-05-12'),
('Docker Container Basics', 'Lisa Anderson', '2024-06-18'),
('Kubernetes Orchestration', 'Robert Taylor', '2024-07-22'),
('Linux Security Hardening', 'Jennifer Martinez', '2024-08-30');
EOF
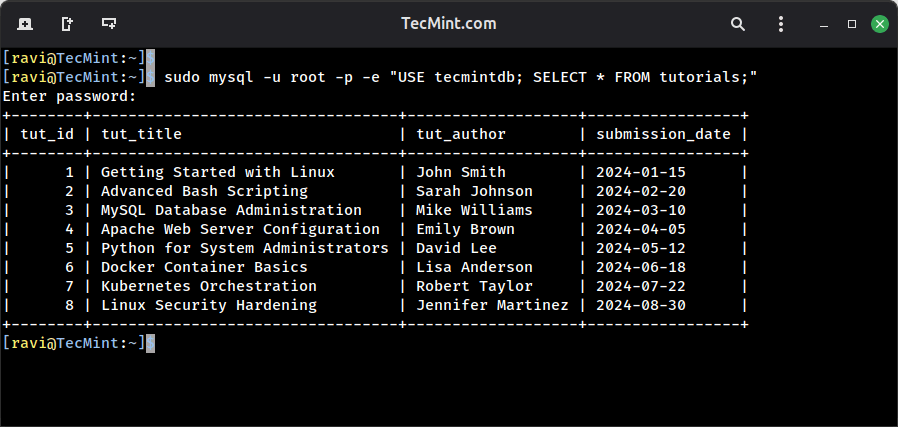
データが挿入されたことを確認してください:
sudo mysql -u root -p -e "USE tecmintdb; SELECT * FROM tutorials;"
従業員データベースの作成
さて、複数の関連テーブルを持つより複雑なemployeesデータベースを作成しましょう。これは、より高度なクエリの例で使用するデータベースです:
sudo mysql -u root -p -e "CREATE DATABASE IF NOT EXISTS employees;"
employeesテーブルを作成してください:
sudo mysql -u root -p employees << 'EOF'
CREATE TABLE IF NOT EXISTS employees (
    emp_no INT NOT NULL AUTO_INCREMENT,
    birth_date DATE NOT NULL,
    first_name VARCHAR(14) NOT NULL,
    last_name VARCHAR(16) NOT NULL,
    gender ENUM('M','F') NOT NULL,
    hire_date DATE NOT NULL,
    PRIMARY KEY (emp_no)
);

INSERT INTO employees (emp_no, birth_date, first_name, last_name, gender, hire_date) VALUES
(10001, '1953-09-02', 'Georgi', 'Facello', 'M', '1984-06-02'),
(10002, '1964-06-02', 'Bezalel', 'Simmel', 'F', '1984-11-21'),
(10003, '1959-12-03', 'Parto', 'Bamford', 'M', '1984-08-28'),
(10004, '1954-05-01', 'Chirstian', 'Koblick', 'M', '1984-12-01'),
(10005, '1955-01-21', 'Kyoichi', 'Maliniak', 'M', '1984-09-15'),
(10006, '1953-04-20', 'Anneke', 'Preusig', 'F', '1985-02-18'),
(10007, '1957-05-23', 'Tzvetan', 'Zielinski', 'F', '1985-03-20'),
(10008, '1958-02-19', 'Saniya', 'Kalloufi', 'M', '1984-07-11'),
(10009, '1952-04-19', 'Sumant', 'Peac', 'F', '1985-02-18'),
(10010, '1963-06-01', 'Duangkaew', 'Piveteau', 'F', '1984-08-24');
EOF
salariesテーブルを作成してください:
sudo mysql -u root -p employees << 'EOF'
CREATE TABLE IF NOT EXISTS salaries (
    emp_no INT NOT NULL,
    salary INT NOT NULL,
    from_date DATE NOT NULL,
    to_date DATE NOT NULL,
    PRIMARY KEY (emp_no, from_date),
    FOREIGN KEY (emp_no) REFERENCES employees(emp_no) ON DELETE CASCADE
);

INSERT INTO salaries (emp_no, salary, from_date, to_date) VALUES
(10001, 60117, '1984-06-02', '1985-06-02'),
(10001, 62102, '1985-06-02', '1986-06-02'),
(10001, 66074, '1986-06-02', '9999-01-01'),
(10002, 65828, '1984-11-21', '1985-11-21'),
(10002, 65909, '1985-11-21', '9999-01-01'),
(10003, 40006, '1984-08-28', '1985-08-28'),
(10003, 43616, '1985-08-28', '9999-01-01'),
(10004, 40054, '1984-12-01', '1985-12-01'),
(10004, 42283, '1985-12-01', '9999-01-01'),
(10005, 78228, '1984-09-15', '1985-09-15'),
(10005, 82507, '1985-09-15', '9999-01-01'),
(10006, 40000, '1985-02-18', '1986-02-18'),
(10006, 43548, '1986-02-18', '9999-01-01'),
(10007, 56724, '1985-03-20', '1986-03-20'),
(10007, 60605, '1986-03-20', '9999-01-01'),
(10008, 46671, '1984-07-11', '1985-07-11'),
(10008, 48584, '1985-07-11', '9999-01-01'),
(10009, 60929, '1985-02-18', '1986-02-18'),
(10009, 64604, '1986-02-18', '9999-01-01'),
(10010, 72488, '1984-08-24', '1985-08-24'),
(10010, 74057, '1985-08-24', '9999-01-01');
EOF
より複雑な結合のために、departments テーブルを作成します:
sudo mysql -u root -p employees << 'EOF'
CREATE TABLE IF NOT EXISTS departments (
    dept_no CHAR(4) NOT NULL,
    dept_name VARCHAR(40) NOT NULL,
    PRIMARY KEY (dept_no),
    UNIQUE KEY (dept_name)
);

INSERT INTO departments (dept_no, dept_name) VALUES
('d001', 'Marketing'),
('d002', 'Finance'),
('d003', 'Human Resources'),
('d004', 'Production'),
('d005', 'Development'),
('d006', 'Quality Management');
EOF
employeesとdepartmentsをリンクするためにdept_empテーブルを作成する:
sudo mysql -u root -p employees << 'EOF'
CREATE TABLE IF NOT EXISTS dept_emp (
    emp_no INT NOT NULL,
    dept_no CHAR(4) NOT NULL,
    from_date DATE NOT NULL,
    to_date DATE NOT NULL,
    PRIMARY KEY (emp_no, dept_no),
    FOREIGN KEY (emp_no) REFERENCES employees(emp_no) ON DELETE CASCADE,
    FOREIGN KEY (dept_no) REFERENCES departments(dept_no) ON DELETE CASCADE
);

INSERT INTO dept_emp (emp_no, dept_no, from_date, to_date) VALUES
(10001, 'd005', '1984-06-02', '9999-01-01'),
(10002, 'd005', '1984-11-21', '9999-01-01'),
(10003, 'd004', '1984-08-28', '9999-01-01'),
(10004, 'd004', '1984-12-01', '9999-01-01'),
(10005, 'd003', '1984-09-15', '9999-01-01'),
(10006, 'd005', '1985-02-18', '9999-01-01'),
(10007, 'd004', '1985-03-20', '9999-01-01'),
(10008, 'd005', '1984-07-11', '9999-01-01'),
(10009, 'd006', '1985-02-18', '9999-01-01'),
(10010, 'd006', '1984-08-24', '9999-01-01');
EOF
すべてが正しく設定されていることを確認してください:
sudo mysql -u root -p -e "USE employees; SHOW TABLES;"
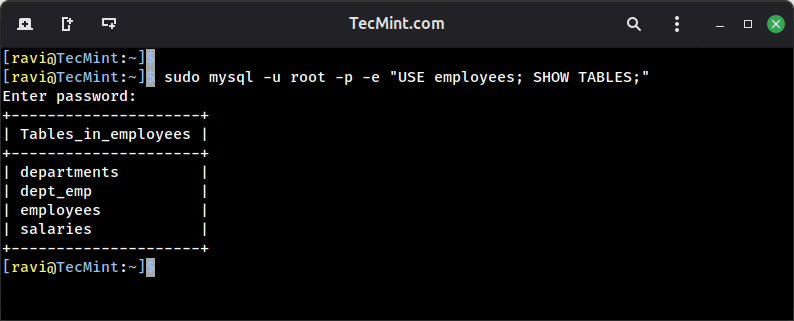
これで両方のデータベースにサンプルデータが設定され、ガイドのすべての例に従うことができるようになりました。tecmintdbデータベースは簡単なクエリに最適で、employeesデータベースはジョインや集計など、より複雑な操作を練習するのに適しています。
基本的なクエリ実行
サーバー上のすべてのデータベースを表示するには、次のコマンドを実行できます。
sudo mysql -u root -p -e "show databases;"
次に、データベース tecmintdb に tutorials という名前のデータベーステーブルを作成するには、以下のコマンドを実行します:
sudo mysql -u root -p -e "USE tecmintdb; CREATE TABLE tutorials(tut_id INT NOT NULL AUTO_INCREMENT, tut_title VARCHAR(100) NOT NULL, tut_author VARCHAR(40) NOT NULL, submissoin_date DATE, PRIMARY KEY (tut_id));"
MySQL クエリ結果をファイルに保存する
次のコマンドを使用し、その出力を tee コマンドにパイプし、その後に出力を保存したいファイル名を指定します。
例として、データベース employees と、employees テーブルと salaries テーブルの簡単な結合を使用します。ご自身の場合は、引用符の間に SQL クエリを入力して Enter キーを押してください。
データベースユーザーのパスワードを入力するよう求められることに注意してください:
sudo mysql -u root -p -e "USE employees; SELECT DISTINCT A.first_name, A.last_name FROM employees A JOIN salaries B ON A.emp_no = B.emp_no WHERE hire_date < '1985-01-31';" | tee queryresults.txt
catコマンドを使ってクエリ結果を表示します。
cat queryresults.txt
コマンドラインからMySQL/MariaDBのクエリを実行する
クエリの結果をプレーンテキストファイルで取得すれば、他のコマンドラインユーティリティを使ってレコードをより簡単に処理できます。基本を確認したところで、コマンドラインデータベースの作業をさらに効率的にする、いくつかのより高度なテクニックを見ていきましょう。
出力の書式設定で可読性を向上させる
デフォルトのテーブル形式はターミナルで表示するのに適していますが、場合によっては異なる形式が必要になることがあります。縦型形式で結果を出力することもでき、多くの列を持つテーブルを扱う際に特に便利です:
sudo mysql -u root -p -e "USE employees; SELECT * FROM employees LIMIT 1\G"
末尾の \G は各行を表ではなく縦に表示するので、窮屈な横向きの表を見る代わりに、次のようなものが得られます:
*************************** 1. row ***************************
    emp_no: 10001
birth_date: 1953-09-02
first_name: Georgi
 last_name: Facello
    gender: M
 hire_date: 1984-06-02
CSV形式にエクスポート
クエリ結果をスプレッドシートアプリケーションやその他のツールにインポートする必要がある場合、CSV形式が最適です:
sudo mysql -u root -p -e "USE employees; SELECT first_name, last_name, hire_date FROM employees WHERE hire_date < '1985-01-31';" | sed 's/\t/,/g' > employees.csv
これは出力を sed に通してタブをコンマに置き換え、Excel、LibreOffice Calc、またはその他の任意の表計算ソフトで問題なく開ける適切な CSV ファイルを作成します。
パスワードのプロンプトなしでクエリを実行する
もし cron ジョブやスクリプトでデータベースのタスクを自動化している場合、毎回パスワードを手動で入力したくないでしょう。そこで MySQL の設定ファイルが役立ちます。
あなたの認証情報を使って ~/.my.cnf にファイルを作成してください:
[client]
user=root
password=your_password_here
それから、それをあなただけが読めるように保護してください:
chmod 600 ~/.my.cnf
これで、-p フラグを使わず、プロンプトも表示されずにクエリを実行できるようになりました:
mysql -e "SHOW DATABASES;"
覚えておいてください、パスワードをプレーンテキストのファイルに保存することにはセキュリティ上の影響がありますので、アクセスを管理できるサーバーでのみこの方法を使用し、運用環境ではMySQLのより安全な認証方法の使用を検討してください。
複雑な複数行クエリの実行
複数の結合、サブクエリ、または複雑な条件を扱う場合、クエリは単一のコマンドラインで書くにはあまりにも複雑になることがあります。
SQL をファイルに入れて実行することができます:
cat > complex_query.sql << 'EOF'
USE employees;
SELECT
    e.first_name,
    e.last_name,
    d.dept_name,
    s.salary
FROM employees e
INNER JOIN dept_emp de ON e.emp_no = de.emp_no
INNER JOIN departments d ON de.dept_no = d.dept_no
INNER JOIN salaries s ON e.emp_no = s.emp_no
WHERE e.hire_date BETWEEN '1985-01-01' AND '1985-12-31'
    AND s.from_date = (
        SELECT MAX(from_date)
        FROM salaries
        WHERE emp_no = e.emp_no
    )
ORDER BY s.salary DESC
LIMIT 10;
EOF
さあ実行しろ。
sudo mysql -u root -p < complex_query.sql > top_earners_1985.txt
このアプローチは、クエリを整理して再利用可能に保ち、他のコードと同じようにgitでバージョン管理することができます。
複数のクエリを一括処理
複数の関連するクエリを実行し、それぞれの結果を別々に保存する必要がある場合は、スクリプトで実行できます:
#!/bin/bash

QUERIES=(
    "SELECT COUNT(*) as total_employees FROM employees"
    "SELECT dept_name, COUNT(*) as employee_count FROM dept_emp de JOIN departments d ON de.dept_no = d.dept_no GROUP BY dept_name"
    "SELECT YEAR(hire_date) as year, COUNT(*) as hires FROM employees GROUP BY YEAR(hire_date) ORDER BY year"
)

FILENAMES=(
    "total_count.txt"
    "dept_distribution.txt"
    "yearly_hires.txt"
)

for i in "${!QUERIES[@]}"; do
    echo "Running query $((i+1))..."
    mysql -u root -p -e "USE employees; ${QUERIES[$i]}" > "${FILENAMES[$i]}"
    echo "Results saved to ${FILENAMES[$i]}"
done
これをスクリプトとして保存し、chmod +xで実行可能にすれば、再利用可能なバッチクエリツールが手に入ります。
長時間実行されているクエリの監視
時間がかかる可能性のあるクエリを実行しているときは、進行状況を確認したり、少なくともまだ動作していることを知りたいものです。
クエリをステータス出力と組み合わせる:
(sudo mysql -u root -p -e "USE employees; SELECT COUNT(*) FROM large_table WHERE complex_condition;" && echo "Query completed at $(date)") | tee query_log.txt
より長いクエリの場合は、バックグラウンドで実行し、MySQLのプロセスリストを監視してください:
sudo mysql -u root -p -e "USE employees; SELECT * FROM massive_table;" > output.txt &
sudo watch -n 5 'mysql -u root -p -e "SHOW PROCESSLIST\G" | grep -A 5 "SELECT"'
これは、クエリをバックグラウンドで実行しながら、5秒ごとにプロセスリストを表示するので、まだ動作していることや、どれくらい進んでいるかを確認できます。
結果のフィルタリングと処理
クエリ結果をテキストファイルに取得したら、標準のLinuxツールを使ってさらに処理することができます。ここにいくつかの便利なパターンを示します。
結果行の数を数える(ヘッダーを除く):
tail -n +2 queryresults.txt | wc -l
awkを使って特定の列を抽出する:
awk '{print $1, $3}' queryresults.txt
結果の中で特定のパターンを検索する:
grep -i "engineering" dept_distribution.txt
数値列で結果を並べ替える:
tail -n +2 queryresults.txt | sort -k3 -n
特殊文字および大規模データセットの扱い
データに特殊文字、タブ、または改行が含まれている場合、デフォルトの出力は乱雑になることがあるため、よりきれいな出力のために--batchおよび--rawオプションを使用してください:
sudo mysql -u root -p --batch --raw -e "SELECT description FROM products WHERE category='electronics';" > products.txt
数百万行を返すクエリの場合、すべてをメモリに読み込むのではなく、結果をストリーム処理することでメモリの問題に直面する可能性があります:
sudo mysql -u root -p --quick -e "SELECT * FROM huge_table;" | gzip > huge_results.txt.gz
--quick オプションは MySQL に対して、結果セット全体をバッファせずに行を1つずつ取得するよう指示し、gzip を通してパイプ処理することで出力をリアルタイムに圧縮し、ディスクスペースを節約します。
迅速なデータベースバックアップの作成
これは厳密にはクエリを実行しているわけではありませんが、mysqldump コマンドを使って迅速なデータベースダンプを作成するために、同様のコマンドライン技術を使用することができます。
sudo mysqldump -u root -p employees | gzip > employees_backup_$(date +%Y%m%d).sql.gz
または特定のテーブルだけをバックアップする:
sudo mysqldump -u root -p employees employees salaries | gzip > critical_tables_$(date +%Y%m%d).sql.gz
自動レポートのスケジューリング
これまでにカバーしたすべてを組み合わせて、次の bash スクリプトを用いて cron を使った自動の日次レポートを作成します。
#!/bin/bash
REPORT_DATE=$(date +%Y-%m-%d)
REPORT_FILE="/var/reports/daily_stats_${REPORT_DATE}.txt"

{
    echo "Database Statistics Report - ${REPORT_DATE}"
    echo "=========================================="
    echo

    echo "Total Employees:"
    mysql -e "USE employees; SELECT COUNT(*) FROM employees;"
    echo

    echo "New Hires This Month:"
    mysql -e "USE employees; SELECT COUNT(*) FROM employees WHERE MONTH(hire_date) = MONTH(CURRENT_DATE()) AND YEAR(hire_date) = YEAR(CURRENT_DATE());"
    echo

    echo "Department Distribution:"
    mysql -e "USE employees; SELECT d.dept_name, COUNT(*) as count FROM dept_emp de JOIN departments d ON de.dept_no = d.dept_no WHERE de.to_date = '9999-01-01' GROUP BY d.dept_name ORDER BY count DESC;"

} > "$REPORT_FILE"

echo "Report generated: $REPORT_FILE"
毎日午前6時に実行するようにcronに追加してください:
0 6 * * * /usr/local/bin/generate_db_report.sh
要約
システム管理者として、日常のLinux作業を自動化したり、より簡単に実行する際に役立つかもしれないいくつかのLinuxのヒントを共有しました。
ここでの重要なポイントは、データベースを扱うために必ずしもMySQLシェルを起動したり、重いGUIツールを使う必要はないということです。コマンドラインは速度、オートメーション機能、既存のシェルスクリプトやワークフローにデータベース操作を統合する能力を提供します。
他のコミュニティの皆さんと共有したい他のヒントはありますか?もしあれば、以下のコメントフォームを使って共有してください。