分類における勾配ブースティング:もうブラックボックスではない!

紹介
機械学習アルゴリズムは、精度を向上させるために、モデルを適合させ予測を行うだけでは不十分です。業界やコンペティションでの勝ち取ったモデルの多くは、より良いパフォーマンスを発揮するためにアンサンブルテクニックや特徴エンジニアリングを使用しています。
特にアンサンブル手法は、特徴量エンジニアリングに比べて使いやすさから人気を得ています。高度な機械学習アルゴリズムと併用することで精度を向上させることが証明されている複数のアンサンブル手法があります。その一つが勾配ブースティングです。勾配ブースティングはしばしばブラックボックスのように語られますが、この記事では勾配ブースティングの秘密を段階的に、直感的かつ広範に解き明かしていきますので、どのように機能するのかを本当に理解できるでしょう。
この記事では、以下のトピックについて説明します:
- 勾配ブースティングとは何ですか?
分類における勾配ブースティング
- 直感的理解: 勾配ブースティングの可視化
- 数学的理解
前提条件
- 機械学習の基本知識: 特に分類タスクにおける教師あり学習についての理解。
- 決定木の理解: 決定木に関する知識は、勾配ブースティングが弱学習器、通常は決定木の上に構築されるため、重要です。
- アンサンブル法の概念: 複数のモデルを組み合わせてパフォーマンスを向上させるバギングやブースティングなどのアンサンブル技術の理解。
- 数学: 最適化と勾配降下法のプロセスを理解するためには、微積分(微分)と線形代数(ベクトルと行列)の基本的な理解が役立ちます。
- Pythonプログラミング: グラデーションブースティングアルゴリズムを実装するために、PythonとScikit-Learnのような一般的なMLライブラリに精通していること。
勾配ブースティングとは何ですか?
まずはアンサンブル学習について簡単に振り返りましょう。名前が示すように、アンサンブル学習は「弱い」モデルの集合(または「アンサンブル」)を用いて強力なモデルを構築することを含みます。勾配ブースティングは、各弱学習者から反復的に学習して強力なモデルを構築するブースティング手法のカテゴリーに分類されます。それは最適化できます:
- 回帰
- 分類
- ランキング
この記事の範囲は特に分類に限られます。
ブースティングのアイデアは、弱学習器が改良されてより良くなる可能性があるという直感に基づいています。AdaBoostは最初のブースティングアルゴリズムでした。AdaBoostおよび関連するアルゴリズムは、1997年にレオ・ブレイマンによって統計の枠組みで初めて位置づけられ、これはジェローム・H・フリードマンのような他の研究者が回帰のための勾配ブースティングアルゴリズムの開発にこの成果を修正するための基礎を築きました。その後、多くの研究者が回帰や分類における初期の応用をはるかに超えて、機械学習や統計学の他の多くの分野のためにこのブースティングアルゴリズムを開発しました。
グラデーションブースティングにおける「勾配」という用語は、同じ関数の二つ以上の導関数が存在することを指します(これについては後で詳しく説明します)。グラデーションブースティングは、反復的関数勾配アルゴリズムです。つまり、負の勾配を指す関数を反復的に選択することによって損失関数を最小化するアルゴリズムであり、弱い仮説に基づいています。
分類における勾配ブースティング
これまでの数年間、勾配ブースティングはさまざまな技術分野での応用が見出されています。このアルゴリズムは最初は複雑に見えるかもしれませんが、ほとんどの場合、分類用に1つの事前定義された設定と回帰用に1つの設定を使用するだけであり、もちろん、必要に応じて変更できます。この記事では、分類問題における勾配ブースティングに焦点を当てます。アルゴリズムが裏でどのように機能しているかを、直感的かつ数学的に見ていきましょう。
勾配ブースティングには三つの主要な要素があります。
- 損失関数 - 損失関数の役割は、与えられたデータを使ってモデルがどれだけ良い予測をしているかを推定することです。これは問題の内容によって異なる場合があります。例えば、ある入力変数に基づいて人の体重を予測しようとしている場合(回帰問題)、損失関数は予測された体重と観測された体重の違いを見つけるのに役立つものとなります。一方で、人の性格に基づいて特定の映画を気に入るかどうかを分類しようとしている場合は、特定の映画を気に入った人とそうでない人を分類する際のモデルの精度を理解するために必要な損失関数が求められます。
- 弱い学習者 - 弱い学習者とは、データを分類するが、ランダムな推測と同じくらいの精度で行うものです。言い換えれば、高いエラー率を持っています。これらは通常、決定木(典型的な決定木よりも簡単なため、決定ストンプとも呼ばれます)です。
- 加法モデル - これは、木(弱学習器)を一度に一つずつ追加する反復的かつ逐次的なアプローチです。各反復の後、私たちは最終モデルに近づく必要があります。言い換えれば、各反復は私たちの損失関数の値を減少させるべきです。
直感的理解: グラディエントブーストの可視化
最初に、最も一般的な二項分類の機械学習問題の1つを見ていきましょう。それは、搭乗者の年齢、性別などのいくつかの特徴に基づいて、タイタニック号の乗客の運命を予測することを目的としています。便利のために、データセットの一部のみを取得し、特定の列を選択します。私たちのデータセットは次のようなものです:

タイタニック乗客データ
- Pclass(乗客クラス)とは、カテゴリカルで、1、2、または3です。
- 年齢は、乗客がタイタニックに乗っていた時の年齢です。
- 運賃は乗客の運賃です。
- 性はその人の性別です。
- 生存したは、その人が事故を生き残ったかどうかを示します。生き残っていない場合は0、生き残った場合は1です。
では、Gradient Boostingアルゴリズムがこの問題をどのように解決するか見てみましょう。
私たちは、すべての乗客の初期値を予測する1つの葉ノードから始めます。分類問題の場合、それはターゲット値の対数オッズになります。対数オッズは、分類問題における平均値に相当します。この場合、4人の乗客が生存し、2人が生存しなかったので、乗客が生存する対数オッズは次のようになります:


これが私たちの最初の葉になります。

初期リーフノード
分類のためにオッズの対数を使用する最も簡単な方法は、それを確率に変換することです。そのために、次の式を使用します:

注意: ここではすべてを小数点以下1桁に丸めましたので、log(オッズ)と確率は同じですが、常にそうであるわけではありません。
生存する確率が0.5より大きい場合、まずトレーニングデータセット内の全員を生存者として分類します。(0.5は、確率に基づいて行われる分類決定のための一般的なしきい値です。しきい値は他の値に設定することも簡単にできます。)
さて、擬似残差、すなわち観測値と予測値の差を計算する必要があります。残差をグラフに描いてみましょう。

青い点と黄色い点は観測された値です。青い点は生存しなかった乗客で、確率は0、黄色い点は生存した乗客で、確率は1です。ここにある点線は、予測された確率0.7を示しています。
残余を見つける必要があります。それは:


ここでは、1は「はい」を、0は「いいえ」を示します。
私たちはこの残差を使って次の木を得るつもりです。実際の値ではなく残差を考慮しているのは馬鹿げているように思えるかもしれませんが、先にもっと明確に説明します。

残差値を使用してデータポイントを分岐させる
ここでは例を簡素化するために2つの葉の制限を使用していますが、実際にはグラデーショントーストは8葉から32葉の範囲です。
葉の制限のため、1つの葉には複数の値が存在する可能性があります。予測は対数オッズの形で表現されますが、これらの葉は確率から導かれているため、ばらつきが生じます。したがって、以前得た単一の葉とこの木を単純に加えたところで新しい予測を得ることはできません。なぜなら、それらは異なるソースから導かれているからです。何らかの変換を使用する必要があります。分類用の勾配ブーストで使用される最も一般的な変換形式は次のとおりです :

この方程式の分子はその特定の葉における残差の合計です。
分母は、(各残差の前回予測確率)*(同じ前回予測確率の1 - )の合計です。
この式の導出はこの記事の数学のセクションで説明される予定です。
今は、まずその公式を実践してみましょう。
最初の葉は残存値が0.3だけであり、これは最初の木であるため、前の確率は初期の葉からの値となり、したがって、すべての残差に対して同じです。従って、

2枚目の葉のために、

同様に、最後の葉について:

今、変形した木は次のようになっています。

変形された木
これで変換が完了したので、学習率を使って新しい木に初期リードを追加することができます。

学習率は新しい木からの寄与をスケーリングするために使用されます。これにより、予測の正しい方向への小さなステップが得られます。経験的な証拠は、正しい方向に多くの小さなステップを踏むことで、モデルが一度も見たことのないテストデータセットに対してより良い予測が得られることを示しています。つまり、1回目のステップでの完璧な予測と比べてです。学習率は通常、0.1のような小さな数です。
私たちは今、新しいログオッズの予測を計算することができ、それによって新しい確率を得ることができます。
例えば、最初の乗客の場合、古い木は0.7です。すべてのレコードに対して同じである学習率は0.1に等しく、新しい木のスケーリングにより、その値が-0.16であることがわかります。したがって、公式に代入すると、次のようになります:

同様に、私たちは置き換えを行い、各乗客の新しいログ(オッズ)を見つけ、その結果として確率を求めます。新しい確率を使用して、新しい残差を計算します。
このプロセスは、指定された最大数の木を作成するか、残差が非常に小さくなるまで繰り返されます。
数学的理解
グラデーションブースティングアルゴリズムが分類問題においてどのように機能するかを理解したので、直感的には、前のセクションで残した多くの空白を埋めることが重要になるでしょう。これは、プロセスを数学的に理解することで可能になります。
私たちは一歩一歩進んで、それぞれを理解するように努めます。

xi - これは私たちのモデルに入力する変数です。
これは、私たちが予測しようとしている対象変数です。
予測された確率に基づいてデータの対数尤度を予測することができます。

yi は観測値です (0 または 1)。
pは予測された確率です。
目標は対数尤度関数を最大化することです。したがって、より小さな値がより良いフィッティングモデルを表す場合、私たちの損失関数としてlog(likelihood)を使用するならば:

現在、対数尤度は予測確率 p の関数ですが、予測対数オッズの関数にする必要があります。では、式を変換してみましょう:

私たちは知っています:

置き換え,

さて、
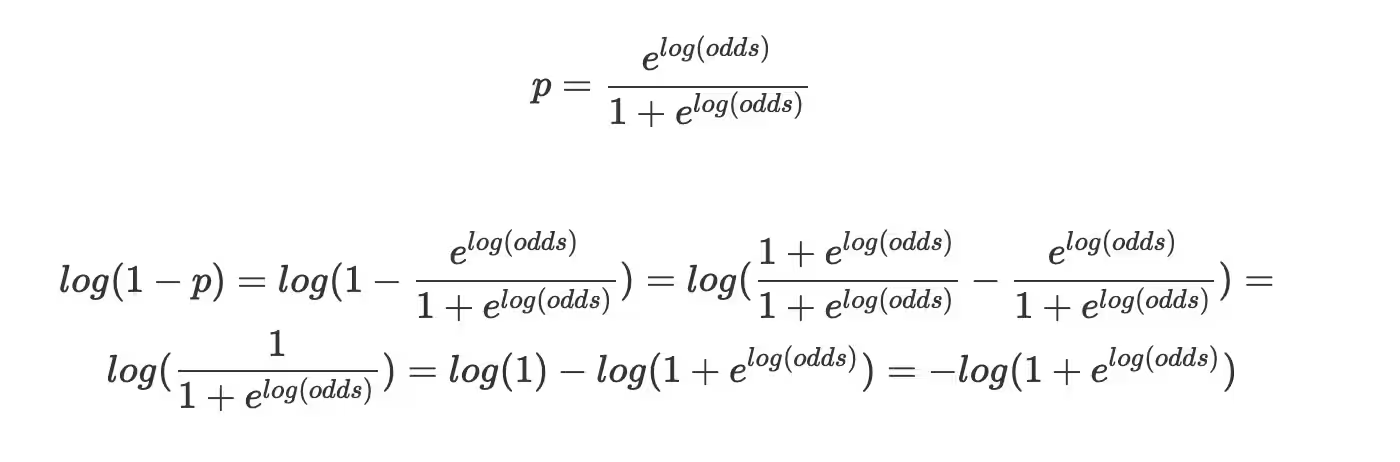
したがって、

pをlog(odds)に変換したので、これは私たちの損失関数になります。
これが微分可能であることを示さなければなりません。

これは次のようにも書くことができます :

これで、モデル構築の実際のステップに進むことができます。
ステップ1: 定数値でモデルを初期化する

ここで、yiは観察された値、Lは損失関数、そしてガンマはlog(odds)の値です。
私たちは損失関数を合計しています。つまり、観測値ごとに損失関数を合計します。
ガンマに対するargminは、この合計を最小化する対数オッズ値を見つける必要があることを意味します。
それから、各損失関数の導関数を取ります:

…とそのように。
ステップ2: m=1 から M まで
(A)

このステップでは、与えられた式を使って残差を計算する必要があります。私たちはすでに損失関数が次のように見つかったことを示しました:

したがって、

(B) 残差値に回帰木を適合させ、終端領域を作成する

枝に葉が限られているため、特定の終端領域に複数の値が存在するかもしれません。
最初の木では、m=1で、jは各終端ノードのユニークな番号になります。したがって、R11、R21などになります。
©

新しい木の各葉に対して、出力値であるガンマを計算します。合計は、その葉を作るために使用されるレコードのみに対して行われるべきです。理論的には、ガンマに関する導関数を求めることでガンマの値を取得することができますが、損失関数に含まれる重い変数のために非常に面倒になる可能性があります。
上記の式に損失関数を代入し、i=1とすると、次のようになります:

この損失関数を近似するために、二次テイラー多項式を使用します。

私たちの近似には3つの項があります。ガンマに関して微分を取ると、次のようになります:
これを0に等しくして、両辺から単一の導関数項を引きます。
次に、ガンマは次のようになります:
ガンマ方程式は巨大に見えるかもしれませんが、簡単に言うと次のようになります:

損失関数の導関数の値をそのまま代入します。

さて、損失関数の二次導関数を求めましょう。いくつかの重い計算の後、私たちは次のようになります。

私たちは分子と分母の両方を簡素化しました。最終的なガンマ解は次のようになります:

私たちは、最新の予測されたログオッズに加えたときに損失関数を最小化するガンマの値を見つけようとしていました。このガンマは、終端領域に残差値が1つだけあり、したがって予測確率が1つだけのときに機能します。しかし、グラデイエントブースティングの制限されたリーフからの例を思い出してほしいのですが、1つの終端領域に多くの値がある可能性があります。その場合、一般化された式は以下のようになります:

したがって、私たちは木の各葉の出力値を計算しました。
(D)

この式は、私たちに予測を更新するよう求めています。最初のパスでは、m=1となり、すべてのサンプルに対する共通の予測であるF0(x)、すなわち初期の葉の値に学習率nuを加えたものを、以前に構築した木からの出力値に代入します。総和は、単一のサンプルが複数の葉に分かれる場合を考慮しています。
今、私たちはこの新しい F1(x) 値を使用して、各サンプルに対する新しい予測を取得します。
新しく予測された値は、実際の値に少し近づけるはずです。私たちの考慮事項の一つである単一の木とは対照的に、勾配ブースティングは多くの木を構築し、Mは100またはそれ以上になる可能性があります。
これでステップ2のforループは完了し、勾配ブースティングの最終ステップの準備が整いました。
ステップ3:出力

新しいデータが得られた場合、この値を使用して乗客が生存したかどうかを予測します。これにより、その人が生存したログ(オッズ)を得ることができます。それを'p'の式に代入します:

結果の値が私たちの閾値を上回る場合、その人は生存しました。そうでなければ、生存しませんでした。
Pythonを使用した勾配ブースティングの実装
私たちはKaggleで利用可能な完全なタイタニックデータセットを使用します。このデータセットは、私たちの便宜のためにすでにトレーニングセットとテストセットに分けられています。
最初のステップは、プロセスに必要なライブラリをインポートすることです。
import pandas as pd
from sklearn.ensemble import GradientBoostingClassifier
import numpy as np
from sklearn import metrics
次に、トレーニングデータとテストデータをロードします。
train = pd.read_csv("train.csv")
test= pd.read_csv("test.csv")
各列のデータ型を出力しましょう
train.info(), test.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 891 entries, 0 to 890
Data columns (total 12 columns):
PassengerId    891 non-null int64
Survived       891 non-null int64
Pclass         891 non-null int64
Name           891 non-null object
Sex            891 non-null object
Age            714 non-null float64
SibSp          891 non-null int64
Parch          891 non-null int64
Ticket         891 non-null object
Fare           891 non-null float64
Cabin          204 non-null object
Embarked       889 non-null object
dtypes: float64(2), int64(5), object(5)
memory usage: 83.6+ KB
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 418 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    418 non-null int64
Pclass         418 non-null int64
Name           418 non-null object
Sex            418 non-null object
Age            332 non-null float64
SibSp          418 non-null int64
Parch          418 non-null int64
Ticket         418 non-null object
Fare           417 non-null float64
Cabin          91 non-null object
Embarked       418 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 36.0+ KB
PassengerIDをインデックスとして設定する
set "PassengerId" variable as index
train.set_index("PassengerId", inplace=True)
test.set_index("PassengerId", inplace=True)
トレーニングターゲットセットとトレーニング入力セットを生成し、その形状を確認します。「Survived」列以外のすべての変数は入力変数または特徴量になり、「Survived」列だけが我々のターゲット変数になります。なぜなら、乗客が生存したかどうかを予測するために乗客の情報に基づいているからです。
トレーニングデータセットとテストデータセットを結合して、train_testデータセットを作成します。
train_test = train.append(test)
次のステップは、データをモデルに投入する前に前処理を行うことです。
私たちは次の前処理を行います:
- 「名前」、「年齢」、「兄弟/配偶者の数」、「チケット」、「キャビン」、「親子の数」の列を削除してください。
- pandas.get_dummiesを使ってオブジェクトを数値に変換します。
- 欠損値を0.0で埋めるか、カテゴリ変数の場合は最も一般的な値で埋めてください。
- MinMaxScaler()メソッドでデータを変換します。
- 訓練セットをランダムに分割して訓練用サブセットと検証用サブセットを作成します。
delete columns that are not used as features for training and prediction
columns_to_drop = ["Name", "Age", "SibSp", "Ticket", "Cabin", "Parch"]
train_test.drop(labels=columns_to_drop, axis=1, inplace=True)
train_test_dummies = pd.get_dummies(train_test, columns=["Sex"])
train_test_dummies.shape
データの欠損値を確認してください:
train_test_dummies.isna().sum().sort_values(ascending=False)
Embarked      2
Fare          1
Sex_male      0
Sex_female    0
Pclass        0
dtype: int64
これらの欠損値を処理しましょう。「Embarked」については、最も頻繁に出現する値で埋めてからダミー変数を作成し、「Fare」については、0で埋めます。
train_test_dummies['Embarked'].value_counts()
train_test_dummies['Embarked'].fillna('S',inplace=True) # most common
train_test_dummies['Embarked_S'] = train_test_dummies['Embarked'].map(lambda i: 1 if i=='S' else 0)
train_test_dummies['Embarked_C'] = train_test_dummies['Embarked'].map(lambda i: 1 if i=='C' else 0)
train_test_dummies['Embarked_Q'] = train_test_dummies['Embarked'].map(lambda i: 1 if i=='Q' else 0)
train_test_dummies.drop(['Embarked'],axis=1,inplace=True)
train_test_dummies.fillna(value=0.0, inplace=True)
欠損値をすべて処理したかどうかを確認するための最後の確認です。
train_test_dummies.isna().sum().sort_values(ascending=False)
Embarked_Q    0
Embarked_C    0
Embarked_S    0
Sex_male      0
Sex_female    0
Fare          0
Pclass        0
dtype: int64
すべての欠損値が処理されているようです。
以前、私たちはターゲットセットを生成しました。今、私たちは特徴セット/入力セットを生成します。
X_train = train_test_dummies.values[0:891]
X_test = train_test_dummies.values[891:]
モデルを適合させる前に、もう一つの最後のステップの時です。それは、データを変換してすべてを特定のスケールに合わせることです。
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
X_train_scale = scaler.fit_transform(X_train)
X_test_scale = scaler.transform(X_test)
私たちは今、データセットをトレーニングとテストに分割しなければなりません。トレーニングはモデルを訓練するため、テストはモデルがデータセットにどれだけ適合しているかを確認するためです。
from sklearn.model_selection import train_test_split
X_train_sub, X_validation_sub, y_train_sub, y_validation_sub = train_test_split(X_train_scale, y_train, random_state=0)
今、我々は勾配ブーストアルゴリズムを訓練し、0から1の範囲の異なる学習率で精度を確認します。
learning_rates = [0.05, 0.1, 0.25, 0.5, 0.75, 1]
for learning_rate in learning_rates:
    gb = GradientBoostingClassifier(n_estimators=20, learning_rate = learning_rate, max_features=2, max_depth = 2, random_state = 0)
    gb.fit(X_train_sub, y_train_sub)
    print("Learning rate: ", learning_rate)
    print("Accuracy score (training): {0:.3f}".format(gb.score(X_train_sub, y_train_sub)))
    print("Accuracy score (validation): {0:.3f}".format(gb.score(X_validation_sub, y_validation_sub)))
('Learning rate: ', 0.05)
Accuracy score (training): 0.808
Accuracy score (validation): 0.834
('Learning rate: ', 0.1)
Accuracy score (training): 0.799
Accuracy score (validation): 0.803
('Learning rate: ', 0.25)
Accuracy score (training): 0.811
Accuracy score (validation): 0.803
('Learning rate: ', 0.5)
Accuracy score (training): 0.820
Accuracy score (validation): 0.794
('Learning rate: ', 0.75)
Accuracy score (training): 0.822
Accuracy score (validation): 0.803
('Learning rate: ', 1)
Accuracy score (training): 0.822
Accuracy score (validation): 0.816
これで私たちのコードは完了です。ここで使用されているパラメータについての簡単な説明です。
- n_estimators : 行うブースティングステージの数。勾配ブースティングは過剰適合に対してかなり頑健であるため、大きな数は通常より良いパフォーマンスをもたらします。
- 学習率: 学習率は、各木の寄与を
学習率によって縮小させます。学習率とn_estimatorsの間にはトレードオフがあります。 - max_features : 最良の分割を探す際に考慮する特徴の数。
- max_depth : 個々の回帰推定器の最大深度。最大深度は木のノードの数を制限します。このパラメータを調整して最適な性能を引き出してください; 最適な値は入力変数の相互作用に依存します。
- random_state : random_stateは乱数生成器によって使用されるシードです。
これらのパラメータをハイパーチューニングして、最高の精度を得てください。
AdaBoostと勾配ブーストの比較および対比
AdaBoostとGradient Boostは、弱い学習者のセットから逐次的に学習します。強い学習者は、これらの弱学習者の加法モデルから得られます。ここでの主な焦点は、各反復ステップでの短所から学ぶことです。
AdaBoostはユーザーが一連の弱学習器を指定することを要求します(あるいは、実際の学習プロセスの前に一連の弱学習器をランダムに生成します)。これは、誤って予測されたインスタンスの重みを増加させ、正しく予測されたインスタンスの重みを減少させます。これにより、弱学習器は困難なインスタンスにより集中します。トレーニングを受けた後、弱学習器はそのパフォーマンスに応じて強いものに追加されます(いわゆるアルファ重み)。パフォーマンスが高いほど、強い学習器への貢献も増えます。
一方で、勾配ブースティングはサンプル分布を変更しません。新たにサンプリングされた分布で学習する代わりに、弱い学習者は強い学習者の残りの誤差に基づいて学習します。これは、難しいインスタンスにさらに重要性を持たせる別の方法です。各イテレーションごとに擬似残差が計算され、弱い学習者がこれらの擬似残差に適合させられます。それから、弱い学習者の強い学習者への貢献は、新たに分配されたサンプルでのパフォーマンスに基づいて計算されるのではなく、勾配降下最適化プロセスを使用して計算されます。計算された貢献は、強い学習者の全体的な誤差を最小化するものです。
Adaboostは「投票 重み」に関するものであり、勾配ブースティングは「勾配 最適化の追加」に関するものです。
勾配ブーストの利点と欠点
勾配ブースティングの利点は:
- しばしば打ち負かすことのできない予測精度を提供します。
- 非常に柔軟な機能で、さまざまな損失関数に最適化でき、関数の適合を非常に柔軟にするいくつかのハイパーパラメータ調整オプションを提供します。
- データの前処理は必要ありません - カテゴリカルおよび数値の値でそのままうまく機能することがよくあります。
- 欠損データを処理します - 補完は不要です。
かなり素晴らしいですね?いくつかの欠点も見てみましょう。
- 勾配ブースティングモデルはすべての誤差を最小化するために改善し続けます。これは外れ値を過度に強調し、過剰適合を引き起こす可能性があります。
- 計算コストが高く、しばしば多くの木(1000本以上)を必要とするため、時間とメモリを消費することがあります。
- 高い柔軟性は、アプローチの挙動に大きく影響を与える多くのパラメータ(反復回数、木の深さ、正則化パラメータなど)が相互作用する結果となります。これにより、チューニング中に大規模なグリッドサーチが必要になります。
- 本質的には解釈の余地が少ないですが、これはさまざまなツールで簡単に解決できます。
結論
この記事では、勾配ブースティングアルゴリズムに関する理論的アプローチと実践的アプローチの両方が提案されています。勾配ブースティングは、分類と回帰の両方において予測モデルを構築するための最も強力な手法の一つであることが何度も証明されています。勾配ブースティングアルゴリズムは訓練データセットに容易に過剰適合する可能性があるため、アルゴリズムの性能を向上させ、過剰適合と戦うために、さまざまな制約や正則化手法を利用することができます。ペナルティ付き学習、木の制約、ランダムサンプリング、収縮手法が過剰適合への対抗手段として利用されることがあります。
多くの実生活の機械学習の課題は、勾配ブースティングによって解決されています。
この記事が、あなたに勾配ブースティングを深く探求し、実際の機械学習の問題に適用することを促す助けになったことを願っています。精度を向上させるために!
参考文献
- Scikit-Learnを使用したPythonの勾配ブースティング分類器
- AdaBoostと勾配ブースティングによるブースティング - データサイエンティストの作成…
- グラデーションブースト パート1: 回帰の主なアイデア
- 勾配ブースティングマシン
- AdaBoostと勾配ブースティングによるブースティング - データサイエンティストの作成…
- 3.2.4.3.6. sklearn.ensemble.GradientBoostingRegressor — scikit-learn 0.22.2 ドキュメント
- 回帰問題のための勾配ブースティングの例 | 回帰アルゴリズムの基本
- 勾配ブースティングへの優しい導入
- 勾配ブースティングマシンの理解