深層学習における消失勾配問題:解説

紹介
猫と犬を理解し、区別するための深層学習モデルをトレーニングしたいシナリオを想像してみてください。最初は、物事が期待できるように見えます。モデルはうまく機能し、基本的な形を識別することを学びます。しかし、複雑な特徴を捉えるためにもう少し隠れ層を重ねると、奇妙なことが起こります。ネットワークは訓練がますます難しくなります。精度の曲線は下がり、どれだけ長く訓練してもパラメータを調整しても、モデルは改善されません。
深層学習における根本的な問題は、このイライラするシナリオを引き起こすことがよくあります:消失勾配問題です。バックプロパゲーションが行われて、複数の層を通じて重みを更新する際に、勾配がしばしば指数関数的に縮小し、重みに変化が見られないほど小さくなります。これにより、トレーニングプロセス全体が停滞し、モデルがグローバルミニマを達成することを妨げます。
この記事では、消失勾配問題が何であるか、なぜそれが起こるのか、そして現代のアーキテクチャや活性化関数がそれを緩和するためにどのように設計されているのかを探ります。
前提条件
消失勾配問題に入る前に、深層学習と微 calculusの基本概念をしっかりと理解しておくことが重要です。これらの概念は、問題をよりよく理解するのに役立ちます。
- 順伝播と逆伝播: 予測を行うために、データがニューラルネットワークを通過する方法を理解しておくべきです。また、訓練中に勾配が計算され、逆方向に伝播されて重みを更新するプロセスについても知っておく必要があります。

- 勾配降下法: 勾配降下法のような最適化アルゴリズムが損失関数を最小化するために、モデルのパラメータを反復的に調整する方法に熟知していることは重要です。
- グローバルミニマとローカルミニマ: グローバルミニマ(損失関数の可能な限り低い値)とローカルミニマ(隣接する点よりも低いが、必ずしも全体で最も低いわけではない点)の概念を理解することは、最適化の課題を文脈に置くのに役立ちます。
- 偏微分と微分: 勾配は損失関数に対する各重みの偏微分を使用して計算されるため、微積分と関数の微分方法の基本的な理解が必要です。
- 微分の連鎖律: バックプロパゲーションは、層間の勾配を計算するために連鎖律に大きく依存しており、勾配が消失する仕組みを理解する上でこの法則は重要です。
消失勾配問題とは何ですか?
消失勾配問題に入る前に、まずはいくつかの基本的な概念を理解しようと思います。
深層学習ニューラルネットワークにおける順伝播
フォワードプロパゲーションは、入力データがニューラルネットワークを通過して予測を生成するプロセスです。簡単なニューラルネットワークを仮定しましょう:
- 入力ベクトル x1, x2 を持つ1つの入力層。
- 重み w1、バイアス b1、活性化関数𝛔を持つ1つの隠れ層。
- 重み w2 とバイアス b2 を持つ 1 つの出力層.
- 出力ŷと真のラベルy。
- 損失関数: (平均二乗誤差)
ここで、私たちが話している活性化関数は、特にシグモイド活性化関数です。シグモイド活性化関数は、モデルに非線形性を導入するためにニューラルネットワークで使用される数学的関数です。これは、任意の実数値を取り、0と1の間の値にマッピングするため、確率を出力する必要があるモデルに特に便利です。

前面伝播中、隠れ層で行われる計算は次のとおりです:

出力層の計算:

モデルが出力(ŷとして示される)を生成した後、この予測された値は実際のターゲット値と損失関数を使用して比較され、予測がどれほど間違っているかを計算します。その結果得られる損失は、モデルの誤差を定量化します。この損失は次に最適化器に渡され、モデルの重みが将来の反復で損失を減少させるように調整されます—最終的にはモデルがより良い予測を学習するのを助けます。
そして、この最適化手法が損失関数を減少させる方法は、バックプロパゲーション中に重みを更新することです。
深層ニューラルネットワークにおける逆伝播
逆伝播(「誤差の逆伝播」の略)は、ニューラルネットワークの訓練に使用される重要なアルゴリズムです。このアルゴリズムは、モデルが誤りから学ぶことを可能にし、予測の誤りに基づいて内部パラメータ(重みとバイアス)を調整します。
- 神経ネットワークを想像してください。入力がネットワークを層ごとに通過して出力ŷ(予測)を計算します。
- 予測された出力ŷは、実際のラベルyと損失関数(例えば、MSE、交差エントロピー)を使用して比較され、誤差を計算します。
- 逆伝播 (バックプロパゲーション): ここで魔法が起こる。アルゴリズムは、微積分の連鎖律を用いて、ネットワーク内の各重みに対する損失の勾配を計算する。これらの勾配は、各重みにおける小さな変化が損失にどのように影響するかを示している。
- 重みの更新: 最適化アルゴリズム (例: SGD, Adam) はこれらの勾配を使用して重みを更新します:

どこ :
- wは重さです、
- ηは学習率です,
- l/w は重さに関してのものです。
逆伝播中に、損失関数を減少させ、グローバルミニマムに到達するように重みを更新しようとします。このプロセスは、共有された中間計算を使用して数百万のパラメータに対して効率的に勾配を計算することによって、ディープラーニングを可能にします。
Python コード例(バックプロパゲーションを使用したシンプルなニューラルネットワーク)
import numpy as np

Activation and its derivative
def relu(x):
    return np.maximum(0, x)

def relu_deriv(x):
    return (x > 0).astype(float)

Initialize data and weights
x = np.array([[0.5], [0.3]])        # Input (2,)
y = np.array([[1.0]])               # Target (1,)

W1 = np.random.randn(3, 2)
b1 = np.zeros((3, 1))
W2 = np.random.randn(1, 3)
b2 = np.zeros((1, 1))

Forward pass
z1 = W1 @ x + b1
a1 = relu(z1)
z2 = W2 @ a1 + b2
y_pred = z2
loss = 0.5 * np.square(y - y_pred)

Backpropagation
dL_dy = y_pred - y
dL_dW2 = dL_dy @ a1.T
dL_db2 = dL_dy

dL_da1 = W2.T @ dL_dy
dL_dz1 = dL_da1 * relu_deriv(z1)
dL_dW1 = dL_dz1 @ x.T
dL_db1 = dL_dz1
重みに関する損失の導関数
さて、バックプロパゲーションの間に、チェーンルールを使用してネットワーク内の各重み ∂l/∂w に関する損失関数の勾配を計算します。1つの層についてその数学を見てみましょう:次のようにしましょう:
- xは入力特徴ベクトルである、
- Wは重み行列です。
- バイアスである
- z=Wx + bz,
- α=σ(z) を活性化関数とする(この場合はシグモイド)。
- ŷ=α (単層の例では単純化のために),
- L=(平均二乗誤差)。
次に、重みに対する損失の勾配は次のようになります:
この方程式は、層ごとに勾配を計算するための連鎖法則を表しています。


さて、ここで注目すべき点は、私たちが各層でシグモイド活性化関数を使用しているということです。

なぜ消失勾配が発生するのか?
前にも学んだように、シグモイド活性化関数は0と1の間の値を出力します。しかし、シグモイドの導関数は(0,0.25)の間になります。
シグモイド関数の導関数は、σ′(x)=σ(x)(1−σ(x))で表され、ここでσ(x)はシグモイド関数の出力であり、常に開区間(0, 1)にあります。この表現は、2つの正の数σ(x)と1−σ(x)の積です。この積の最大値は、両方の因子が等しいとき、つまりσ(x)=0.5のときに発生します。この時、導関数はピーク値の0.5⋅(1−0.5)=0.25に達します。他のいかなるσ(x)の値、0に近いか1に近いかの場合、積は小さくなります。したがって、シグモイド関数の導関数は常に正ですが、厳密に0.25以下です。
では、ここで要点を振り返りましょう:
逆伝播中に、損失関数の重み w に関する導関数が次のように計算されます:

∂y/∂z=σ′(z)=σ(z)(1−σ(z))
問題は σ′(z) にあり、これは—見たように—常に ≤ 0.25 であり、z が大きいまたは小さいときに 非常に 0 に近づくことができる。
例、
- x=1.0,
- w=5.0,
- b=0,
- したがって、z=w⋅x+b,
- σ(5) ≈ 0.993、
- σ′(5)=σ(5)⋅(1−σ(5))≈0.993⋅(1−0.993)≈0.0069。
さて、バックプロパゲーション中に:
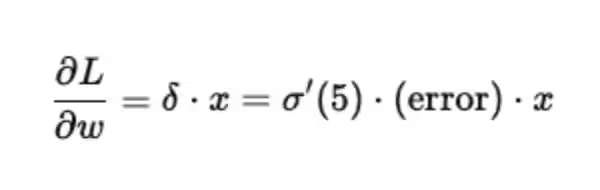
エラーが0.5であると仮定しましょう、次に:

それは数学的に見て非常に小さな勾配です。もし多くの小さな値(例:0.5)が逆伝播中に層を越えて掛け合わされると、結果として勾配は指数関数的に小さくなります。
もし深層ネットワークの各層でこれが起こると、勾配は0.003のような値でどんどん掛け算され、早い段階で以前の層に達する頃にはほとんど無視できるものになる。その結果、それらの初期層は非常に遅く、あるいは全く学習しない—これが消失勾配問題である。
コード例:問題の視覚化
import torch
import torch.nn as nn
import matplotlib.pyplot as plt

Simple deep network
class DeepNet(nn.Module):
    def __init__(self, depth):
        super().__init__()
        self.layers = nn.Sequential(*[
            nn.Linear(100, 100),
            nn.Sigmoid()
        ] * depth)

    def forward(self, x):
        return self.layers(x)

Input and model
x = torch.randn(100)
x.requires_grad = True
model = DeepNet(depth=30)
y = model(x)
y.sum().backward()

Plot gradients
plt.plot(x.grad.detach().numpy())
plt.title("Gradient Flow After 30 Layers")
plt.xlabel("Input Index")
plt.ylabel("Gradient Value")
plt.grid(True)
plt.show()
消失勾配問題への解決策
以前、私たちはシグモイド活性化関数が小さな微分の
反復乗算をもたらし、したがって早期の層での学習プロセスを停滞させる消失勾配問題を引き起こすことを理解しました。
ReLU活性化
さて、この問題を解決するために、研究者たちはReLUとそのバリエーションとして知られる活性化関数を導き出しました。ここにReLU(整流線形ユニット)の概念があります:

これは意味します:
- もしx > 0ならば、f(x)=x
- もし x ≤ 0 ならば f(x)=0
ReLUはどのように消失勾配問題を解決しますか?
ReLU(整流線形単位)活性化関数は、そのシンプルさと効果的であるため、深層学習で広く使用されています。これはf(x)=max(0,x)として定義されており、入力が正の場合はそのまま出力し、そうでない場合はゼロを出力します。このシンプルな関数は、シグモイドやtanh関数でよく発生する勾配消失問題を軽減するのに役立ちます。
ReLUは勾配がネットワークを流れるのを妨げることなく、正の入力に対しては導関数が1であるため、学習が深い層でも効果的に続くことを確保します。しかし、0以下の入力に対しては導関数が0となるため、ニューロンが常に非正の入力を受け取ると完全に更新が止まってしまう「死んだReLU」問題に繋がる可能性があります。
それにもかかわらず、ReLUは計算効率が高く、非線形性を導入することで、ネットワークが複雑な関数をモデル化できるようにします。その限界に対処するために、Leaky ReLUやParametric ReLUのような変種が負の入力に対して小さな勾配を導入し、トレーニング中にニューロンを活性化させ続けるのに役立ちます。
これは消失勾配問題に対処するための効果的なアプローチの一つですが、他にもいくつかの方法があり、今後の記事で詳しく探っていく予定です。
よくある質問
消失勾配問題とは?
それは勾配が小さくなりすぎて、バックプロパゲーション中に初期の層を更新できなくなり、学習が遅くなったり停止したりすることです。
どの活性化関数が消失勾配を引き起こしますか?
シグモイドとtanhです。
消失勾配問題をどのように解決しますか?
ReLU、バッチ正規化、残差接続、適切な初期化を使用してください。
勾配消失と勾配爆発の違いは何ですか?
勾配消失はゼロに近づき、勾配爆発は過度に増大します。
なぜ消失勾配はRNNで問題なのですか?
それは、シーケンスにおける長期依存性の学習を妨げます。
結論
消失勾配問題は、深層ニューラルネットワークを訓練する際の根本的な課題であり、特にシグモイドやtanhのような活性化関数を使用する際に顕著です。逆伝播中に勾配が層ごとに縮小するため、初期の層は効果的に学習することに苦しみ、訓練プロセスが遅くなったり、停止したりします。この問題がどのように発生するか、特に活性化関数および導関数の役割を通じて理解することが、より良いアーキテクチャの設計への第一歩です。幸いなことに、ReLUやそのバリエーションを使用したり、バッチ正規化を実装したり、残差接続を採用したり、賢い重みの初期化戦略を適用するなどの技術が、深層モデルの訓練可能性を大幅に改善しました。これらの解決策を取り入れることで、非常に深いネットワークにおいても、より安定で効率的な学習を保証できます。深層学習が進化し続ける中で、これらの基礎的な問題をマスターすることは、堅牢で高性能なモデルを構築するために不可欠です。
さらなる読み物とリソース
- 深層学習における最適化入門:勾配降下法
- 深層学習における最適化の入門:モメンタム、RMSProp、およびAdam
- 分類における勾配ブースティングの理解:明確なガイド
- 深層学習モデルの評価方法:主要な指標の説明