PyTorchとJAXの比較

紹介
深層学習の分野では、フレームワークの選択が機械学習モデルの効率、柔軟性、パフォーマンスに大きな影響を与える可能性があります。ここ数年、この環境は頻繁に変化しており、TensorFlowのような人気のあるフレームワークは、新しいリリースに対して徐々にその地位を失っています。過去数年の間に、PyTorchとJAXが最も人気のあるフレームワークの中で二つの競争相手として登場し、それぞれが開発者や研究者に独自の利点や能力を提供しています。
FacebookのAI研究所(FAIR)が開発したPyTorchは、そのシンプルなAPI、簡単なデバッグを可能にする動的計算グラフ、および広範なライブラリとツールのエコシステムにより、広く採用されています。PyTorchの柔軟性と使いやすさは、機械学習やAIの実践者にとっての最適な選択肢となっています。
一方、Google ResearchのオープンソースプロジェクトであるJAXは、最近、高性能数値計算のための強力なフレームワークとして人気を集めています。関数型プログラミングの原則と合成可能な変換に基づいて構築されたJAXは、自動微分、ジャストインタイムコンパイル、および並列実行を提供し、特に現代のハードウェアアクセラレーターにおけるスケーラブルで効率的なモデル訓練に適しています。
PyTorchとJAXを比較するための前提条件
- Pythonプログラミングの基本的な理解。
- 深層学習の概念(例:テンソル、神経ネットワーク)に関する知識。
- 少なくとも1つのフレームワーク(例:PyTorchまたはTensorFlow)での実践的な経験。
- 機械学習ワークフローにおけるGPU/TPU加速に関する知識。
彼らの違いは何ですか?
JAXは新しいフレームワークであり、高レベルではPyTorchよりもシンプルで柔軟性があるため、高性能の機械学習コードを作成するのに適しています。NumPyの上に構築されており、その構文は同じ構造に従っているため、人気のある数値計算ライブラリに馴染みのあるユーザーにとっては簡単な選択肢となります。一方、PyTorchはより複雑な構文を持ち、学習曲線が必要です。しかし、PyTorchは密なニューラルネットワークアーキテクチャを構築するための柔軟性が高く、オープンソースプロジェクトでの使用がはるかに普及しています。
JAXとPyTorchのパフォーマンスと速度を比較すると、JAXはGPUやTPUなどのハードウェアアクセラレーターでうまく動作し、特定のシナリオではより高速なパフォーマンスを得られる可能性があります。しかし、PyTorchの長い歴史と大きなコミュニティは、パフォーマンスを最適化するためのより多くのリソースにつながります。
さらに、自動微分は深層学習モデルを効果的に訓練するための重要な機能として位置付けられています。PyTorchのautogradパッケージは、勾配を計算しモデルのパラメータを調整するための簡単な方法を提供します。一方、JAXはAutogradを基に構築され、XLA(Accelerated Linear Algebra)バックエンドを統合することで自動微分をさらに高めています。
さらに、エコシステムとコミュニティのサポートは重要な役割を果たします。両方のフレームワークは、深層学習タスクのための活動的なコミュニティ、さまざまなツール、ライブラリを提供しています。それにもかかわらず、PyTorchの長い歴史と大規模なユーザーベースは、初心者にとって豊富なリソースと、コンピュータビジョンや自然言語処理などの特定の分野で確立されたライブラリをもたらします。
JAXとは何ですか?なぜそれはこれほど人気があるのですか?
JAXはGoogle Researchによって開発されたライブラリで、機械学習やAIタスクの高速化を図ることができます。JAXは、複雑な構造(ループや分岐など)を通じて、PythonやNumPyの関数を自動的に微分することができます。また、効率的な勾配計算を可能にする順方向および逆方向の微分(別名:バックプロパゲーション)もサポートしています。
微分を超えて、JAXはAccelerated Linear Algebra(XLA)と呼ばれる専門のコンパイラを使用することで、コードの速度を大幅に向上させることができます。このコンパイラは、操作の融合などの線形代数演算を最適化し、メモリ使用量を削減し、処理を効率化します。JAXはさらに、カスタムPython関数を最適化されたカーネルに対して、ジャストインタイム(JIT)コンパイルを使用して、実行時にコンパイルすることを可能にします。さらに、JAXはデバイス間での並列実行のためにPMAPのような強力なツールを提供します。
さて、PMAPとは何ですか?PMAPはJAXが単一プログラム複数データ(SPMD)プログラムを実行することを可能にします。PMAPを適用すると、関数はJITのようにXLAによってコンパイルされ、複製され、デバイス間で並行して実行されます。それがPMAPのPの意味です。
VMAPは自動ベクトル化に使用され、Gradは勾配計算に使用されます。VMAPは自動ベクトル化に使用され、単一のデータポイントのために設計された関数を、単一のラッパー関数を使用して異なるサイズのバッチを処理できるように変換します。
これらの機能は、JAXを機械学習モデルを構築および最適化するための多目的なフレームワークにします。
例えば、MNISTデータセットで深層ニューラルネットワークを訓練する際、JAXはデータを効率的にバッチ処理するためのVMAPや、JITを使用してモデル訓練を最適化するタスクを処理できます。JAXは研究プロジェクトであり、いくつかの不完全な点があるかもしれませんが、その機能は研究者や開発者にとって有望です。
PytorchとJAXの重要ポイント
- JAXのパフォーマンスは、コードを実行するためにGPUを使用することで向上し、JITコンパイルを使用することでさらに向上します。これにより、GPUが並列処理を利用するため、CPUよりも速いパフォーマンスを提供するという大きな利点があります。
- JAXは、PyTorchやTensorFlowのような機械学習タスクに一般的に使用される他のフレームワークを上回る、複数のデバイスでの並列処理をサポートする優れた機能を備えています。
- JAXはgrad()関数を使用して自動微分を提供します。この関数は、深層ニューラルネットワークを訓練する際に便利です。DNNは逆伝播を必要とするため、JAXは他の高度な技術を使用する代わりに、解析的勾配ソルバーを利用しています。本質的には、関数の構造を分解し、チェーンルールを適用して勾配を計算します。
- PyTorchは、Torchの効率的かつ適応可能なGPU加速バックエンドライブラリを、ユーザーフレンドリーなPythonフロントエンドと組み合わせています。それはプロトタイピング、明確なコードの可読性、および多様なディープラーニングモデルに対する広範なサポートを提供します。
- テンソルは、多次元配列に似ており、PyTorchの基本的なデータ型です。モデルの入力、出力、パラメータを保存し、操作します。NumPyのndarrayと類似点がありますが、計算を高速化するためのGPUアクセラレーションの追加機能があります。
JAXを始める
JAXでの実験を始めるために使用できるノートブックへのリンクをいくつか提供しました。JAXをインストールするには、以下のコマンドを実行してください。
!pip install -U "jax[cuda12_pip]" -f https://storage.googleapis.com/jax-releases/jax_cuda_releases.html
要件が満たされたら、必要なライブラリをインポートできます。
JAX's syntax is mostly similar to NumPy's!
There is also a SciPy API support (jax.scipy)
import jax.numpy as jnp
import numpy as np

Special transform functions
from jax import grad, jit, vmap, pmap

JAX's low level API
from jax import lax

from jax import make_jaxpr
from jax import random
from jax import device_put
例1: JAXの構文はNumPyの構文と非常に似ています。
L = [0, 1, 2, 3]
x_np = np.array(L, dtype=np.int32)
x_jnp = jnp.array(L, dtype=jnp.int32)

x_np, x_jnp
(array([0, 1, 2, 3], dtype=int32), Array([0, 1, 2, 3], dtype=int32))
x_np = np.linspace(0, 10, 1000)
y_np = 2 * np.sin(x_np) * np.cos(x_np)
plt.plot(x_np, y_np)

例2: こちらは速度テストを含むJAXとPyTorchの比較コードです:
以下のコードは、JAXとPyTorchを使用した行列乗算の実行時間を比較します。1000x1000の大きな行列を生成し、両方のライブラリを使用して乗算操作を行うのにかかる時間を測定します。
import time
import jax.numpy as jnp
from jax import jit, random
import torch

Define JAX matrix multiplication function
def jax_matmul(A, B):
    return jnp.dot(A, B)

Add JIT compilation for performance
jax_matmul_jit = jit(jax_matmul)

Define PyTorch matrix multiplication function
def torch_matmul(A, B):
    return torch.matmul(A, B)

Generate large matrices
matrix_size = 1000
key = random.PRNGKey(0)
A_jax = random.normal(key, (matrix_size, matrix_size))
B_jax = random.normal(key, (matrix_size, matrix_size))
A_torch = torch.randn(matrix_size, matrix_size)
B_torch = torch.randn(matrix_size, matrix_size)

Warm-up runs
for _ in range(10):
    jax_matmul_jit(A_jax, B_jax)
    torch_matmul(A_torch, B_torch)

Measure execution time for JAX
start_time = time.time()
result_jax = jax_matmul_jit(A_jax, B_jax).block_until_ready()
jax_execution_time = time.time() - start_time

Measure execution time for PyTorch
start_time = time.time()
result_torch = torch_matmul(A_torch, B_torch)
torch_execution_time = time.time() - start_time

print("JAX execution time:", jax_execution_time, "seconds")
print("PyTorch execution time:", torch_execution_time, "seconds")
JAXの実行時間: 0.00592041015625秒 PyTorchの実行時間: 0.017140865325927734秒
例3:JAXとPyTorchにおける自動微分の比較コード
これらのコードは、その関数の自動微分を示しています。
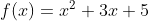
JAXとPyTorchを使用しています。JAXのgrad関数はJAXコード内で導関数を計算するために使用され、PyTorchのオートグラッド機構はPyTorchコード内で利用されます。
#for JAX

import jax.numpy as jnp
from jax import grad

Define the function to differentiate
def f(x):
    return x**2 + 3*x + 5

Define the derivative of the function using JAX's grad function
df_dx = grad(f)

Test the derivative at a specific point
x_value = 2.0
derivative_value = df_dx(x_value)
print("Derivative (JAX) at x =", x_value, ":", derivative_value)
導関数 (JAX) x=2.0 のとき : 7.0
#for PyTorch

import torch

Define the function to differentiate
def f(x):
    return x**2 + 3*x + 5

Convert the function to a PyTorch tensor
x = torch.tensor([2.0], requires_grad=True)

Calculate the derivative using PyTorch's autograd mechanism
y = f(x)
y.backward()
derivative_value = x.grad.item()
print("Derivative (PyTorch) at x =", x.item(), ":", derivative_value)
導関数 (PyTorch) x=2.0 のとき : 7.0
結論
結論として、PyTorchとJAXはどちらも機械学習や深層ニューラルネットワークの開発に強力なフレームワークを提供しています。それぞれのフレームワークには特性と強みがあります。PyTorchは使いやすさ、広範なコミュニティのサポート、迅速なプロトタイピングや実験の柔軟性に優れ、多くの深層学習プロジェクトにとって理想的な選択となります。一方、JAXは性能最適化、関数型プログラミングパラダイム、ハードウェアアクセラレーターとのシームレスな統合において優れ、高性能計算や大規模な研究のための好ましいフレームワークとなっています。最終的には、PyTorchとJAXの選択はプロジェクトの具体的な要件に依存し、開発の容易さと性能・スケーラビリティのニーズとのバランスを考える必要があります。両方のフレームワークが常に進化し、革新の限界を押し広げている中で、実務者はこのような多用途のツールにアクセスできることに恵まれています。
参考文献
- JAX公式ドキュメント
- 機械学習のためのJAX入門
- JAXとPyTorch: 2つの深層学習フレームワークの比較