正規表現は実際にどのように使いますか?
正規表現の略であるRegexは、プログラミング言語において文字列のパターンを一致させたり、検索と置換、入力の検証、テキストのフォーマット変更を行うためにしばしば使用されます。Regexを適切に使用する方法を学ぶことで、テキスト作業をはるかに簡単にすることができます。
正規表現の構文、解説
正規表現はひどい構文の評判がありますが、読むよりも書く方がずっと簡単です。例えば、RFC 5322準拠のメールバリデーターの一般的な正規表現を以下に示します:
(?:[a-z0-9!#$%&'*+/=?^_`{|}~-]+(?:.[a-z0-9!#$%&'*+/=?^_`{|}~-]+)*|"(?:[x01-
x08x0bx0cx0e-x1fx21x23-x5bx5d-x7f]|\[x01-x09x0bx0cx0e-x7f])*")
@(?:(?:[a-z0-9](?:[a-z0-9-]*[a-z0-9])?.)+[a-z0-9](?:[a-z0-9-]*[a-z0-9])?|[(?
:(?:25[0-5]|2[0-4][0-9]|[01]?[0-9][0-9]?).){3}(?:25[0-5]|2[0-4][0-9]|[01]?[0-
9][0-9]?|[a-z0-9-]*[a-z0-9]:(?:[x01-x08x0bx0cx0e-x1fx21-x5ax53-x7f]|
\[x01-x09x0bx0cx0e-x7f])+)])
もし誰かがキーボードに顔をぶつけたように見えるなら、あなたは一人ではありません。しかし、その背後では、この混沌は実際には有限状態機械をプログラミングしています。この機械は各文字に対して動作し、設定したルールに基づいて一致させます。オンラインツールの多くは、あなたのRegexマシンの動作を示すレールロード図を生成します。以下は、同じRegexを視覚的に表したものです:

まだ非常に混乱していますが、ずっと理解しやすくなっています。これは、すべてがどのように組み合わさるかを定義するルールを持つ動く部分を持った機械です。誰かがこれを組み立てた様子が見えます。それは単なる大きな塊のテキストではありません。
まず最初に:Regexデバッガーを使用する
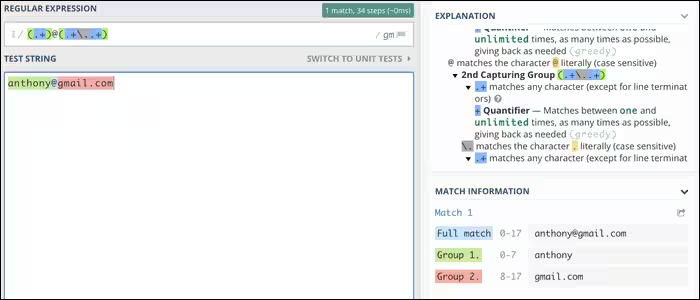
始める前に、あなたの正規表現が特に短いか、あなたが特に熟練していない限り、書いたりテストしたりする際にはオンラインデバッガーを使うべきです。これにより、構文を理解するのがずっと簡単になります。私たちは、テストと組み込みの構文リファレンスを提供するRegex101とRegExrをお勧めします。
正規表現はどのように機能しますか?
今は、もっと簡単なことに集中しましょう。これは非常に短い(そして確実にRFC 5322に準拠していない)メールマッチング用の正規表現のためのRegulexの図です。
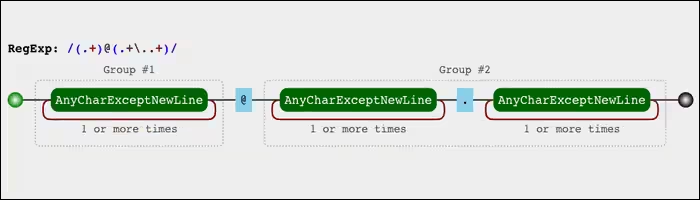
正規表現エンジンは左から始まり、行を下に進みながら文字を一致させていきます。グループ#1は改行以外の任意の文字に一致し、次のブロックが一致を見つけるまで文字の一致を続けます。この場合、@記号に達すると停止するため、グループ#1はメールアドレスの名前をキャプチャし、以降はドメインに一致します。
私たちのメールの例でグループ#1を定義する正規表現は次のとおりです:
(.+)括弧はキャプチャグループを定義し、このグループの一致の内容を特別な変数に含めるように正規表現エンジンに指示します。文字列に正規表現を実行すると、デフォルトの戻り値は全体の一致(この場合、全てのメールアドレス)です。しかし、各キャプチャグループも返されるため、この正規表現はメールアドレスから名前を抽出するのに便利です。
ピリオドは「任意の文字(改行を除く)」の記号です。これは行上のすべてに一致するため、このメールの正規表現に次のようなアドレスを渡した場合:
%$#^&%*#%$#^@gmail.comそれは名前として%$#^&%*#%$#^に一致するでしょうが、それは馬鹿げています。
プラス(+)記号は、前の文字またはグループを1回以上一致させるという意味の制御構造です。これにより、全体の名前が一致し、最初の文字だけが一致するのではないことが保証されます。これが、鉄道図に見られるループを作成する理由です。
残りの正規表現は解読するのが比較的簡単です:
(.+)@(.+..+)最初のグループは@シンボルに到達すると停止します。次のグループが始まり、再び複数の文字と一致し、ピリオド文字に達するまで続きます。
正規表現の構文において、句点、括弧、スラッシュなどの文字が使用されているため、それらの文字を一致させたい場合は、必ずバックスラッシュで正しくエスケープする必要があります。この例では、句点を一致させるために.と書き、パーサーはそれを「句点に一致する」という意味の1つの記号として扱います。
キャラクターマッチング
正規表現に制御文字以外の文字が含まれている場合、正規表現エンジンはそれらの文字が一致するブロックを形成することを前提とします。例えば、次の正規表現:
he+llo「hello」という単語を任意の数の「e」と一致させます。その他の文字は正しく機能するためにエスケープする必要があります。
正規表現には、文字クラスもあり、これは一連の文字の短縮形として機能します。これらは正規表現の実装によって異なる場合がありますが、これらのいくつかは標準です:
.- 改行を除く任意の文字にマッチします。wは、数字やアンダースコアを含む任意の「単語」文字に一致します。d- 数字に一致します。b- 空白文字(すなわち、スペース、タブ、改行)に一致します。
これらの3つはすべて、大文字の対応物を持ち、その機能を反転させます。たとえば、Dは数字でないものに一致します。
正規表現は、文字セットマッチングも備えています。例えば:
[abc]a、b、またはcのいずれかと一致します。これは一つのブロックとして機能し、角括弧は制御構造に過ぎません。あるいは、文字の範囲を指定することもできます。
[a-c]または集合を否定して、集合に含まれない任意の文字にマッチさせます:
[^a-c]量詞
量指定子は正規表現において重要な部分です。正確な形式がわからない文字列と一致させることができますが、かなりの程度の見当はついています。
メールの例にある + 演算子は、量化子であり、特に「1つ以上」の量化子です。特定の文字列の長さがわからないが、英数字から構成されている(かつ空ではない)ことがわかっている場合、以下のように書くことができます。
w++ だけでなく、以下のものもあります:
*演算子は「ゼロ回以上に一致する」を意味します。本質的には+と同じですが、一致しない場合のオプションがあります。- 「?」演算子は「ゼロまたは1に一致する」演算子です。これは、文字をオプションにする効果があります。それが存在するか、存在しないかのいずれかで、1回以上一致することはありません。
- 数的量詞。これらは、
{3}のような単一の数字で、「ちょうど3回」を意味するか、{3-6}のような範囲です。2番目の数字を省略することで無制限にすることができます。たとえば、{3,}は「3回以上」を意味します。奇妙なことに、最初の数字を省略することはできないので、「3回以下」を希望する場合は、範囲を使用する必要があります。
貪欲で怠惰な量子化子
内部では、* および + 演算子は貪欲です。可能な限り多くを一致させ、次のブロックを開始するために必要なものを返します。これは大きな問題になる可能性があります。
次の例を見てください: HTMLや閉じ括弧を持つその他のものを一致させようとしているとします。あなたの入力テキストは:
<div>Hello World</div>そして、あなたは括弧内のすべてを一致させたいのですね。以下のようなことを書くことができます:
<.*>これは正しいアイデアですが、1つの重要な理由で失敗します。それは、Regexエンジンがシーケンス.*に対してdiv>Hello World</div>と一致し、次のブロックが一致するまでバックトラックすることです。この場合、閉じ括弧>に一致します。バックトラックが「div」だけに一致するために戻ることを期待していましたが、実際には文字列の末尾からバックトラックが行われ、終了括弧で停止します。結果として、括弧内のすべてに一致してしまいます。
解決策は、私たちの量化子を遅延させることであり、これはできるだけ少ない文字にマッチすることを意味します。内部では、実際には1文字だけにマッチし、その後次のブロックマッチまでのスペースを埋めるように拡張されるため、大規模なRegex操作においてはるかにパフォーマンスが向上します。
量詞を遅延させるには、量詞の後に直接疑問符を追加します。これは、?がすでに量詞であるため、少し混乱します(デフォルトでは実際に貪欲です)。私たちのHTMLの例では、この簡単な追加で正規表現が修正されます:
<.*?>怠惰なオペレーターは、+?、{0,3}?、さらには??を含む任意の量指定子に追加できます。ただし、最後の例は効果がありません; なぜなら、ゼロまたは1文字を一致させるだけなので、拡張する余地がないからです。
グルーピングとルックアラウンド
正規表現のグループには多くの目的があります。基本的なレベルでは、複数のトークンを1つのブロックにまとめます。例えば、グループを作成し、そのグループ全体に量指定子を使用することができます。
ba(na)+これは繰り返される「na」をグループ化して、フレーズbananaやbananananaなどに一致させます。グループがなければ、Regexエンジンは終了文字を何度も一致させるだけです。
この2つの単純な括弧を持つグループはキャプチャグループと呼ばれ、出力に含まれます:
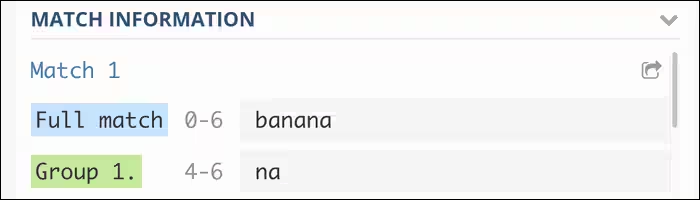
これを避けたい場合、実行の理由でトークンをグループ化するだけであれば、非キャプチャグループを使用できます。
ba(?:na)疑問符(予約された文字)は非標準グループを定義し、次の文字はそのグループの種類を定義します。疑問符で始まるグループは理想的です。なぜなら、そうしないとグループ内でセミコロンを一致させようとした場合、特に理由もなくそれらをエスケープする必要があるからです。しかし、Regexでは常に疑問符をエスケープする必要があります。
出力作業をする際に便利なように、グループに名前を付けることもできます:
(?'group')これらをあなたの正規表現で参照でき、変数のように機能します。名前の付けられていないグループはトークン1で参照できますが、これは最大7までで、それ以降はグループに名前を付ける必要があります。名前付きグループを参照するための構文は次のとおりです:
k{group}これは、名前付きグループの結果を参照しており、動的である可能性があります。本質的には、グループが複数回発生するかどうかを確認しますが、その位置には関心がありません。例えば、これは3つの同じ単語の間のすべてのテキストに一致させるために使用できます:
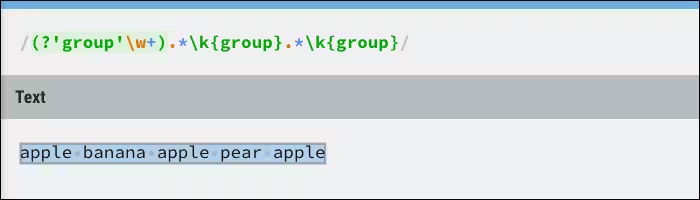
グループクラスは、最も多くのRegexの制御構造、特に先読みを見つける場所です。先読みは、式が一致しなければならないことを保証しますが、結果には含まれません。ある意味、if文に似ており、偽を返すと一致しなくなります。
正の先読みの構文は(?=)です。以下に例を示します:
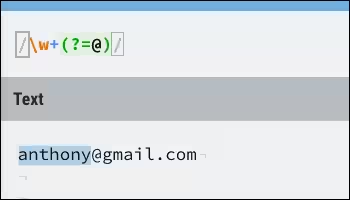
これは、@で区切ることによって、電子メールアドレスの名前部分と非常にきれいに一致します。先読みは文字を消費しないため、先読みが成功した後に処理を続行したい場合でも、先読みで使用される文字をまだ一致させることができます。
ポジティブルックアヘッドに加えて、以下のものもあります:
- (?!) - ネガティブ・ルックアヘッドで、式が一致しないようにします。
(?<=)- 正の先読み、これは技術的制約のため、どこでもサポートされているわけではありません。これらはマッチさせたい表現の前に置かれ、固定の幅を持たなければなりません(つまり、{number}以外の量指定子は使用できません)。この例では、メールのドメイン部分をマッチさせるために(?<=@)\w+\.\w+を使用できます。- (?
正規表現エンジンの違い
すべての正規表現が同じように作られているわけではありません。ほとんどの正規表現エンジンは特定の標準に従っておらず、いくつかは自分たちの言語に合わせて少し変更しています。一つの言語で機能する特徴が別の言語では機能しないことがあります。
例えば、macOSおよびFreeBSD用にコンパイルされたsedのバージョンは、タブ文字を表すためにtを使用することをサポートしていません。コマンドラインsedでタブを使用するには、タブ文字を手動でコピーしてターミナルに貼り付ける必要があります。
このチュートリアルのほとんどは、PHPで使用されるデフォルトの正規表現エンジンであるPCREと互換性があります。しかし、JavaScriptの正規表現エンジンは異なります—名前付きキャプチャグループが引用符をサポートしておらず(ブラケットを求めます)、再帰もできません。他にもいくつかのことがあります。さらに、PCREも異なるバージョンの完全な互換性はなく、Perlの正規表現とは多くの違いがあります。
ここにリストするには小さな違いが多すぎるので、この参照テーブルを使用して複数のRegexエンジン間の違いを比較してください。また、Regex101のようなRegexデバッガーはRegexエンジンを切り替えることができるので、正しいエンジンを使用してデバッグしていることを確認してください。
正規表現の実行方法
私たちは正規表現のマッチ部分について話し合ってきました。これは正規表現の大部分を占めています。しかし、実際に正規表現を実行したいときは、それを完全な正規表現に形成する必要があります。
これは通常、次の形式を取ります:
/match/gスラッシュの内側のすべては私たちの一致です。gはモードモディファイアです。この場合、エンジンが最初の一致を見つけた後も実行を停止しないように指示します。検索と置換の正規表現では、しばしば次のようにフォーマットする必要があります:
/find/replace/gこれはファイル全体で置き換えます。置き換え時にキャプチャグループ参照を使用できるため、正規表現はテキストのフォーマットに非常に適しています。例えば、この正規表現はすべてのHTMLタグにマッチし、標準のかっこを角かっこに置き換えます:
/<(.+?)>/[1]/gこれが実行されると、エンジンは<div>と</div>を一致させ、このテキスト(このテキストのみ)を置き換えることができます。ご覧のとおり、内部のHTMLは影響を受けていません。
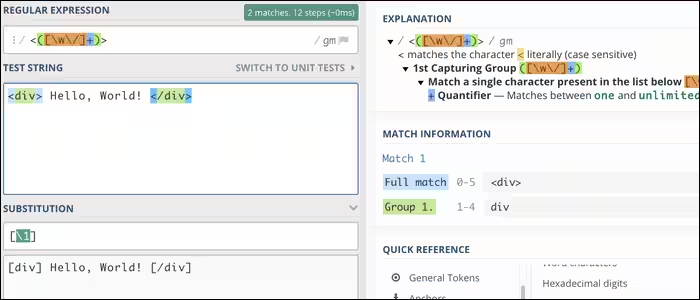
これにより、Regexはテキストの検索と置換に非常に役立ちます。これを行うためのコマンドラインユーティリティはsedであり、基本形式は以下の通りです:
sed '/find/replace/g' file > fileこれはファイルで実行され、STDOUTに出力されます。実際にディスク上のファイルを置き換えるには、これを自分自身にパイプでつなぐ必要があります(ここに示すように)。
正規表現は多くのテキストエディタでもサポートされており、バッチ操作を行う際にワークフローを大幅にスピードアップできます。Vim、Atom、VS Codeはすべて、正規表現による検索と置換の機能を備えています。
もちろん、正規表現はプログラム的に使用することもでき、多くの言語に組み込まれています。正確な実装は言語によって異なるため、使用している言語のドキュメントを参照する必要があります。
例えば、JavaScriptでは、正規表現はリテラルとして作成することも、グローバルなRegExpオブジェクトを使用して動的に作成することもできます。
var re = new RegExp('abc')これは、新しく作成された正規表現オブジェクトの.exec()メソッドを直接呼び出すか、文字列の.replace(), .match(), および.matchAll()メソッドを使用することで使用できます。