Linuxターミナルで正規表現を始める方法
量詞: 正確な量と可変の量を指定する方法
量詞は数量を定義するために使用されます。DOTALLまたは文字クラスと文字を一致させるとき、私たちは量詞を使っていくつかの数量を言います。また、量詞を使用してグループに一致させることもできるため、全体の表現に対する数量を定義することもできます。
アスタリスクでゼロまたはそれ以上のものを一致させる
アスタリスク(*)メタ文字は、ゼロ個以上のものに一致します。次のように一致するものは、a、b、z、または空の文字列です。
[abz]*プラス記号で一つ以上のものを一致させる
プラス(+)メタキャラクターは1つ以上のものに一致します。次のものは1つ以上のa、b、またはz文字に一致します:
[abz]+クエスチョンマークで物事をオプションにする
クエスチョンマーク (?) メタキャラクターは、前の項目をオプションにします。以下は、正確に 1 つの a, b, z, または何もマッチしません:
[abz]?波括弧で正確な量を定義する
波括弧は私たちが正確な数を定義することを許します。例えば、以下はa、b、またはzを正確に二回一致させます:
[abz]{2}以下はa、b、またはzが2回から4回の間に一致します:
[abz]{2,4}量詞のまとめ
- ?:オプションです。
- *: ゼロまたはそれ以上(ゼロは空文字列を意味します)。
- 一つ以上。
- {n,m}: n と m のアイテム間のマッチ。
プラス(+)および疑問符(?)のメタ文字は、適切なコマンドフラグを使用しない限り、ほとんどのLinuxユーティリティでは機能しません。フラグについては後で説明します。
怠惰で貪欲な量指定子を使って、好きなだけまたは少しだけ一致させることができます。
いくつかの量化子は、不特定の量を定義することを可能にします。例えば、プラス記号 (+) は 1つ以上、つまり0より大きいものを意味します。プラス (+) とアスタリスク (*) のメタキャラクタはデフォルトで 貪欲 であり、できるだけ多くの部分と一致しようとします。それに対して、これらを 怠惰 にすることで、できるだけ少ない部分と一致するようにすることができます。
クエスチョンマーク(?)を追加すると、それらは怠惰になります。例えば、次のようなものは a, b, または z, に一致しますが、最初の一致で停止します(それは怠惰です)。
[abz]+?アスタリスク (*) メタキャラクターは、わずかな違いを除いて似ています。それはゼロまたはそれ以上のアイテムに一致します。最も怠惰な一致はゼロであるため、以下は何も一致しません。
[abz]*?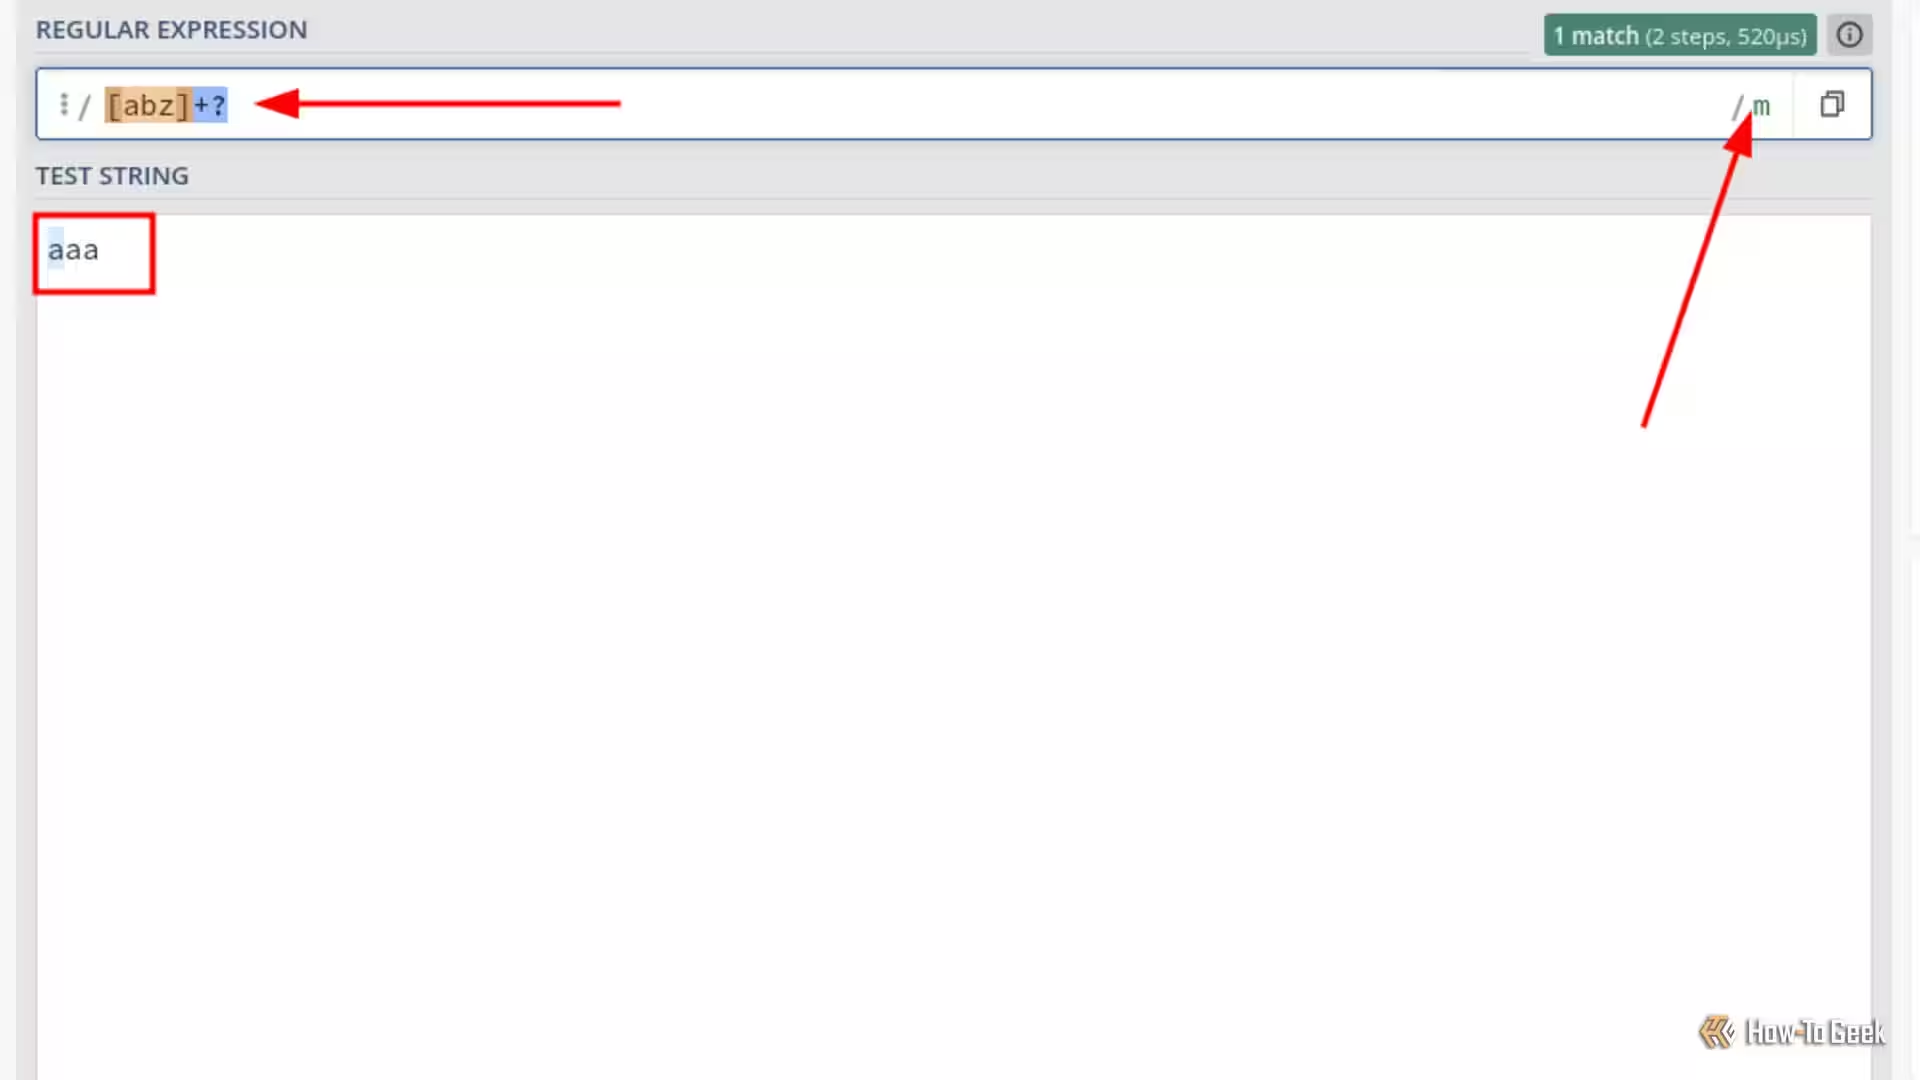
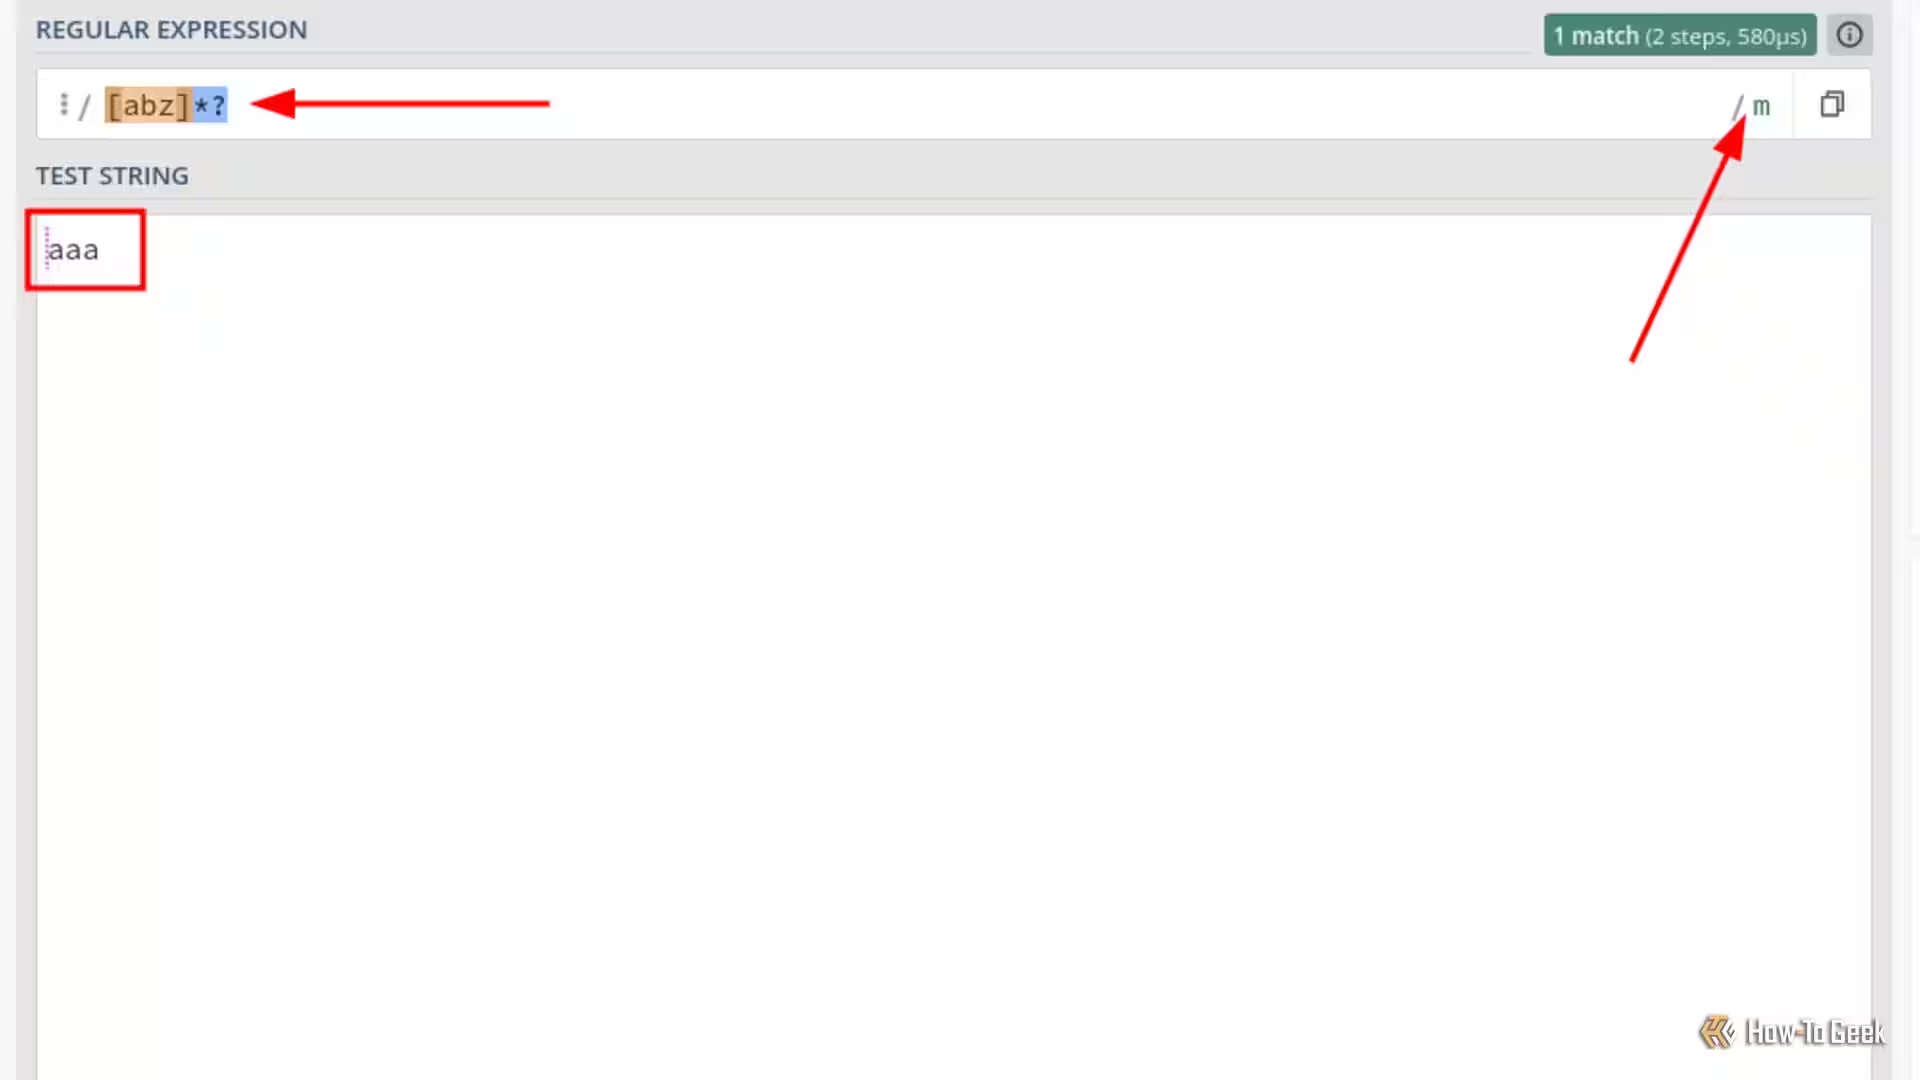
量指定子を遅延させることで、文字列全体を処理する必要がなくなり、パフォーマンスが向上する場合があります。何百万もの文字列を検索している場合は、最初の数文字だけを一致させることで、多くの時間とリソースを節約できます。
アンカーは行の開始と終了を一致させます
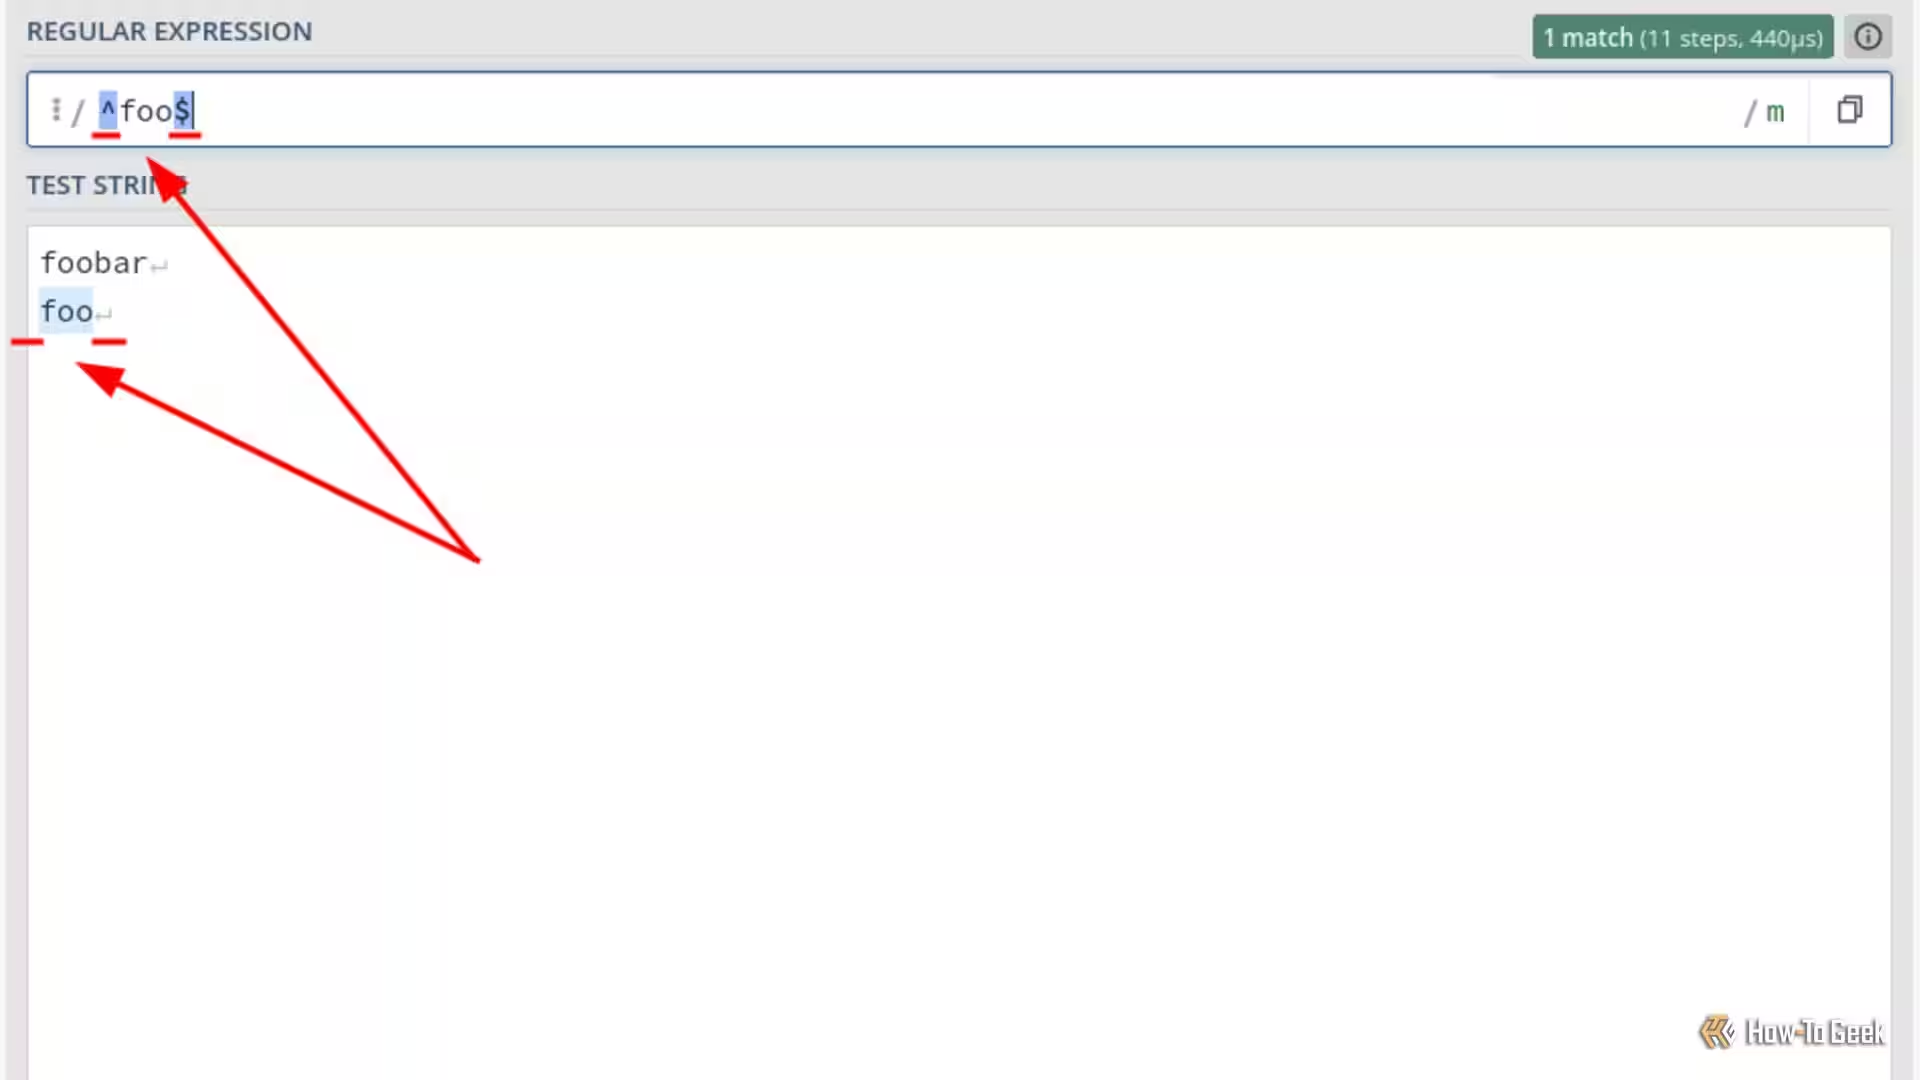
アンカーは理解しやすいです。2つあり、1つは行の開始を示す(^)、もう1つは終了を示します($)。次のパターンはfooに正確に一致し、他には何も一致しません:
^foo$
修飾子:正規表現の動作を変更するフラグ
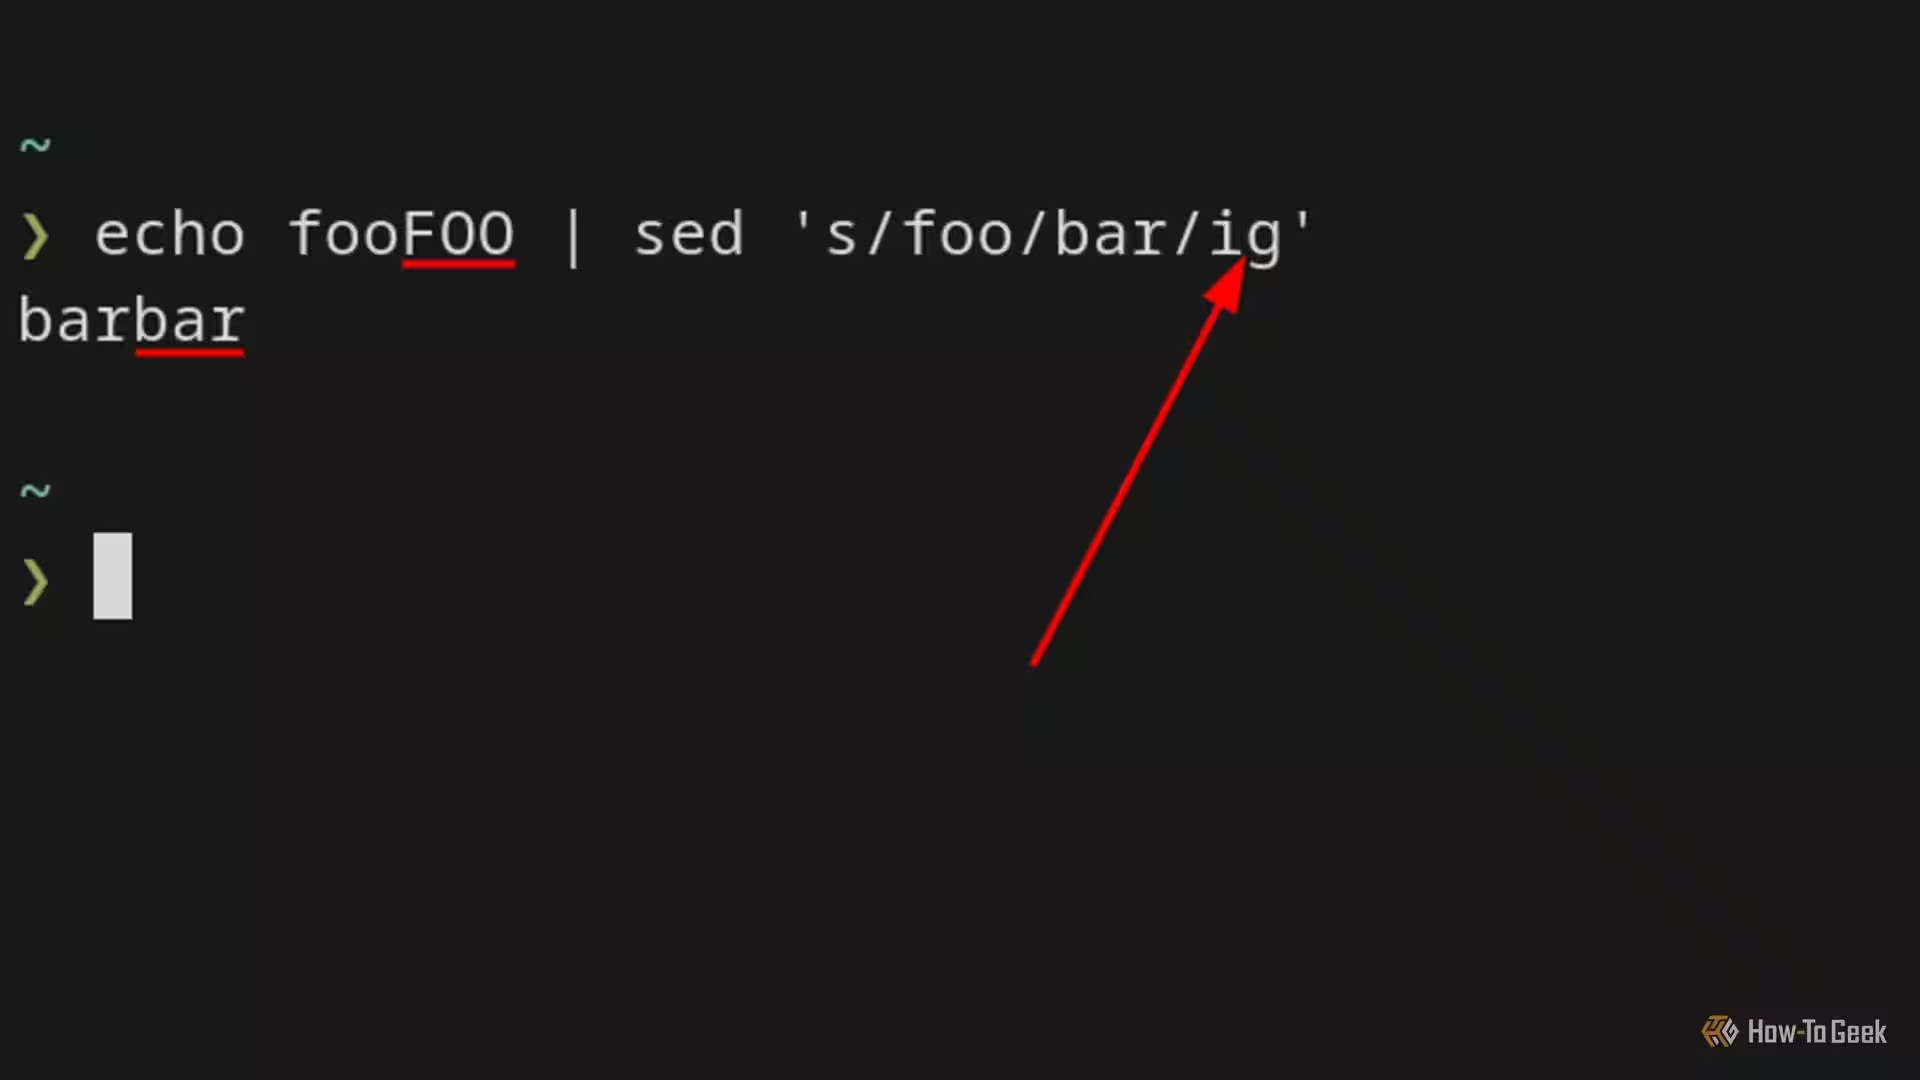
修飾子は、正規表現の動作を変更する方法です。たとえば、大文字と小文字を区別するようにできます。すでにグローバル修飾子について見ましたが、それは一般的に式の最後に存在するフラグであることを再度述べる価値があります。
グローバルモディファイア
グローバル修飾子(g)は、正規表現が最初の一致を見つけた後も一致を検索し続けることを可能にし、複数の一致を結果としてもたらします。対照的に、グローバル修飾子を無効にすると、正規表現は最初の一致を見つけた後に停止します。

この表現は個々の大文字と数字にマッチします。小文字は無視されます。グローバル修飾子 (g) が有効なため、複数の項目にマッチします。
大文字小文字を無視する修飾子
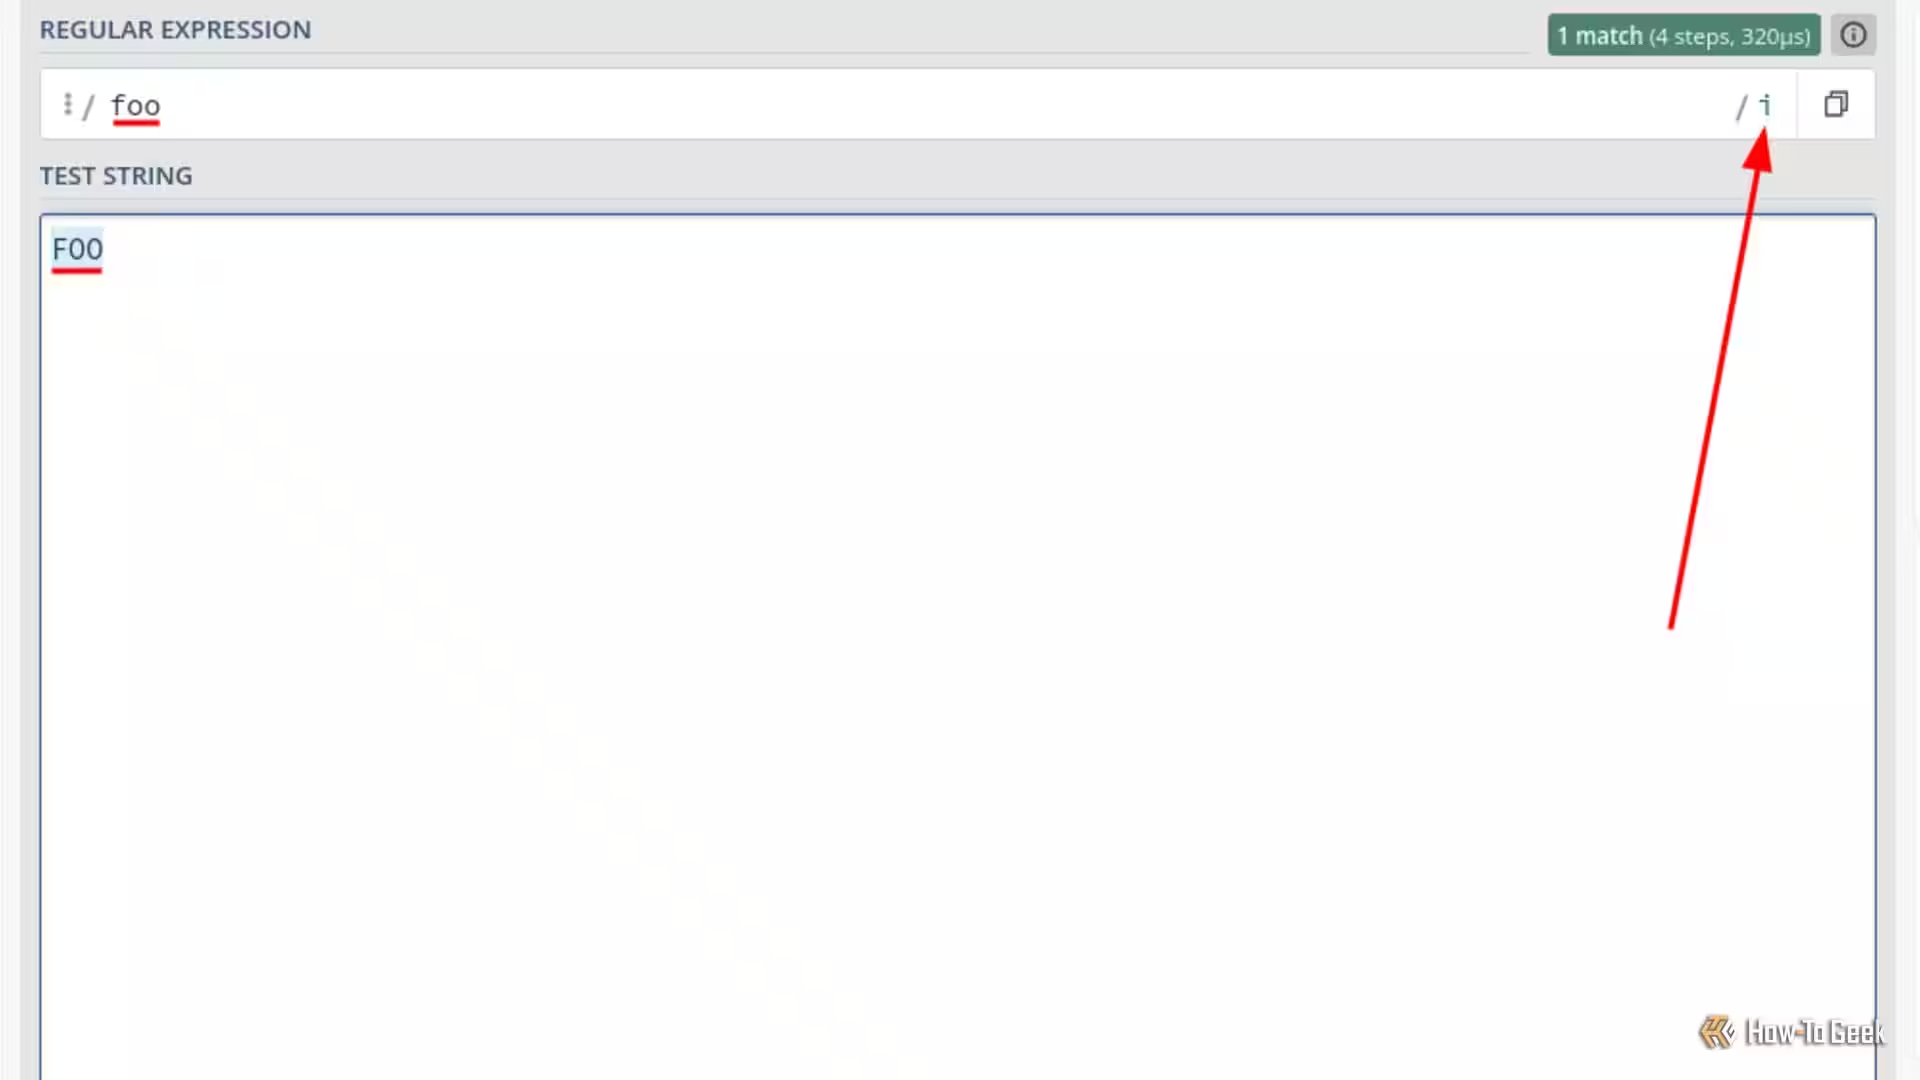
ケースインセンシティビティ修飾子(i)は、アクティブな場合、大文字と小文字の両方に対して一致します。
マルチライン修飾子
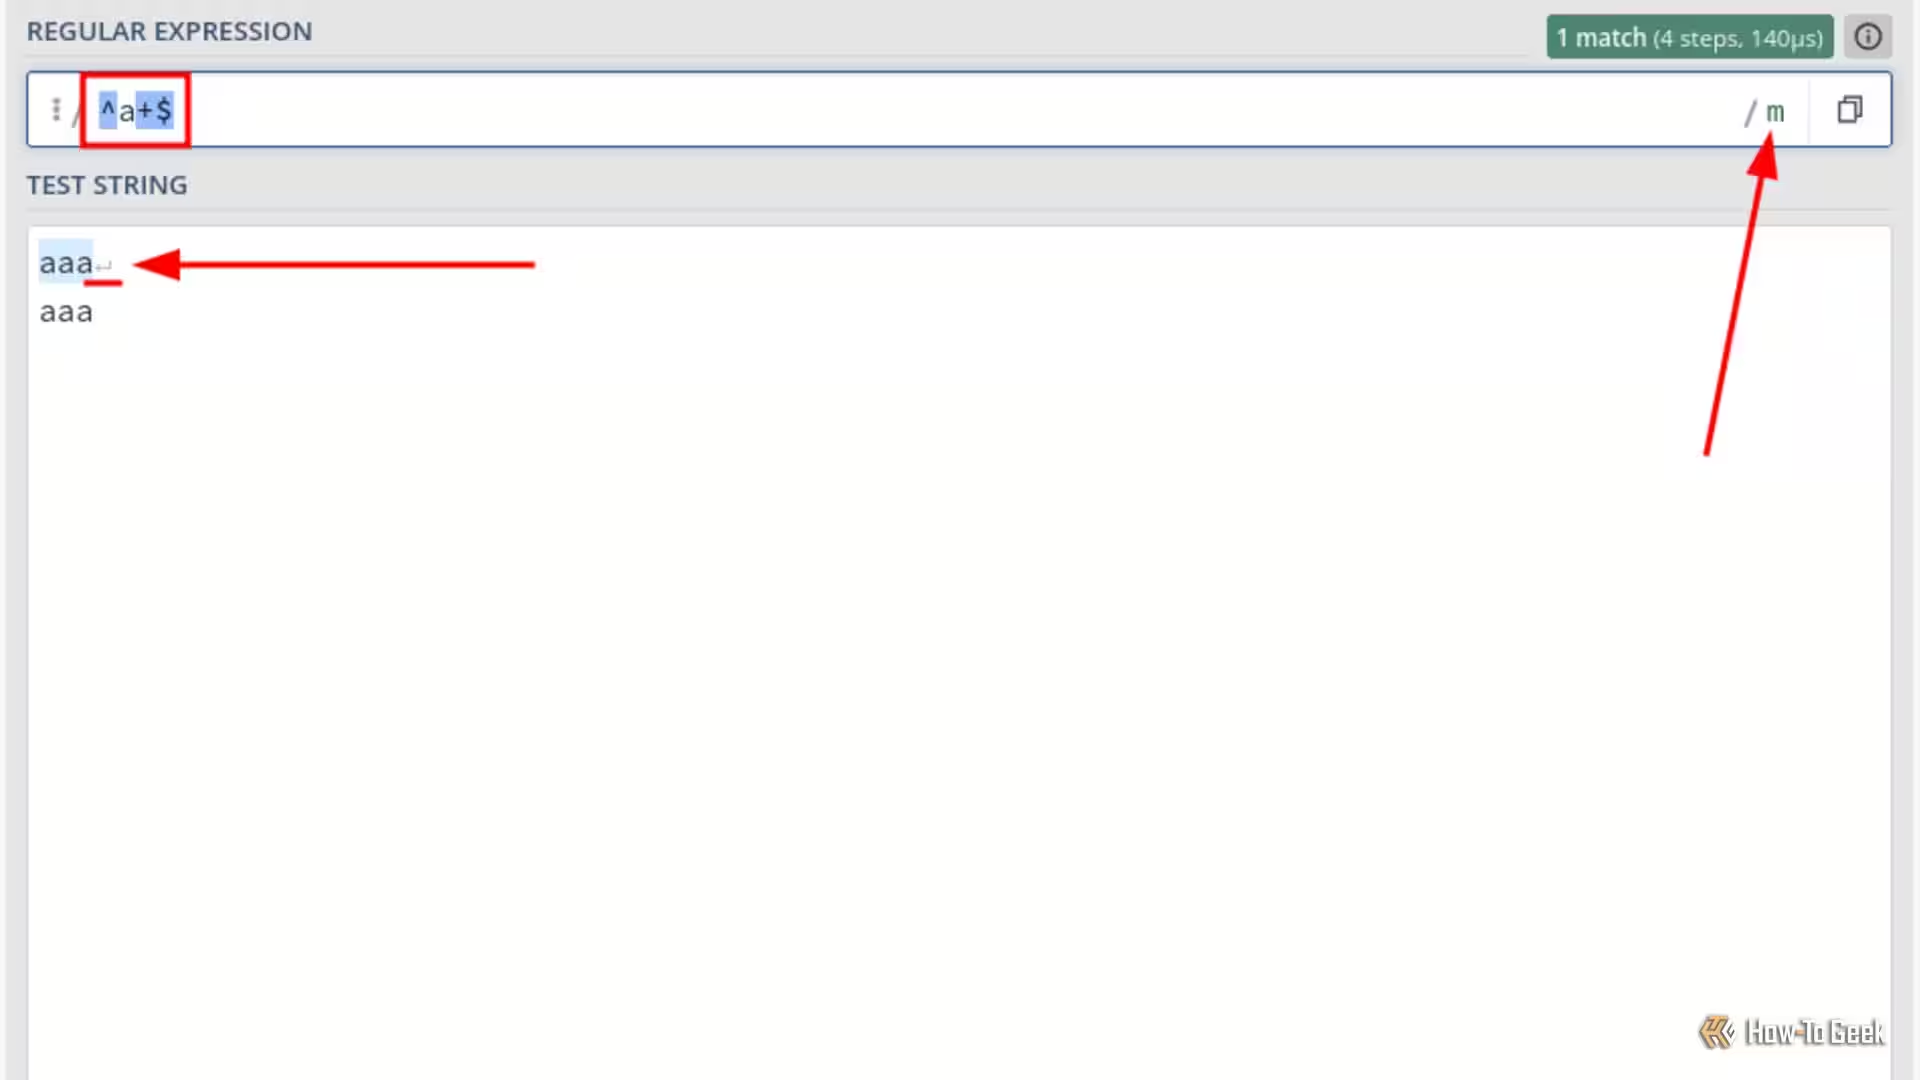
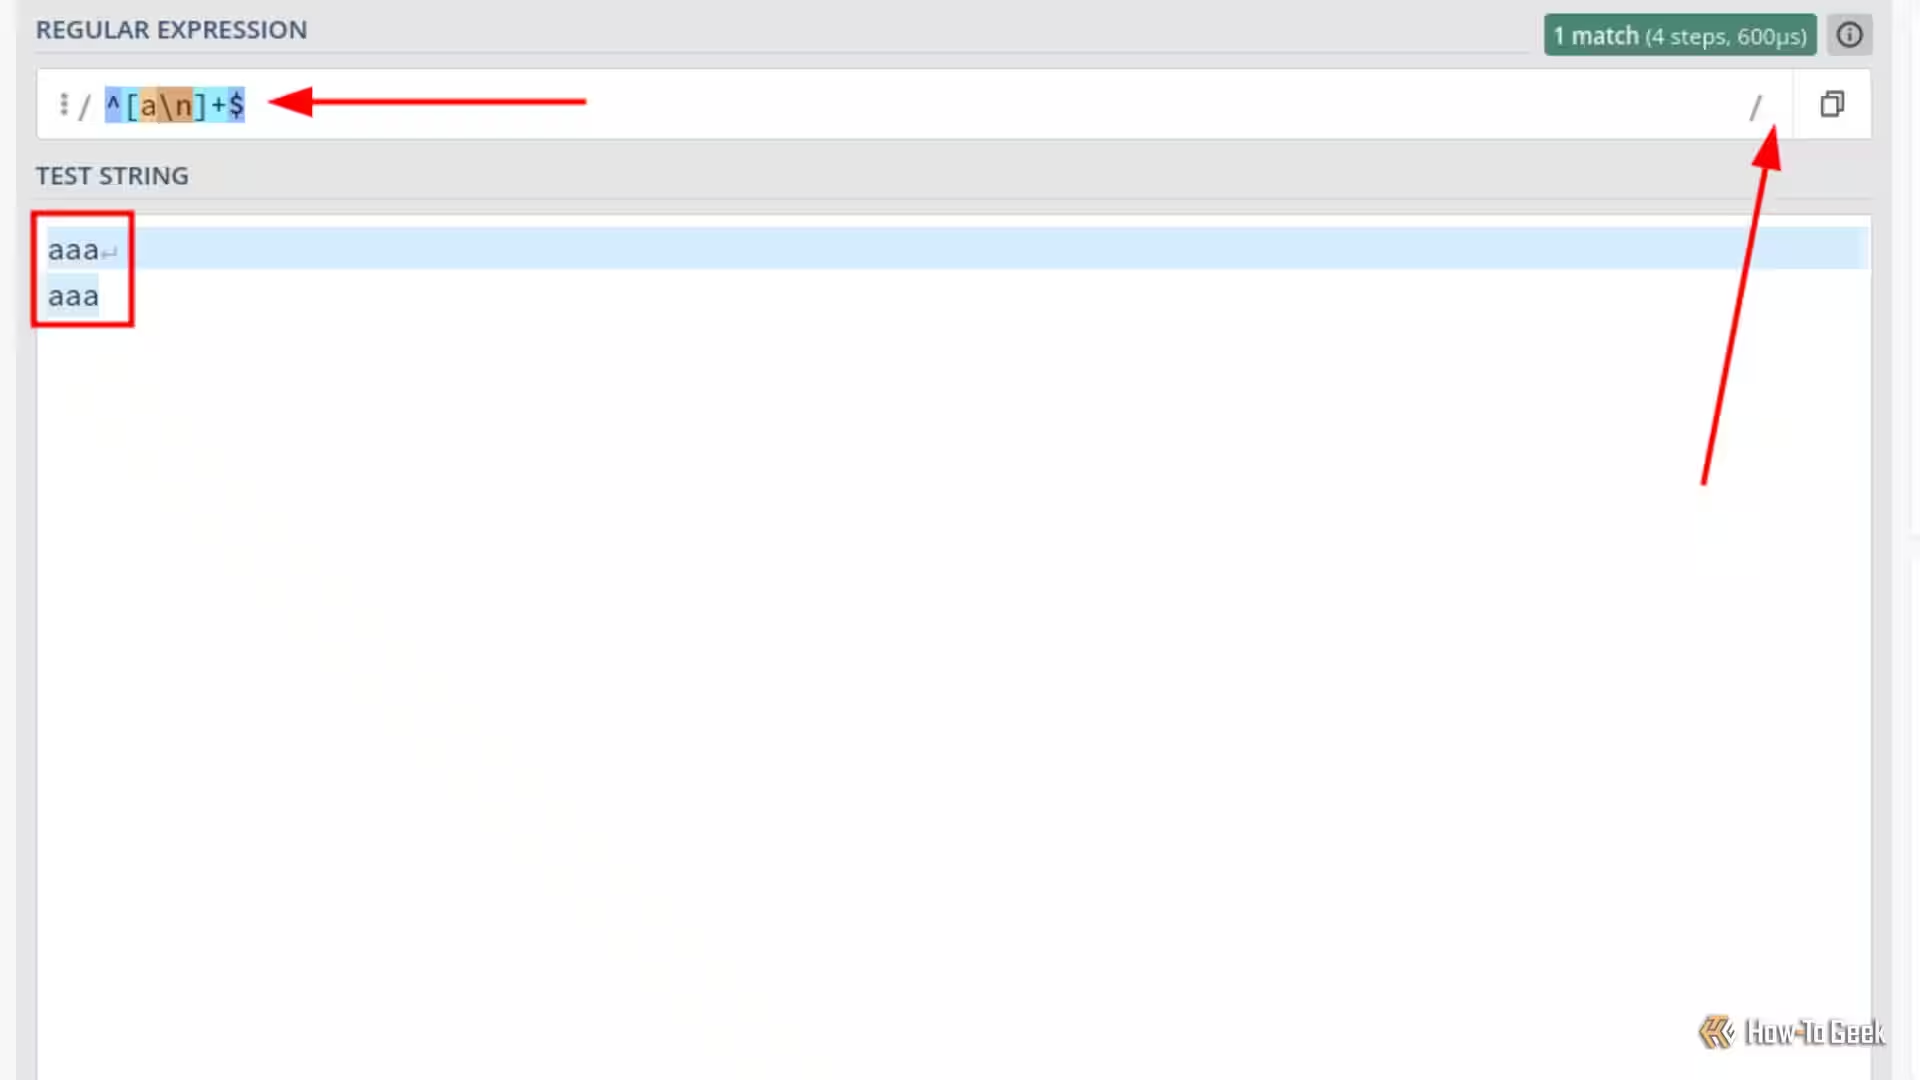
アンカーは文字列の開始(^)と終了($)を定義します。マルチライン修飾子(m)がアクティブな場合、アンカーは各行の開始と終了に一致します。非アクティブな場合、アンカーは文字列全体に一致します。
これはマルチラインモードがアクティブのとき、アンカーがどのように動作するかです:
^foo$
^bar$そして、それが非アクティブなとき:
^foo
bars$
複数行修飾子(m)がアクティブなときにすべての行を評価するには、グローバル修飾子(g)も有効にする必要があります。しかし、そうすると複数の一致も作成されることを忘れないでください。
すべてをまとめる: コマンドでの正規表現の使用
それでは、いよいよ大団円です:私たちが学んだことをどのように有効活用するのでしょうか?最初に言ったように、find、fd、grep、ripgrep、sedはすべて正規表現をサポートしています。私が使うコマンドフラグに注意してください;私は似たようなスタイルを使用するように選びました。
各コマンドに対して、私は次の表現を使用します:
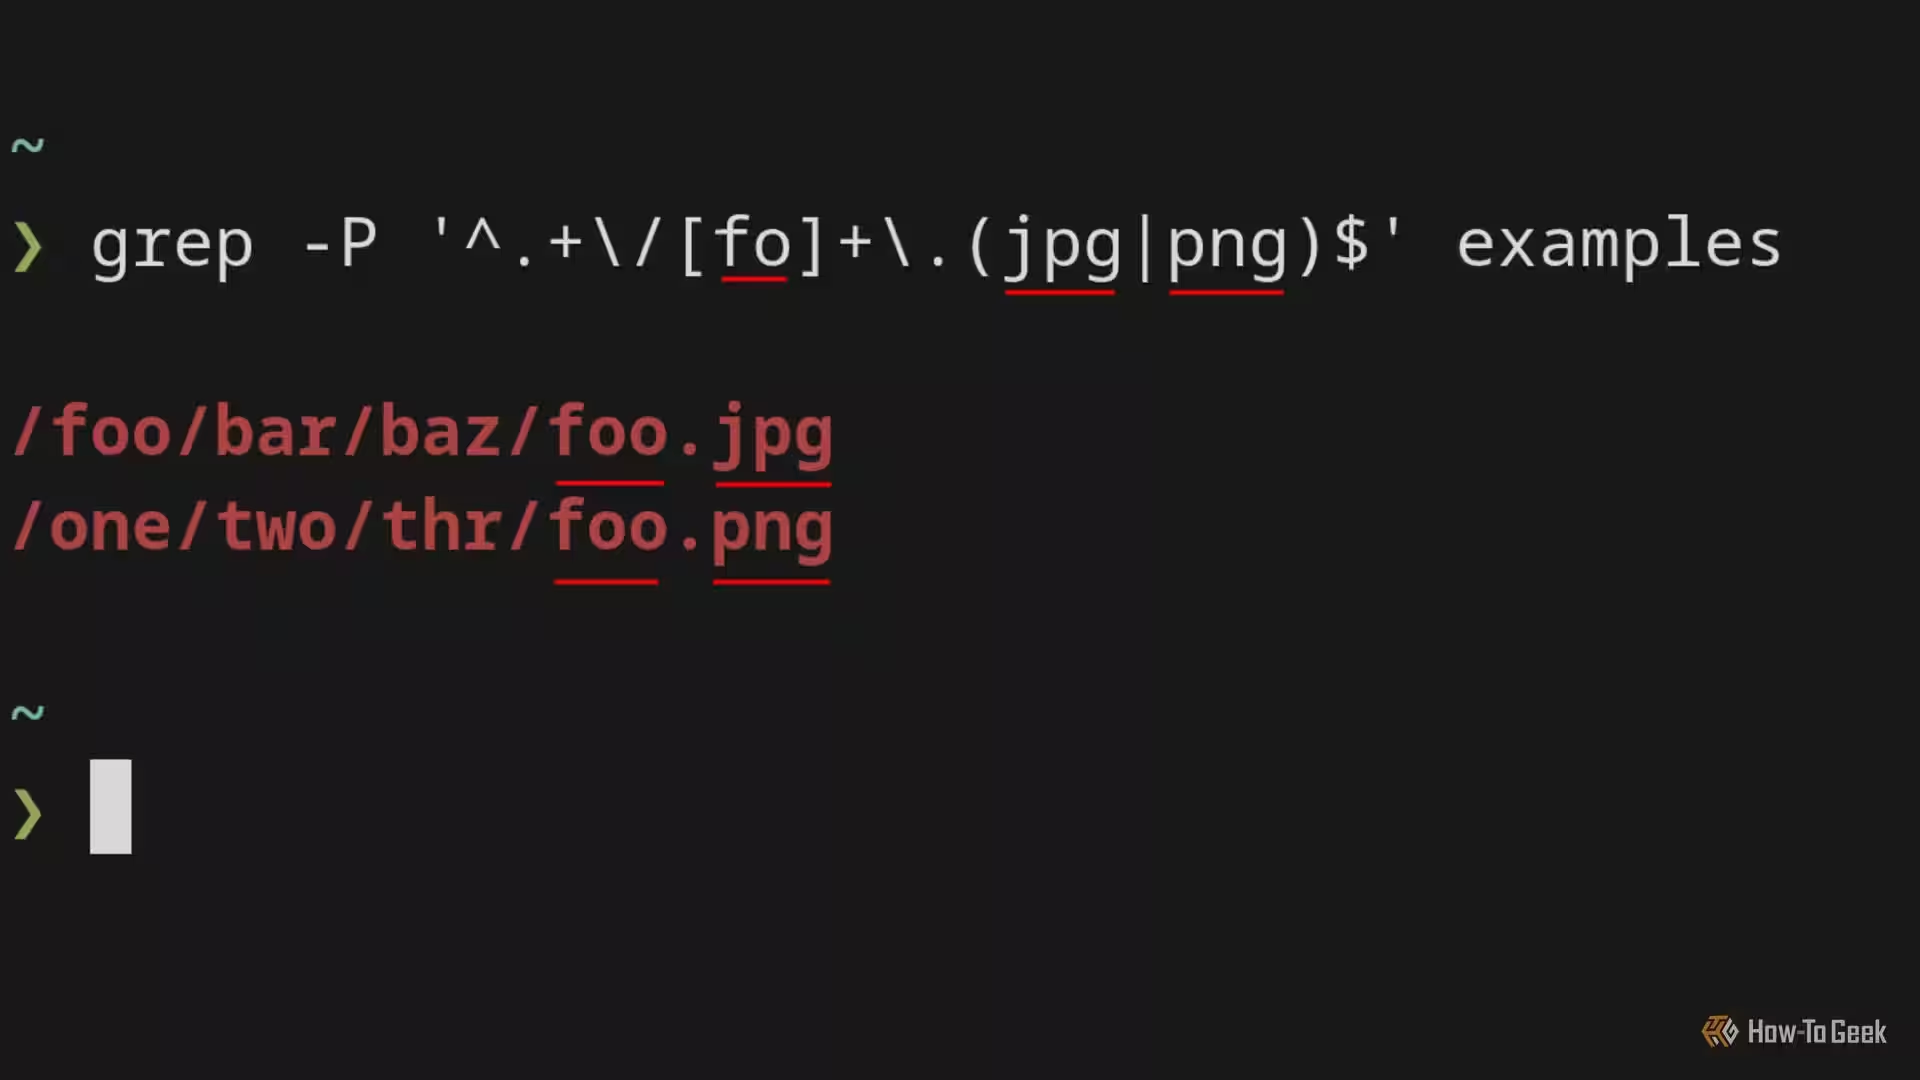
^.+/[fo]+\.(jpg|png)$このパターンはJPGまたはPNGファイルのPOSIXパスに一致します。例えば:
/foo/bar/baz/foo.jpgこの式は、私たちが学んできたすべてを網羅しています:アンカー、文字クラス、量指定子、選択、マッチグループ、そしてDOTALLメタキャラクターです。以下に式の要約を示します(出現順に):
セグメント | ノート |
|---|---|
^ | 行の始まりを一致させてください。 |
何かお手伝いできることはありますか? | 任意の文字を1回以上一致させる。 |
/ | ファイル名の直前にスラッシュを一致させます。このリテラルスラッシュは、ファイル名の明確な境界を定義します。また、以前のDOTALLは他のすべてのパス文字(スラッシュを含む)に一致します。 |
[fo]+ | 文字 f と o を1回以上一致させてください。例: fo、foo、ffoo、fffooo、fofofof。 |
\. | リテラルなピリオドを一致させます(DOTALLではありません)。 |
(jpg|png) | マッチグループ; ここではこれら二つのパターンをまとめるために使用しました。パイプはオルタネーションと呼ばれ、このように使用すると jpg または png という意味になります。 |
$ | 行の終わりを合わせてください。 |
私はすべての表現を次の内容を持つファイル(examples と呼ばれる)と照合します:
/foo/bar/baz/foo.jpg
/one/two/thr/foo.png
/this/should/not/match.jpg
検索コマンドのために、私は自分のファイルシステムにそのようなファイルを作成し、それらを検索します。
正規表現を使用したgrep
grepでは、-Pフラグを使用する必要があります。これにより、その(限定的な)PCREエンジンが有効になります。PCREは最も広範なバージョンで、思いつくほとんどの機能をサポートしています。
grepに不慣れな場合は、使用方法に関するこの詳細なガイドを参照してください。
正規表現を使用した検索
findコマンドは複数の正規表現フレーバーをサポートしています。次のコマンドでそれらのリストを見ることができます:
find -regextype helpPCREに最も近いフレーバーは、posix-extended、またはPOSIX ERE(拡張正規表現)です。POSIX EREは多くの高度な機能を欠いていますが、私たちが扱ってきたすべての機能をサポートしています。
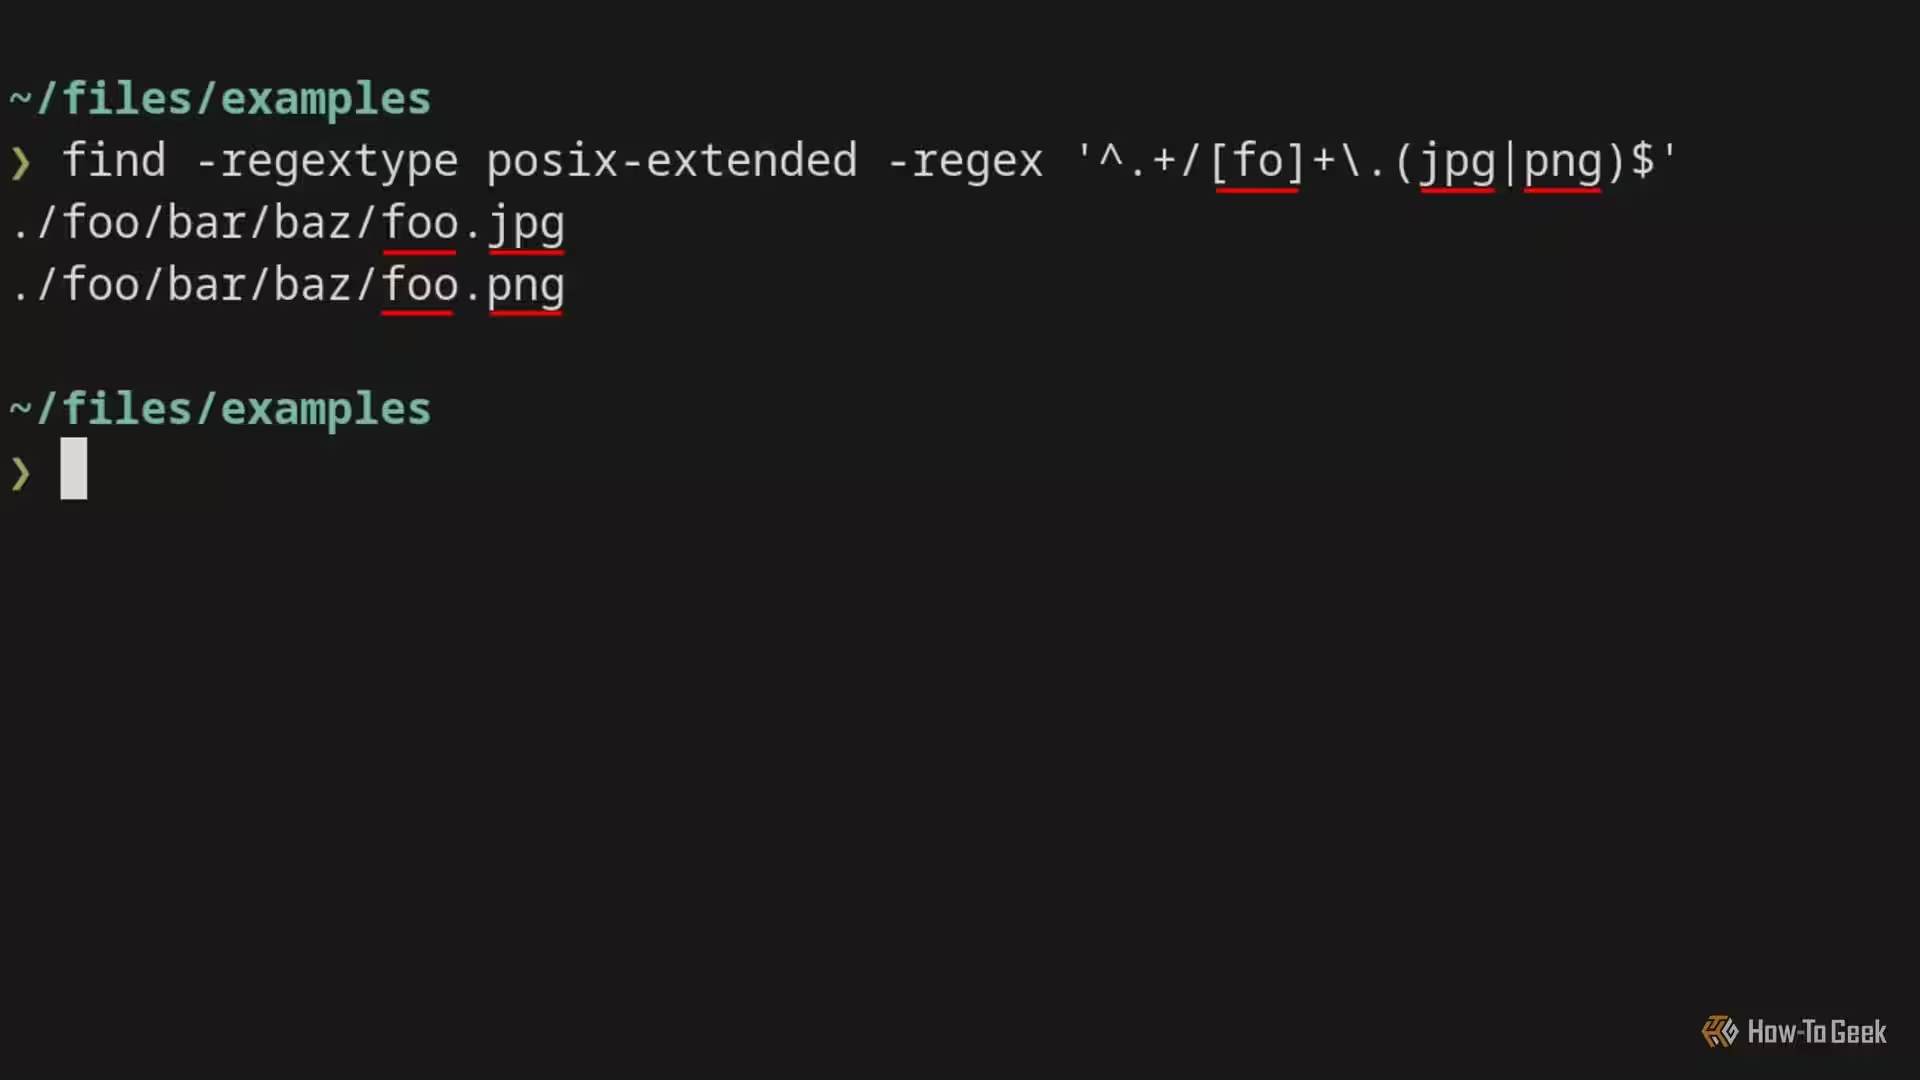
このコマンドが冗長に感じる場合は、おそらくエイリアスを使用して正規表現のオプションをデフォルトで設定するべきです。
正規表現を使用したfd
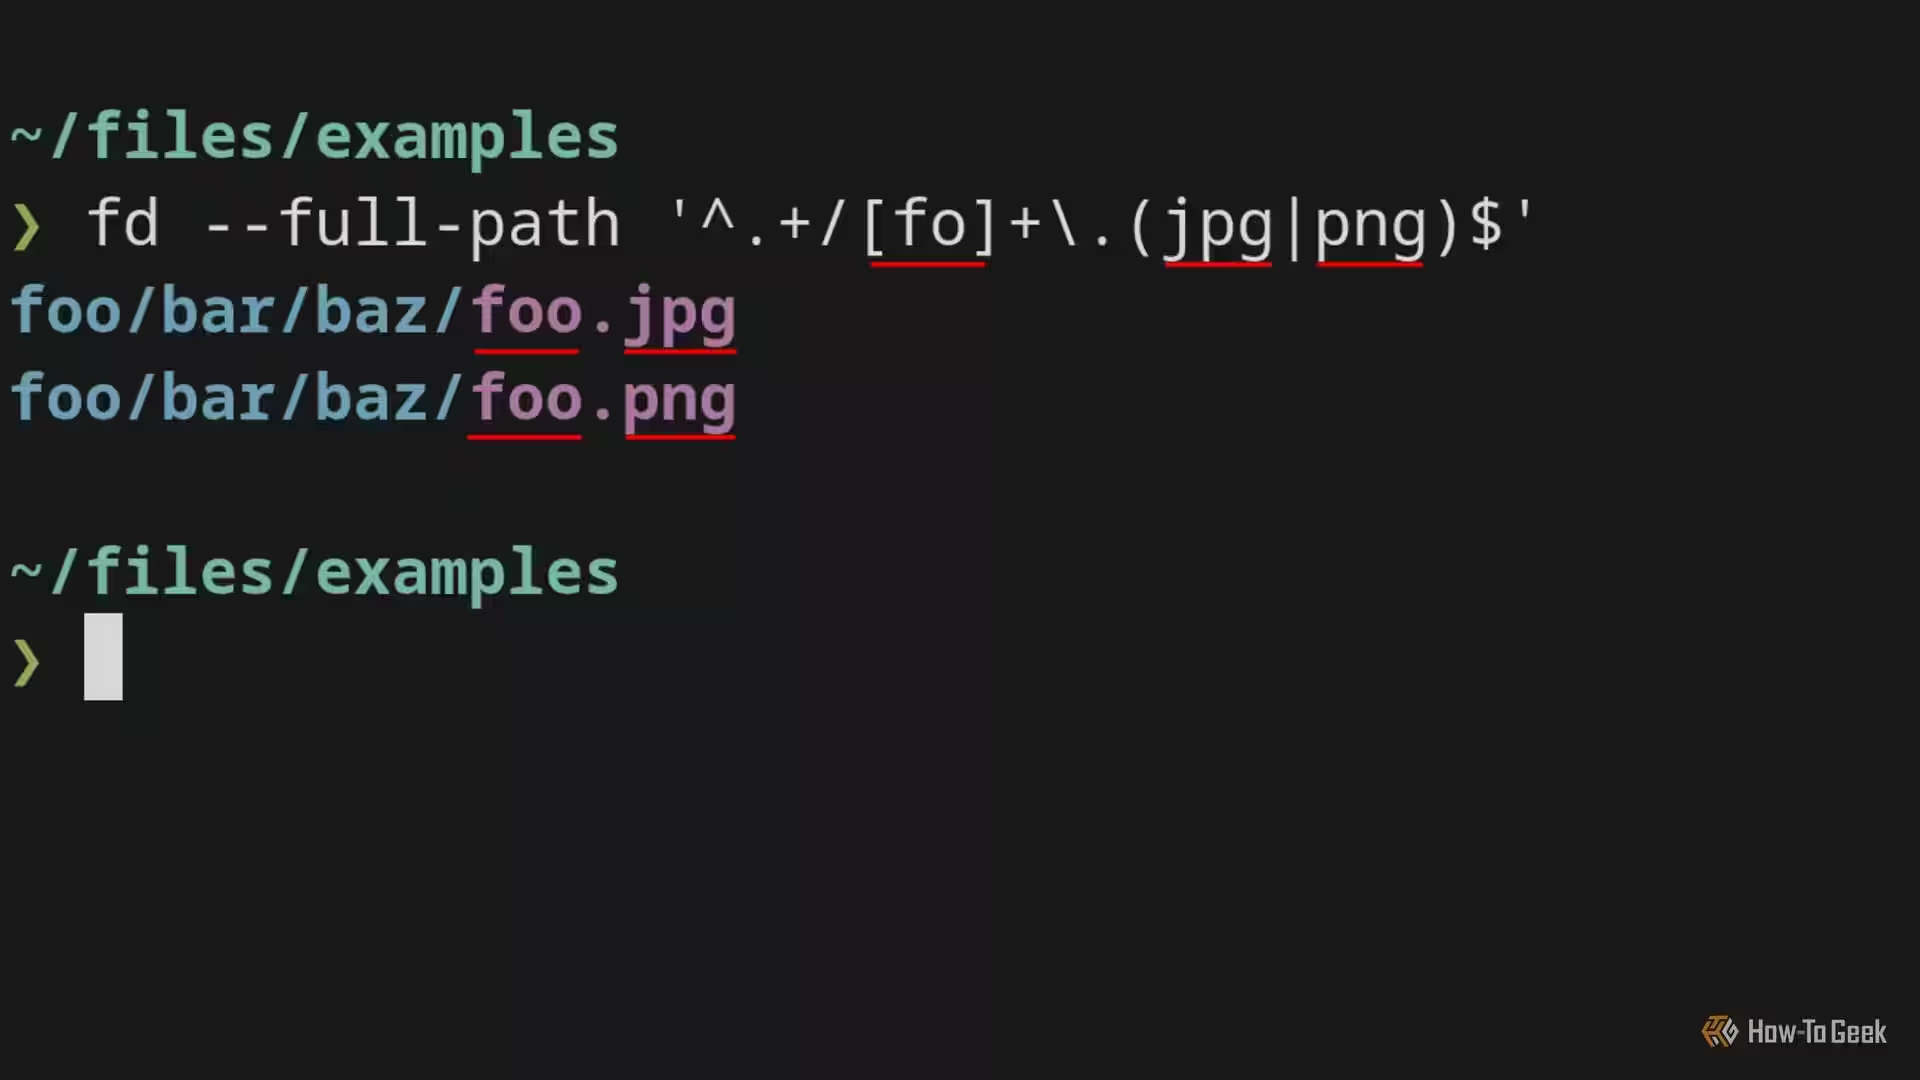
fdコマンドは、正規表現にRustクレート(Rustパッケージ)を使用しています。regexクレートはほぼPCREと互換性があるため、あまり気にせずに使うことができます。しかし、デフォルトでは、fdはファイル名のみにマッチするため、ファイルパス全体にマッチさせたい場合は--full-pathフラグを使用する必要があります。
正規表現を使ったripgrepの使用
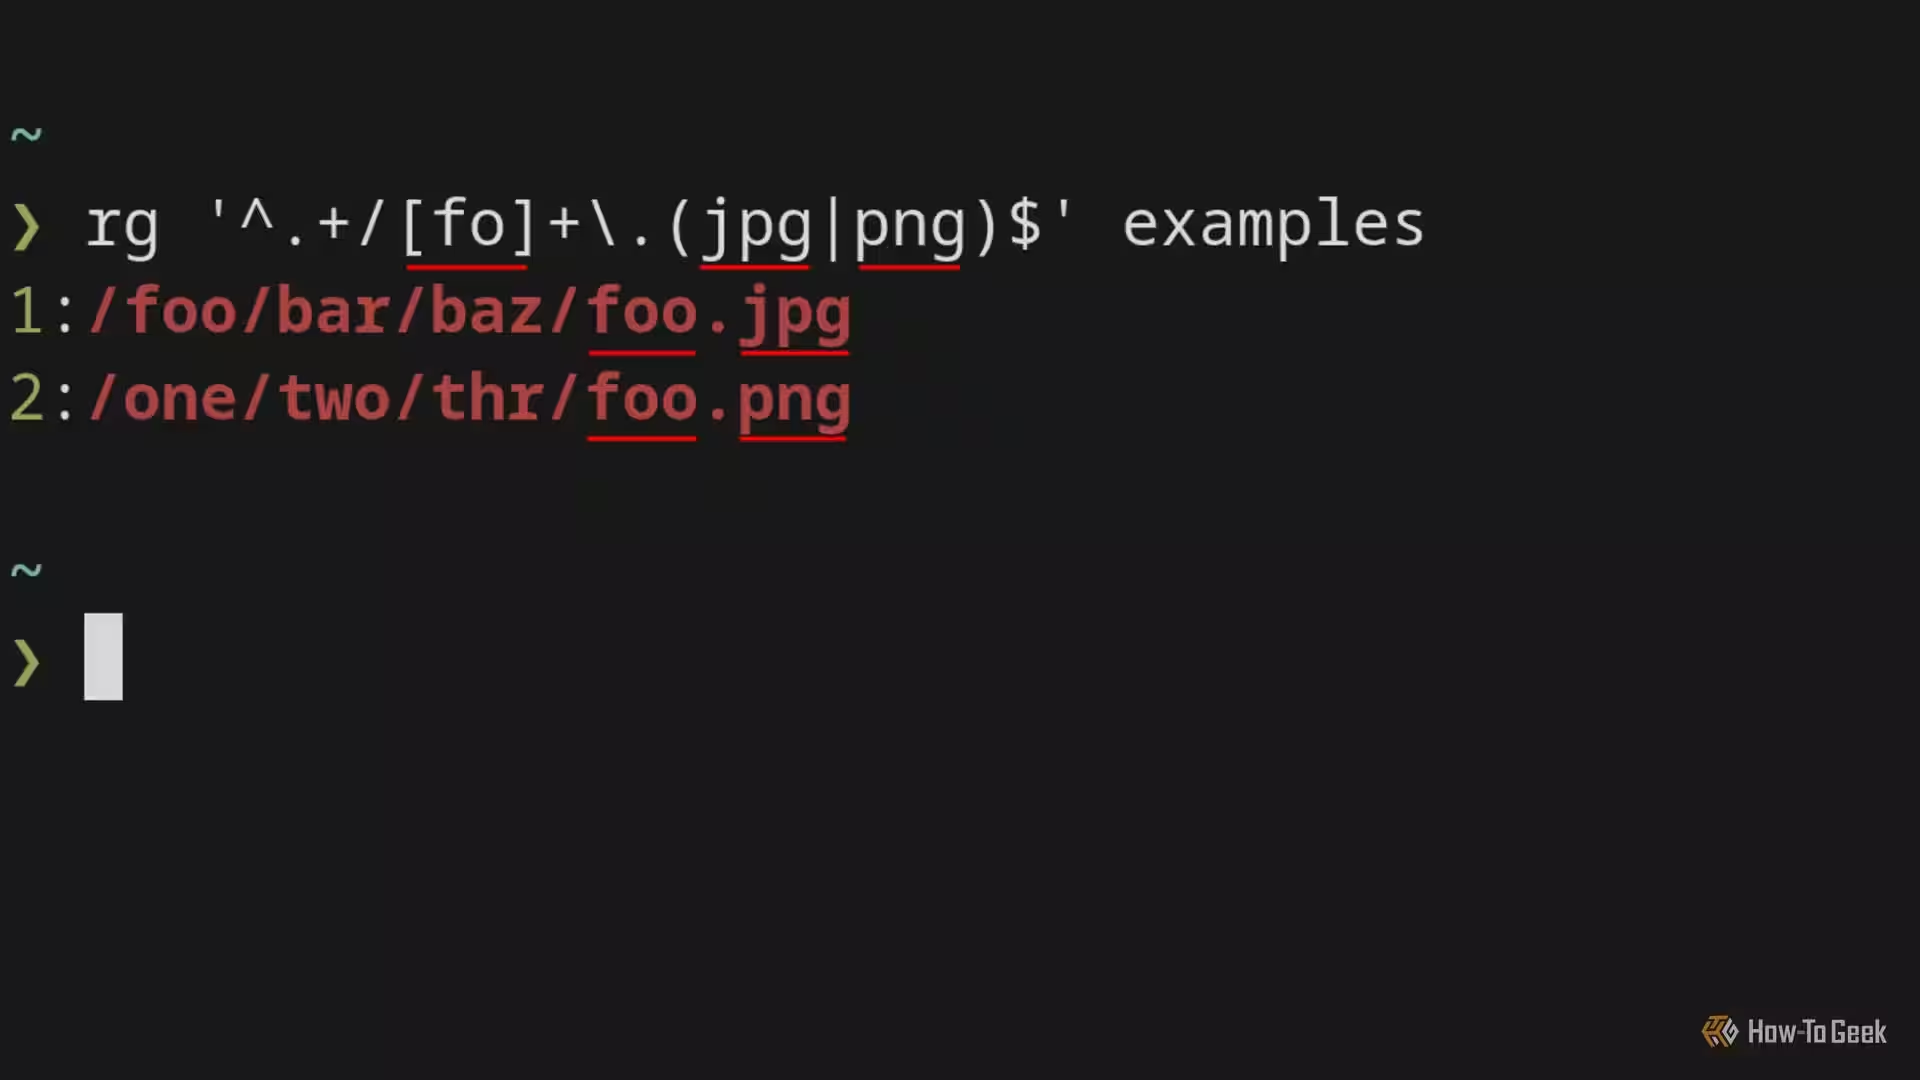
ripgrepコマンドで正規表現を使用するのは簡単です。なぜなら、それはRustクレートを使用しているからです。前に述べたように、RustクレートはPCREと密接に一致しています。
正規表現を使用したsed
sedコマンドは他のコマンドとは異なり、文字列の検索と置換を可能にします。これに不慣れな場合は、sedコマンドの使い方に関する素晴らしいガイドをチェックすることをお勧めします。コマンドの一般的な形式は次のとおりです:
s/pattern/replacement/スラッシュを使用する必要はありません。使用したい任意の文字を使うことができます。以下の例では、sedを混乱させないようにスラッシュの代わりにパイプ文字を使用しました。パイプを使用することで、提供された置換値(パス)内のスラッシュをエスケープする必要がなくなります。
sedのためには、GNU ERE正規表現フレーバーを使用する必要があり、-Eフラグを使います。GNU EREで機能するすべてのものはPCREでも機能するので、私たちにとっては良いです。
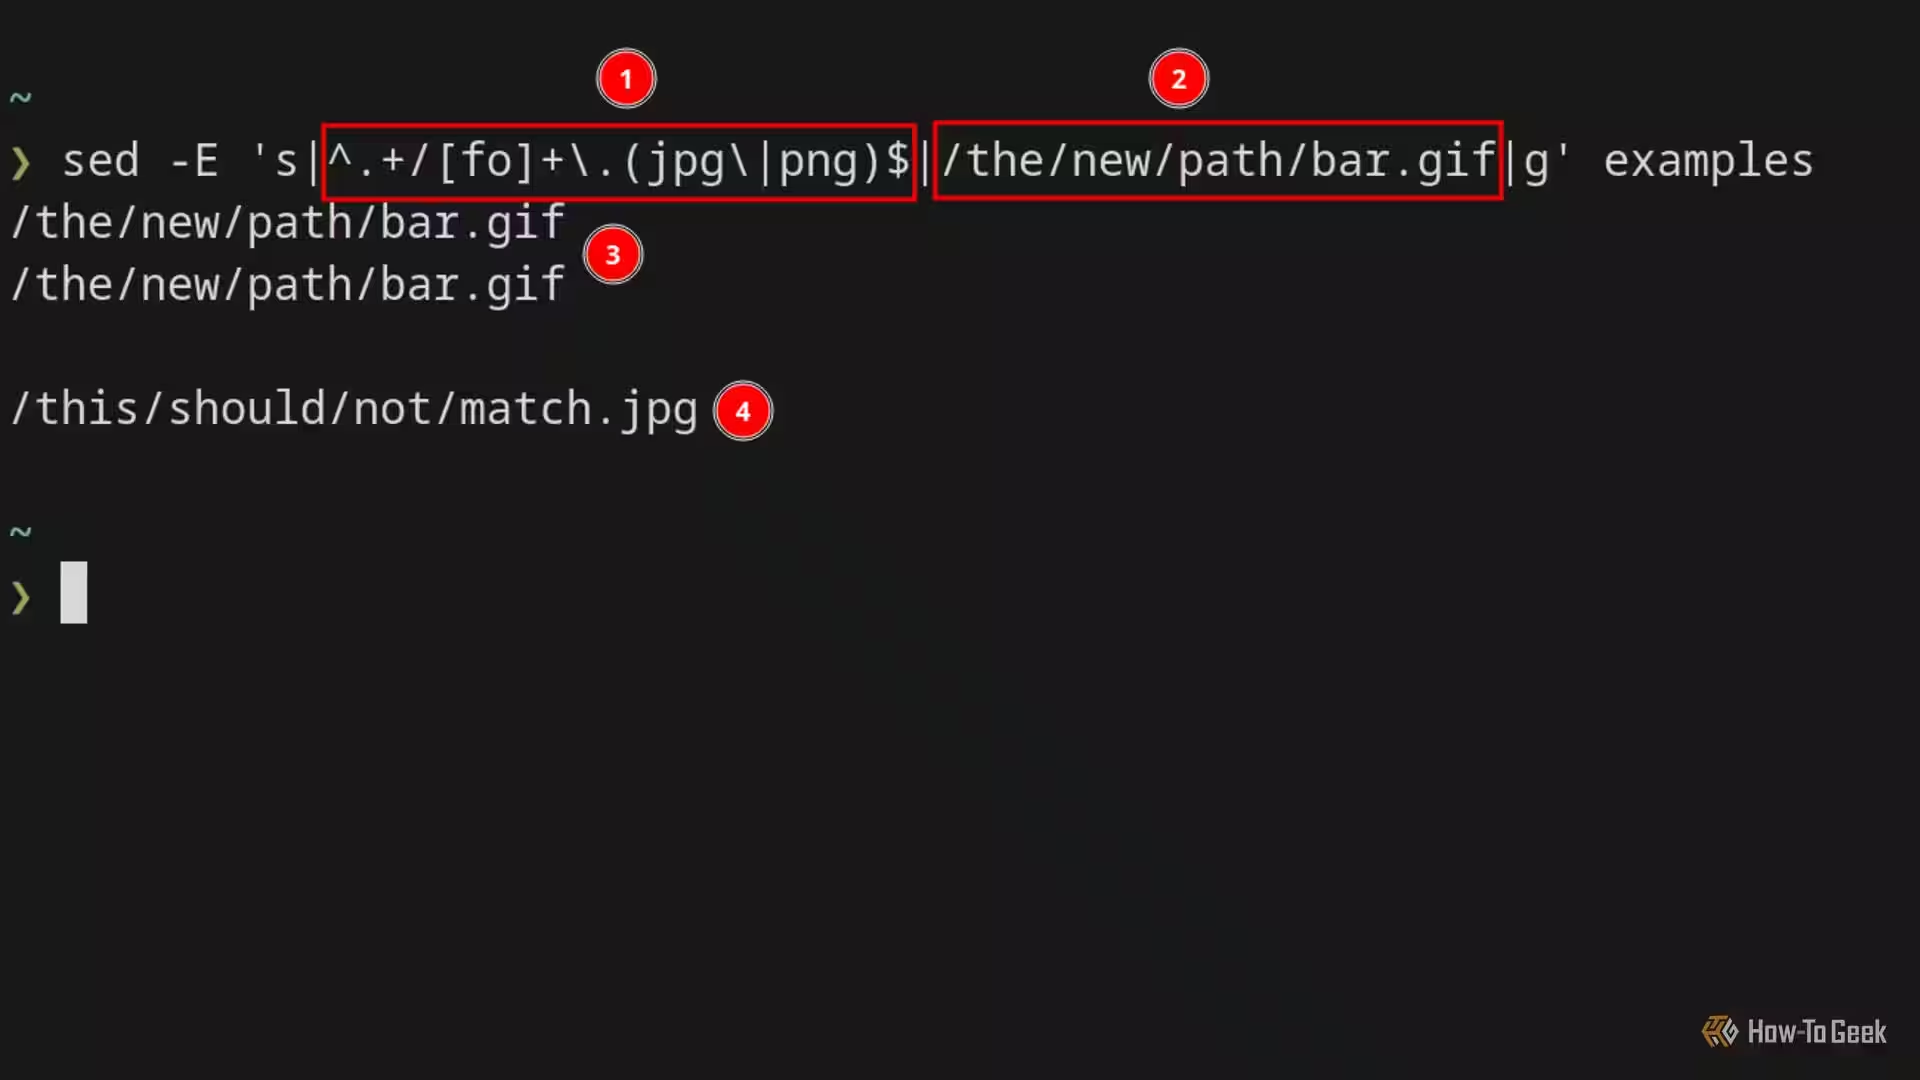
番号1はパターンです。番号2は一致した行を置き換えるための希望する値です。番号3は、新しい値で置き換えられた一致した行を示しています。番号4は、一致しなかったファイルの行で、修正されずにそのまま残されています。
この例では、結果を抽出し、ファイルパスを置き換えました。これはcatやgrepが動作するのと似ていますが、sedは-iフラグを使用してインプレース編集もサポートしています。
それで、それが正規表現の基本です。基本を理解すれば非常に遠くまで進むことができます。重要なことは、多くのユーティリティが異なる正規表現のフレーバーを使用しているため、挙げられたフラグから外れると、一部の機能が動作しないかもしれないということを覚えておくことです。
さらに、正規表現は本当に理解する前に触れておく必要があるものです。あなたはスキルを磨き、洞察を得て、より多くを学ぶことができるregex101という強力なオンラインプレイグラウンドを通じて、ヒントやガイダンスを提供しています。