畳み込みニューラルネットワークにおけるフィルター

多層パーセプトロン(MLP)では、学習可能なパラメータは特徴ベクトルにマッピングされるネットワークの重みです。しかし、畳み込みニューラルネットワークの文脈では、学習可能なパラメータはフィルタと呼ばれ、一般的にはサイズが正方形の2次元行列/配列です。この記事では、畳み込みニューラルネットワーク(CNN)の層を通過する際に、これらのフィルタが画像に実際に何をするのかを探っていきます。
前提条件
このチュートリアルを進めるためには、Pythonコードとニューラルネットワークに関する基本的な理解が必要です。新しいアーキテクチャの開発経験がある中級者から上級者向けのコーダーに、この資料をお勧めします。
この記事のコードは、通常の家庭用PCまたはDigitalOceanのDropletで実行できます。
ニューラルネットワークと特徴抽出
ニューラルネットワークの重要な能力は、データから特徴を抽出し、それを利用して特定の目標(分類、回帰など)を達成することである。MLP(多層パーセプロン)では、このプロセスは概念的に理解しやすい。データポイントは特定のデータインスタンスの属性であり、それらは訓練された重みとマッピングされ、何らかの形で結合または変換されて重要な特徴になる。一方、CNN(畳み込みニューラルネットワーク)に関しては、特徴抽出はそれほど明確ではない。というのも、CNNは属性のベクトルではなく、2次元の属性行列(ピクセル)である画像を扱うからである。
それにしても、画像に関して機能を表すものとは何でしょうか?例えば、家の表形式のデータセットについて話すとき、寝室の数やリビングルームのサイズなどの属性を持つ列は、特定の家のインスタンスの特徴と見なされます。それでは、サイズが(640、480)ピクセルの強化された定義(480p)の猫の画像についてはどうでしょうか?この画像は640列と480行を持ち、合計307,200の属性(ピクセル)があります。この場合、機能を表すものは何ですか?
エッジの上の画像
画像を構成する多くの詳細は、実際にはそのエッジまたは輪郭に含まれています。これが、私たちが漫画のスケッチで物体を簡単に区別できる理由の一つです。実際、視覚的な手がかりを処理する際に人間の脳が最初に使用する技術の一つであることを示唆する多くの研究があります(ウィリアム・マクイラッガ、2018年)。エッジ知覚は人間の視覚に限らず、一部の研究は、鳥類(アビアン)が空中で高い速度で障害物を避けるのが得意であり、遠くから小さな標的に的確に着地する理由の一つであると主張しています(パルタ・バガバトゥラら、2009年)。

私たちが持っている唯一の情報はエッジだけであり、私たちは皆これが何であるかを知っています。
CNNと人間の視覚
ニューラルネットワークが人間の脳を模倣することについて多くの議論があります。このことに一定の信憑性を与えるシナリオの一つは、人間の脳が目からの視覚的な手がかりを処理し始める際にエッジを認識するのと同様に、畳み込みニューラルネットワークも画像からエッジを検出することによって特徴を抽出し始めるという事実です。実際、エッジは画像の特徴を表していると言えます。この目的のために使用されるツールは、学習可能なパラメータやフィルターです。
それは特に畳み込みニューラルネットワークにおけるフィルターの役割であり、画像から特徴を抽出するのを助けるために存在しています。CNNの最初の数層はエッジ検出フィルター(低レベルの特徴抽出)で構成されており、深い層はしばしば画像の特定の形状や物体に焦点を当てることを学習します。この記事の目的のために、私は最初の数層におけるエッジ検出に焦点を当てるつもりです。このプロセスは非常に興味深く、フィルターも容易に理解できます。
エッジをフィルタリングする
畳み込みニューラルネットワークの素晴らしい点は、特定のデータセットにおけるピクセルの確率分布とネットワークの特定の目的に基づいて、カスタムのエッジ検出フィルタを学習できることです。それにもかかわらず、コンピュータビジョンの文脈でエッジ検出がどのように見えるかの直感を得るために使用できる、いくつかの古典的な手動で定式化されたエッジ検出フィルタがあります。それらは、プレウィット、ソーベル、ラプラシアン、ロビンソンコンパス、およびクリシュコンパスフィルタです。
これらのフィルターが実際に何をするのかをよく調べるために、以下に示す手動で書かれた畳み込み関数を使用して画像に適用する作業を行いましょう。
import numpy as np
import torch
import torch.nn.functional as F
import cv2
from tqdm import tqdm
import matplotlib.pyplot as plt


def convolve(image_filepath, filter, title=''):
    """
    This function performs convolution and
    returns both the original and convolved
    images.
    """

    #  reading image in grayscale format
    image = cv2.imread(image_filepath, cv2.IMREAD_GRAYSCALE)

    #  defining filter size
    filter_size = filter.shape[0]

    #  creating an array to store convolutions (x-m+1, y-n+1)
    convolved = np.zeros(((image.shape[0] - filter_size) + 1,
                      (image.shape[1] - filter_size) + 1))

    #  performing convolution
    for i in tqdm(range(image.shape[0])):
      for j in range(image.shape[1]):
        try:
          convolved[i,j] = (image[i:(i+filter_size),
                                  j:(j+filter_size)] * filter).sum()
        except Exception:
          pass

    #  converting to tensor
    convolved = torch.tensor(convolved)
    #  applying relu activation
    convolved = F.relu(convolved)

    #  producing plots
    figure, axes = plt.subplots(1,2, dpi=120)
    plt.suptitle(title)
    axes[0].imshow(image, cmap='gray')
    axes[0].axis('off')
    axes[0].set_title('original')
    axes[1].imshow(convolved, cmap='gray')
    axes[1].axis('off')
    axes[1].set_title('convolved')
    pass
畳み込み関数。
この関数は、典型的な畳み込みネットワークで期待されるように、ReLU活性化の追加ステップを伴って畳み込みプロセスを複製します。この関数を利用して、上記にリストされたフィルターを使用して、以下の画像のエッジを検出します。

標本
プレウィットフィルター

垂直および水平のプレウィットフィルター。
プレウィットオペレーターは、垂直および水平のエッジを検出するために役立つ2つのフィルターで構成されています。水平(x方向)フィルターは、画像内の水平軸を垂直に切るエッジを検出するのに役立ち、一方で垂直(y方向)フィルターはその逆です。
utilizing the horizontal filter
convolve('image.jpg', horizontal)

utilizing the vertical filter
convolve('image.jpg', vertical)

ソベルフィルター

縦と横のソーベルフィルター
プリwitt 演算子と同様に、Sobel 演算子も縦と横のエッジ検出フィルターで構成されています。検出されたエッジは、Prewitt フィルターを使用した場合とかなり似ていますが、エッジのピクセルの強度が高いという違いがあります。言い換えれば、Sobel フィルターを使用して検出されたエッジは、Prewitt フィルターに比べてシャープです。
utilizing the horizontal filter
convolve('image.jpg', horizontal)

utilizing the vertical filter
convolve('image.jpg', vertical)

ラプラスフィルター

ラプラスフィルター
プレウィットフィルターやソーベルフィルターとは異なり、ラプラスフィルターは異なる方向のエッジを検出する単一のフィルターです。数学的な観点から、ラプラスフィルターはピクセル値の二次導関数を計算し、プレウィットフィルターやソーベルフィルターは一次導関数を計算します。
utilizing the filter
convolve('image.jpg', filter)

ロビンソンコンパスマスク

すべての8つのロビンソンコンパスマスク
ロビンソンコンパスマスクは、上の画像に示す8つの地理的方位に対応する8つの異なるフィルターで構成されたエッジ検出フィルターです。これらのフィルターは、これらの方位に沿ったエッジを検出するのに役立ちます。簡潔さのために、説明の目的で2つのフィルターのみが使用されています。
utilizing the north_west filter
convolve('image.jpg', north_west)

utilizing the north_east filter
convolve('image.jpg', north_east)

クリッシュコンパスマスク
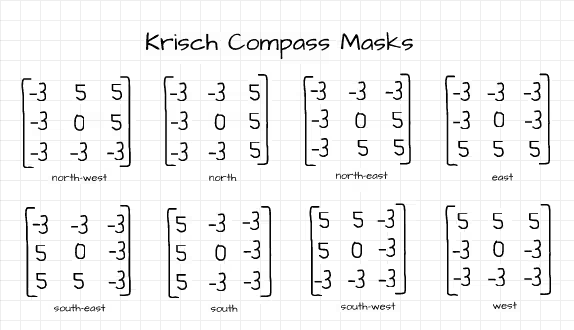
すべての8つのクリッシュコンパスマスク
ロビンソンコンパスマスクに似て、クリッシュコンパスマスクも地理的なコンパス方向のエッジを検出するのに役立つ8つのフィルターで構成されています。下の2つのフィルターが使用されています。
utilizing the south_west filter
convolve('image.jpg', south_west)

utilizing the south_east filter
convolve('image.jpg', south_east)

フィルタ表記
上にかなり重要な声明がありますので、おそらくそれを見逃したでしょう。
水平(x方向)フィルターは、画像内のエッジを検出するのに役立ちます。これらのエッジは水平軸を垂直に切断し、逆に垂直(y方向)フィルターはその逆の役割を果たします。
その声明は少し混乱を招くかもしれませんが、このセクションでさらに詳しく説明します。以下の画像を考えてみてください。右側の図は人間の目が見ているもの、左側の図はコンピュータが認識するものです。画像から明らかなように、白い線は黒い『キャンバス』上に明確な垂直のエッジを描いています。人間の目には、その線と周囲とのコントラストのために明白です。(同様に、コンピュータはこのコントラストの変化をピクセルレベルで認識できる必要があり、これがエッジ検出の本質です。)
しかし、このエッジに物理的に触れるためには、左から右(横方向)に指を動かす必要があります。またはその逆です。同じことはエッジ検出フィルターにも当てはまり、垂直エッジを検出するには水平フィルターを利用する必要があります。

あなたが見るもの VS コンピュータが「見る」もの
画像のエッジを水平および垂直のプレウィットフィルターを使用して検出してみましょう。エッジ検出プロセスの背後にある数学は、下の画像に示されています。畳み込みプロセスの背後にある数学は、説明されたように非常に理解しやすいです。
- フィルターを左上隅に置いてください。
- 要素ごとの乗算を行います。
- 累積和を計算する。
- 得られた合計を空の配列の対応するピクセルとして返します。
- フィルターを右に1ピクセル移動し、空の配列の最初の行を右に埋め続けるために、ステップ1から4を繰り返します。
- フィルターが境界外に出たら停止してください。
- フィルターを下に1ピクセルずらして2行目に移動してください。
- 空の配列の2行目を埋める際に、ステップ1から6を繰り返してください。
- フィルターが縦軸(次元1)で範囲外になるまで、すべての行に対して同じことを行ってください。
活性化はReLU関数を使用して行われ、負のピクセルは単純に0に変換されます。畳み込みと活性化の後、水平フィルターによって縦のエッジが強調され、縦フィルターは黒く塗りつぶされた画像(全てのピクセルがゼロ)を返し、エッジが検出されていないことを意味します。

エッジ検出の数学
結果として検出されたエッジが以下に視覚化されています。同じ論理に従うと、線が水平である場合、水平エッジを表し、垂直フィルターは水平エッジを強調し、水平フィルターは黒く塗りつぶされた画像を返します。

横フィルターによって検出されたエッジ
畳み込み関数の使用
異なる画像に上記の畳み込み関数を使用したり、エッジ検出や他の画像処理タスクのための異なるフィルターを試したい方のために、このセクションはその方法についての簡単なガイドです。
この関数は、‘image_filepath’、‘filter’、および‘title’の3つのパラメータを取ります。
‘画像ファイルパス’
これは、ローカルドライブまたはクラウド上での希望する画像の場所を指します。画像が現在の作業ディレクトリにある場合は、ファイル拡張子も含めて画像名を入力するだけで済みます。それ以外の場合は、絶対パスを提供する必要があります。例えば、‘C:/Users/Username/Downloads/image_name.jpg’のような形式です(Pythonで作業しているため、ここではスラッシュを使用します)。
フィルター
これは実際に畳み込みプロセスで使用したいフィルターです。フィルターは、以下に示すようにNumPyを使用して簡単に作成できます。その後は、フィルターオブジェクトを関数に供給するだけです。
 creating a Prewitt horizontal filter
prewitt_x = np.array(([-1, 0, 1],
                      [-1, 0, 1],
                      [-1, 0, 1]))

 creating a laplacian filter
laplacian = np.array(([-1, -1, -1],
                      [-1, 8, -1],
                      [-1, -1, -1]))
タイトル
これは関数が使用されたときに提供される画像の視覚化のタイトルになります。デフォルトでは空の文字列ですが、必要に応じて適切なタイトルを自由に提供してください。
最後の remarks
畳み込みニューラルネットワークを特別なものにしているのは、画像ピクセルのようなデータの2次元表現から特徴を抽出する能力です。特徴は、フィルタと呼ばれるニューラルネットワーク内のツールを使ってエッジとして抽出されます。
この記事では、事前に定義されたフィルターを使用して、コンピュータビジョンの観点からエッジ検出/特徴抽出がどのように見えるかを考察しました。ただし、CNNはエッジ検出のためにこれらの事前定義されたフィルターを使用しないことに注意する価値があります。むしろ、興味のあるデータセットでエッジを検出し特徴を抽出するための最良のフィルターを学習します。