畳み込みニューラルネットワークにおけるプーリング

紹介
‘プーリング’という用語は、畳み込みニューラルネットワークに精通している人にとっては馴染みのあるもので、各畳み込み層の後に一般的に使用されるプロセスです。この記事では、CNNアーキテクチャにおけるこの基本的なプロセスの背後にある理由と方法を探っていきます。
前提条件
畳み込みニューラルネットワーク(CNN)におけるプーリングを理解するためには、次の概念に慣れておく必要があります:
畳み込み演算: CNNにおける畳み込み層の働き、フィルター(カーネル)が入力データにどのように適用されて特徴マップを生成するかについての理解。ストライド、パディングのような概念を理解し、畳み込みが画像から特徴の空間的階層を抽出するのにどのように役立つかを理解する。
特徴マップ: フィルターを使用して入力画像から特徴マップがどのように作成されるか、そしてこれらのマップが異なる層でどのようにエッジやテクスチャーなどのさまざまな検出されたパターンを表すかの理解です。
-
活性化関数: 活性化関数(ReLUのような)は、ネットワークに非線形性を導入するために適用され、これによりネットワークは複雑なパターンを学習できるようになります。
これらの基本をしっかりと理解することは、空間的次元を減少させ、特徴抽出を強化し、CNNの効率を高めるプールの役割を理解するのに役立ちます。
プーリングプロセス
畳み込みに似て、プーリングプロセスもフィルター/カーネルを利用しますが、要素がない(空の配列のような)フィルターです。基本的には、このフィルターを画像の連続したパッチの上にスライドさせ、カーネルに捕まったピクセルを何らかの方法で処理することを含みます。基本的には畳み込み操作と同じです。
コンピュータビジョンの進展
深層学習フレームワークでは、畳み込みおよびプーリングクラスの動作を決定づける、あまり知られていないが非常に基本的なパラメータが存在します。一般的に、そのパラメータは、何らかの理由でスライディングウィンドウを使用するすべてのクラスの動作を制御します。そのパラメータは「ストライド」と呼ばれます。スライディングウィンドウと呼ばれるのは、フィルターを使って画像をスキャンすることが、画像のピクセル上に小さなウィンドウをスライドさせるのに似ているからです。
ストライドパラメータは、畳み込みやプーリングのようなスライディングウィンドウ操作を行う際に、フィルターがどの程度各次元でシフトされるかを決定します。

上の画像では、(6, 6)の画像に対してフィルターが次元0(横)と次元1(縦)の両方でスライドされています。ストライド=1のとき、フィルターは1ピクセルずつスライドします。しかし、ストライド=2のときはフィルターは2ピクセルスライドし、ストライド=3のときは3ピクセルスライドします。これはスライディングウィンドウプロセスを介して新しい画像を生成する際に興味深い効果をもたらします。両方の次元でストライドが2になると、基本的に元の画像の半分のサイズの画像が生成されます。同様に、ストライドが3の場合は、参照画像の3分の1のサイズの画像が生成されるなどです。
ストライドが1より大きいとき、基準画像のサイズの一部を表す表現が生成されます。
プーリング操作を行う際には、ストライドがデフォルトでフィルターのサイズと常に等しいことを注意することが重要です。例えば、(2, 2)のフィルターを使用する場合、ストライドはデフォルトで2の値になります。
プーリングの種類
CNNで使用されるプーリング操作には主に2つのタイプがあります。それは、マックスプーリングとアベレージプーリングです。これら2つのプーリング操作のグローバルなバリエーションも存在しますが、それはこの記事の範疇を超えています(グローバルマックスプーリングおよびグローバルアベレージプーリング)。
マックスプーリング
最大プーリングは、フィルターを使用して画像をスキャンし、各インスタンスでフィルター内で捕らえた最大のピクセル値を新しい画像の独自のピクセルとして返すことを含みます。

イラストから、空の (2, 2) フィルターが、上記のセクションで説明したように、ストライド 2 で (4, 4) 画像の上にスライドします。各インスタンスでの最大ピクセル値が独自の別のピクセルとして返され、新しい画像が形成されます。得られた画像は、元の画像の最大プール表現と呼ばれます(得られた画像は、前のセクションで説明したように、デフォルトのストライド 2 により元の画像の半分のサイズである点に注意してください)。
平均プーリング
最大プーリングと同様に、空のフィルターも画像の上をスライドさせますが、この場合はフィルターに捕らえられたすべてのピクセルの平均値が返され、元の画像の平均プーリング表現を形成します。以下に示すように。

マックスプーリング対アベレージプーリング
前のセクションのイラストから、最大プールされた表現のピクセル値が平均プールされた表現と比較してはるかに大きいことが明らかにわかります。より簡単に言うと、最大プールから得られる表現は、平均プールから得られる表現よりもしばしばシャープであるということを意味します。
プーリングの本質
私の以前の記事の一つで、畳み込みニューラルネットワークが畳み込みのプロセスを通じて画像からエッジとして特徴を抽出する方法について触れました。これらの抽出された特徴は特徴マップと呼ばれます。プーリングはこれらの特徴マップに対して作用し、特徴マップを見て、ダウンサンプリングと呼ばれるプロセスで小さなサイズの要約を生成することで、一種の主成分分析の役割を果たします(その概念についてかなり自由に述べさせてください)。
技術的な用語を避けて言えば、プーリングは参照画像のすべての重要な属性(ピクセル)を保持した小さいサイズの画像を生成します。基本的に、(400, 400) サイズの参照画像の一般的な詳細や構成を保持した(25, 25)ピクセルの車の画像を、(2, 2)カーネルを使用して4回繰り返しプーリングすることで生成することができます。これは、元の画像の一部である表現を生成するために、1より大きいストライドを利用して行われます。
CNN(畳み込みニューラルネットワーク)に戻ると、畳み込み層が深くなるにつれて、特徴マップ(畳み込みによって得られる表現)の数が増えます。特徴マップがネットワークに提供される画像と同じサイズである場合、特にトレーニング中にネットワーク内に存在する大量のデータのために計算速度が著しく低下します。これらの特徴マップを段階的にダウンサンプリングすることにより、特徴マップの数が増えてもネットワーク内のデータ量が効果的に制御されます。これは、ネットワークが前の畳み込み層によって抽出された重要な特徴を失うことなく、合理的な量のデータを扱うことができ、結果として計算が速くなることを意味します。
プーリングのもう一つの効果は、畳み込みニューラルネットワークをより堅牢にし、平行移動不変性を持たせることです。これは、ネットワークが画像内のオブジェクトの位置に関わらず、興味のあるオブジェクトから特徴を抽出できることを意味します(これについては次の記事で詳しく説明します)。
このセクションでは、プーリングプロセスを視覚化し、実際に何が起こるのかをよりよく理解するために、手動で作成したプーリング関数を使用します。最大プーリング用と平均プーリング用の2つの関数が提供されています。これらの関数を使用して、以下のサイズ (446, 550) ピクセルの画像をプールすることを試みます。

 import these dependencies
import torch
import numpy as np
import matplotlib.pyplot as plt
import torch.nn.functional as F
from tqdm import tqdm
これらの依存関係をインポートするのを忘れないでください
マックスプーリングの裏側
def max_pool(image_path, kernel_size=2, visualize=False, title=''):
      """
      This function replicates the maxpooling
      process
      """

      #  assessing image parameter
      if type(image_path) is np.ndarray and len(image_path.shape)==2:
        image = image_path
      else:
        image = cv2.imread(image_path, cv2.IMREAD_GRAYSCALE)

      #  creating an empty list to store convolutions
      pooled = np.zeros((image.shape[0]//kernel_size,
                        image.shape[1]//kernel_size))

      #  instantiating counter
      k=-1
      #  maxpooling
      for i in tqdm(range(0, image.shape[0], kernel_size)):
        k+=1
        l=-1
        if k==pooled.shape[0]:
          break
        for j in range(0, image.shape[1], kernel_size):
          l+=1
          if l==pooled.shape[1]:
            break
          try:
            pooled[k,l] = (image[i:(i+kernel_size),
                                j:(j+kernel_size)]).max()
          except ValueError:
            pass

      if visualize:
        #  displaying results
        figure, axes = plt.subplots(1,2, dpi=120)
        plt.suptitle(title)
        axes[0].imshow(image, cmap='gray')
        axes[0].set_title('reference image')
        axes[1].imshow(pooled, cmap='gray')
        axes[1].set_title('maxpooled')
      return pooled
上記の最大プーリング関数。
上記の関数は、最大プーリングプロセスを再現します。この関数を使用して、(2, 2) カーネルを使って参照画像を最大プールしてみましょう。
max_pool('image.jpg', 2, visualize=True)

各軸の数直線を見ると、画像のサイズが小さくなったことは明らかですが、すべての詳細がそのまま保持されています。まるでプロセスが最も顕著なピクセルを抽出し、参照画像の半分のサイズの要約された表現を生成したかのようです((2, 2)カーネルが使用されたため半分です)。
以下の関数は、最大プーリングプロセスのいくつかの反復を視覚化することを可能にします。
def visualize_pooling(image_path, iterations, kernel=2):
      """
      This function helps to visualise several
      iterations of the pooling process
      """
      image = cv2.imread(image_path, cv2.IMREAD_GRAYSCALE)

      #  creating empty list to hold pools
      pools = []
      pools.append(image)

      #  performing pooling
      for iteration in range(iterations):
        pool = max_pool(pools[-1], kernel)
        pools.append(pool)

      #  visualisation
      fig, axis = plt.subplots(1, len(pools), dpi=700)
      for i in range(len(pools)):
        axis[i].imshow(pools[i], cmap='gray')
        axis[i].set_title(f'{pools[i].shape}', fontsize=5)
        axis[i].axis('off')
      pass
上記に示したプーリング可視化機能。
この機能を使用すると、以下に示すように、(2, 2) フィルターを使って最大プールされた表現の3世代を可視化することができます。画像は(446, 450)ピクセルのサイズから(55, 56)ピクセルのサイズに変わります(実質的には1.5%の要約)、一般的な構成を維持しながら。
visualize_pooling('image.jpg', 3)

大きなカーネル(3, 3)を使用する効果は以下に示されており、予想通り参照画像は各反復ごとに1/3のサイズに減少します。3回目の反復までに、画素化された(16, 16)の下サンプリング表現が生成されます(0.1%の要約)。画素化されているものの、画像の全体的なアイデアはある程度維持されています。
visualize_pooling('image.jpg', 3, kernel=3)

畳み込みニューラルネットワークにおける最大プーリングプロセスがどのように見えるかを適切に模倣するために、プレウィットオペレーターを使用して画像内で検出された垂直エッジに対していくつかの反復を行いましょう。

第三回目の反復において、画像のサイズは縮小されましたが、その特徴(エッジ)が徐々に焦点を合わせられていることが確認できます。
舞台裏の平均プーリング
def average_pool(image_path, kernel_size=2, visualize=False, title=''):
      """
      This function replicates the averagepooling
      process
      """

      #  assessing image parameter
      if type(image_path) is np.ndarray and len(image_path.shape)==2:
        image = image_path
      else:
        image = cv2.imread(image_path, cv2.IMREAD_GRAYSCALE)

      #  creating an empty list to store convolutions
      pooled = np.zeros((image.shape[0]//kernel_size,
                        image.shape[1]//kernel_size))

      #  instantiating counter
      k=-1
      #  averagepooling
      for i in tqdm(range(0, image.shape[0], kernel_size)):
        k+=1
        l=-1
        if k==pooled.shape[0]:
          break
        for j in range(0, image.shape[1], kernel_size):
          l+=1
          if l==pooled.shape[1]:
            break
          try:
            pooled[k,l] = (image[i:(i+kernel_size),
                                j:(j+kernel_size)]).mean()
          except ValueError:
            pass

      if visualize:
        #  displaying results
        figure, axes = plt.subplots(1,2, dpi=120)
        plt.suptitle(title)
        axes[0].imshow(image, cmap='gray')
        axes[0].set_title('reference image')
        axes[1].imshow(pooled, cmap='gray')
        axes[1].set_title('averagepooled')
      return pooled
上記の平均プーリング関数。
上記の関数は、平均プーリングプロセスを再現します。これは、カーネルが画像の上をスライドする際にmean()メソッドを使用するという違いを除けば、最大プーリング関数と同一のコードです。参照画像の平均プーリングされた表現が以下に視覚化されています。
average_pool('image.jpg', 2, visualize=True)

最大プーリングと同様に、画像は最も重要な属性を保持しながら、そのサイズが半分に削減されたことがわかります。これは興味深いことで、最大プーリングとは異なり、平均プーリングは参照画像のピクセルを直接使用せず、基本的に新しい属性(ピクセル)を作成するためにそれらを組み合わせるため、参照画像の詳細が保持されています。
以下の視覚化機能を使用して、平均プーリングプロセスがどのように3回の反復を通じて進行するかを見てみましょう。
def visualize_pooling(image_path, iterations, kernel=2):
      """
      This function helps to visualise several
      iterations of the pooling process
      """
      image = cv2.imread(image_path, cv2.IMREAD_GRAYSCALE)

      #  creating empty list to hold pools
      pools = []
      pools.append(image)

      #  performing pooling
      for iteration in range(iterations):
        pool = average_pool(pools[-1], kernel)
        pools.append(pool)

      #  visualisation
      fig, axis = plt.subplots(1, len(pools), dpi=700)
      for i in range(len(pools)):
        axis[i].imshow(pools[i], cmap='gray')
        axis[i].set_title(f'{pools[i].shape}', fontsize=5)
        axis[i].axis('off')
      pass
プーリング可視化機能。
再び、各反復ごとに画像サイズが半分に減少していく一方で、その詳細は残りますが、徐々にピクセル化していきます(小さいサイズの画像では予想通りです)。
visualize_pooling('image.jpg', 3)

平均プーリングを(3, 3)カーネルで行うと、以下の結果が得られます。予想通り、画像サイズは前の値の1/3に減少します。最大プーリングと同様に、3回の反復で強いピクセル化が始まりますが、画像の全体的な属性は比較的 intact に保たれています。
visualize_pooling('image.jpg', 3, kernel=3)

プリウィットオペレーターを使用して検出された垂直エッジに対して、(2, 2) のランニング平均プーリングを行うと、以下の結果が得られます。最大プーリングと同様に、進行する平均プーリングによって画像の特徴(エッジ)がより際立ってきます。

マックスプーリングそれともアベレージプーリング?
最大プーリングと平均プーリングのプロセスの両方について学習した後の自然な反応は、どちらがコンピュータビジョンのアプリケーションにとってより優れているのか疑問に思うことです。実際のところ、どちらの主張も成立します。
一方で、最大プーリングはカーネルでキャッチされた最高のピクセル値を選択するため、はるかにシャープな表現を生成します。
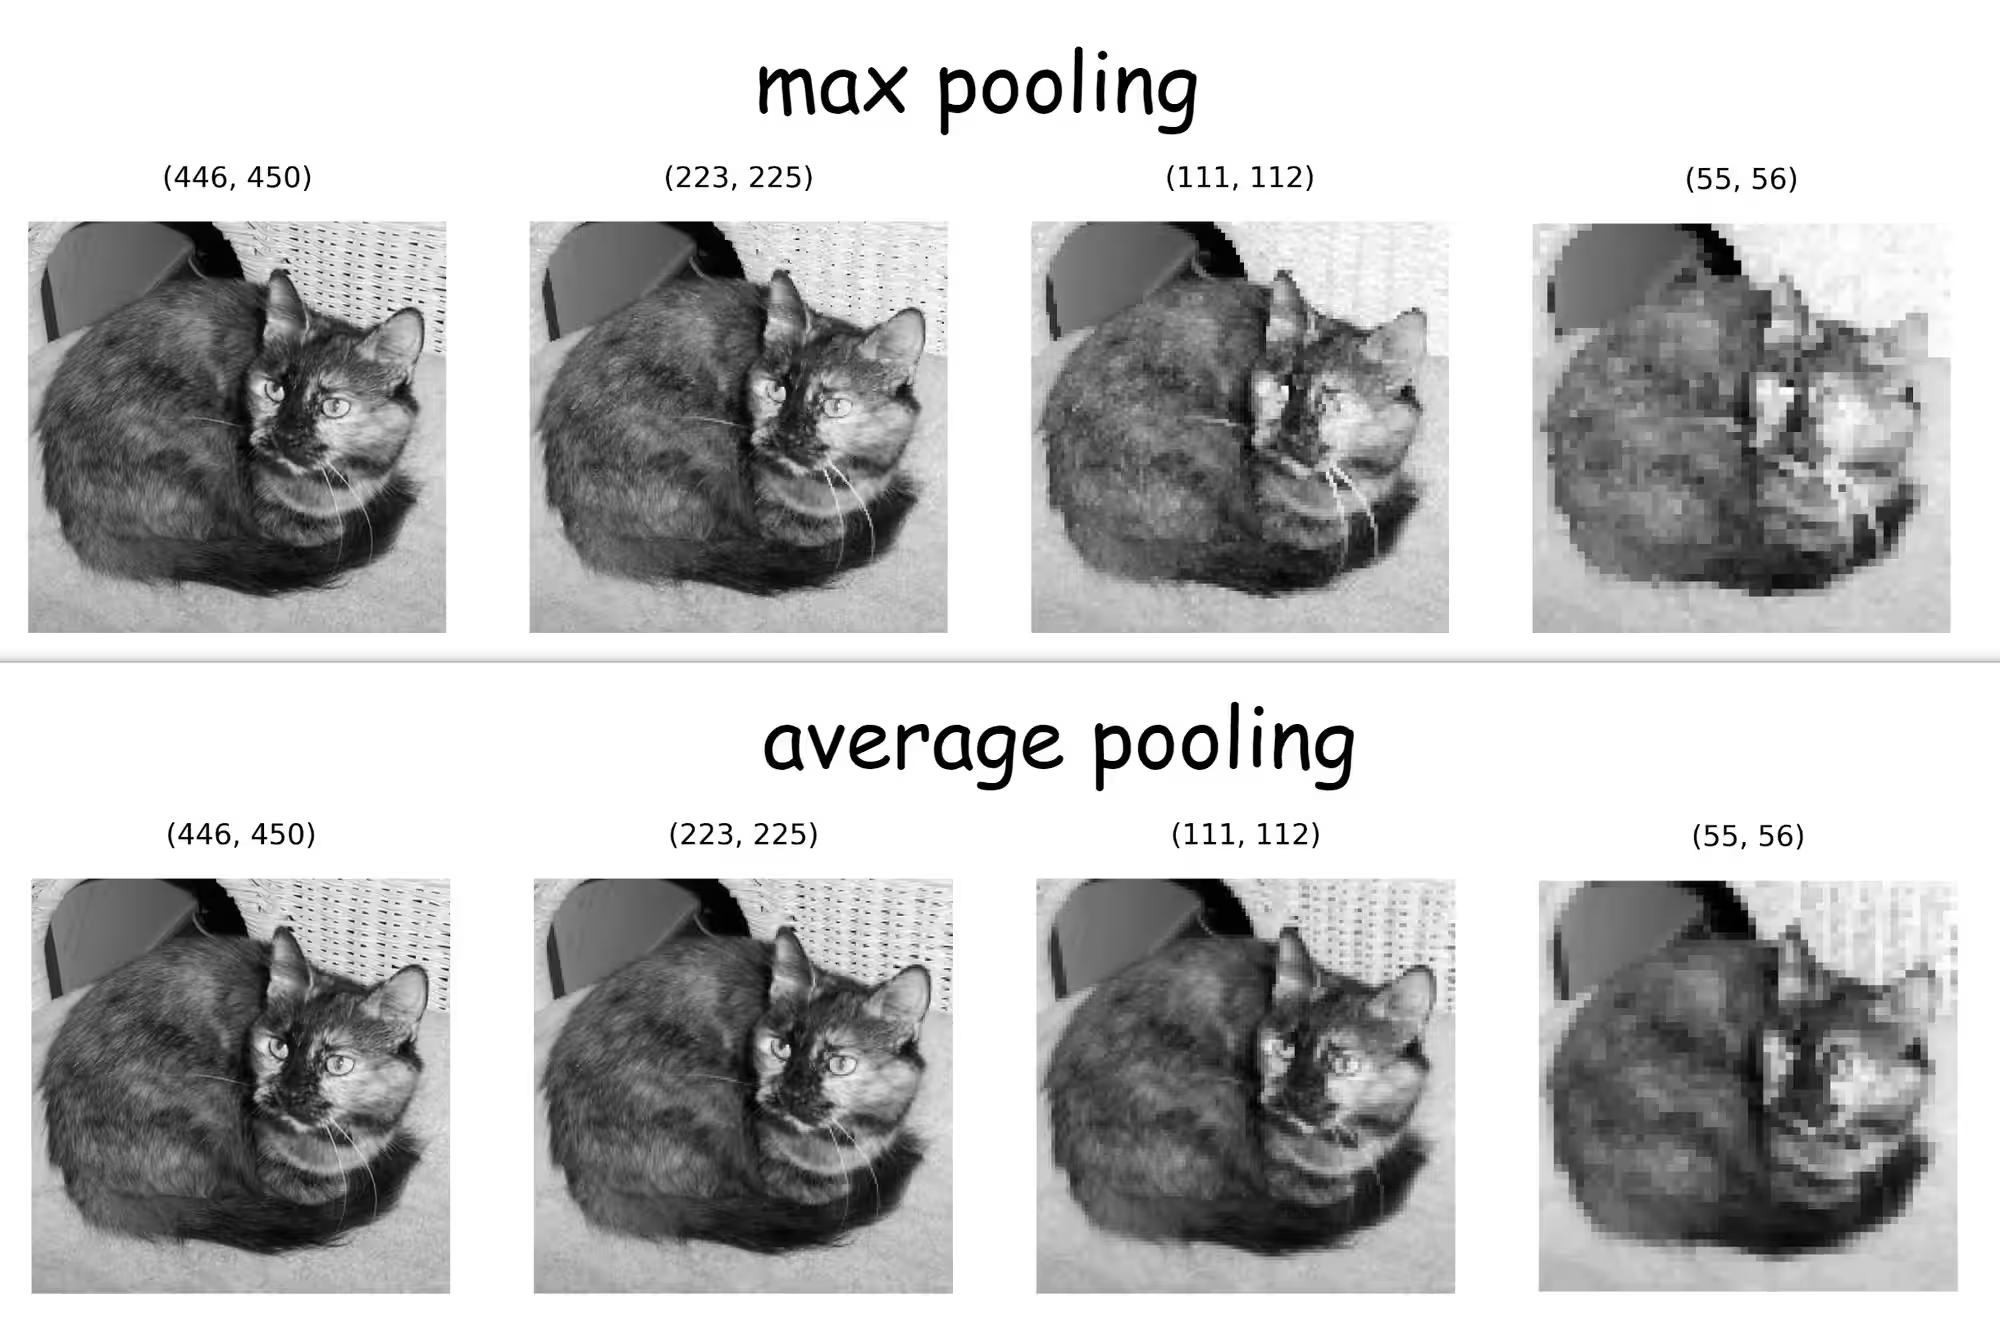
畳み込みニューラルネットワークの文脈では、それは下の画像に見られるように、特徴マップで検出されたエッジをより明確にする仕事をするということです。

一方で、平均プーリングがより一般化された特徴マップを生成するという主張ができます。サイズ(444, 448)の参照画像を考えてみましょう。サイズ(2, 2)のカーネルでプーリングを行うと、そのプーリングされた表現はサイズ(222, 224)になります。これは基本的に参照画像の全ピクセルの25%です。最大プーリングは基本的にピクセルを選択するため、データの損失を招き、それがネットワークの性能に悪影響を及ぼすという意見もあります。その対抗的な見解として、平均プーリングはピクセルを選択するのではなく、ピクセルを結合して平均値を計算するため、平均プーリングは明示的にデータを削除するのではなく、ピクセルを75%圧縮していると考える人もいます。これにより、より一般化された特徴マップが得られ、過学習に対抗するのがより効果的になると言えます。
私はどちらの側に属しているのでしょうか?個人的には、マックスプーリングが特徴マップのエッジをより際立たせる能力があり、コンピュータビジョンやディープラーニングのアプリケーションで優位性を持つと思います。だからこそ、マックスプーリングの方が一般的に人気があるのです。ただし、平均プーリングの使用がネットワークのパフォーマンスを著しく低下させるわけではないということも付け加えておきますが、これはあくまで私の個人的な意見です。
最後の remarks
この記事では、畳み込みニューラルネットワークにおけるプーリングの直感を育んできました。私たちは、2つの主要なプーリングのタイプと、それぞれが生成するプーリングされた表現の違いを見てきました。
CNNにおけるプーリングに関する多くの議論がある中で、最近のほとんどのアーキテクチャは、ネットワークの複雑さを減らすためにプーリング層よりもストライド畳み込み層をダウンサンプリングに好む傾向があることを覚えておいてください。それにかかわらず、プーリングは畳み込みニューラルネットワークの重要な要素であり続けます。