畳み込みニューラルネットワークにおけるパディング

パディングは、畳み込みニューラルネットワークにおいて重要なプロセスです。必須ではありませんが、多くの最先端のCNNアーキテクチャでよく使用されるプロセスです。この記事では、なぜそれが行われるのか、どのように行われるのかを探ります。
畳み込みのメカニズム
画像処理/コンピュータビジョンの文脈における畳み込みは、画像がある種の方法で処理されるためにフィルターによって「スキャンされる」プロセスです。詳細について少し技術的になりましょう。
コンピュータにとって、画像は単に数値型(整数または浮動小数点)の配列であり、これらの数値型は適切にピクセルと呼ばれます。実際、1920ピクセル × 1080ピクセル(1080p)のHD画像は、1080行と1920列の数値型のテーブル/配列に過ぎません。一方、フィルターは基本的には同じですが、通常は小さいサイズです。一般的な(3, 3)畳み込みフィルターは、3行と3列の配列です。
画像に畳み込みが行われると、フィルターが画像の連続したパッチに適用されます。ここで、フィルターの要素とそのパッチのピクセルの間で要素ごとの乗算が行われ、累積和が新しいピクセルとして返されます。例えば、(3, 3)フィルターを使用して畳み込みを行う場合、9つのピクセルが集約されて1つのピクセルが生成されます。この集約プロセスにより、一部のピクセルが失われます。
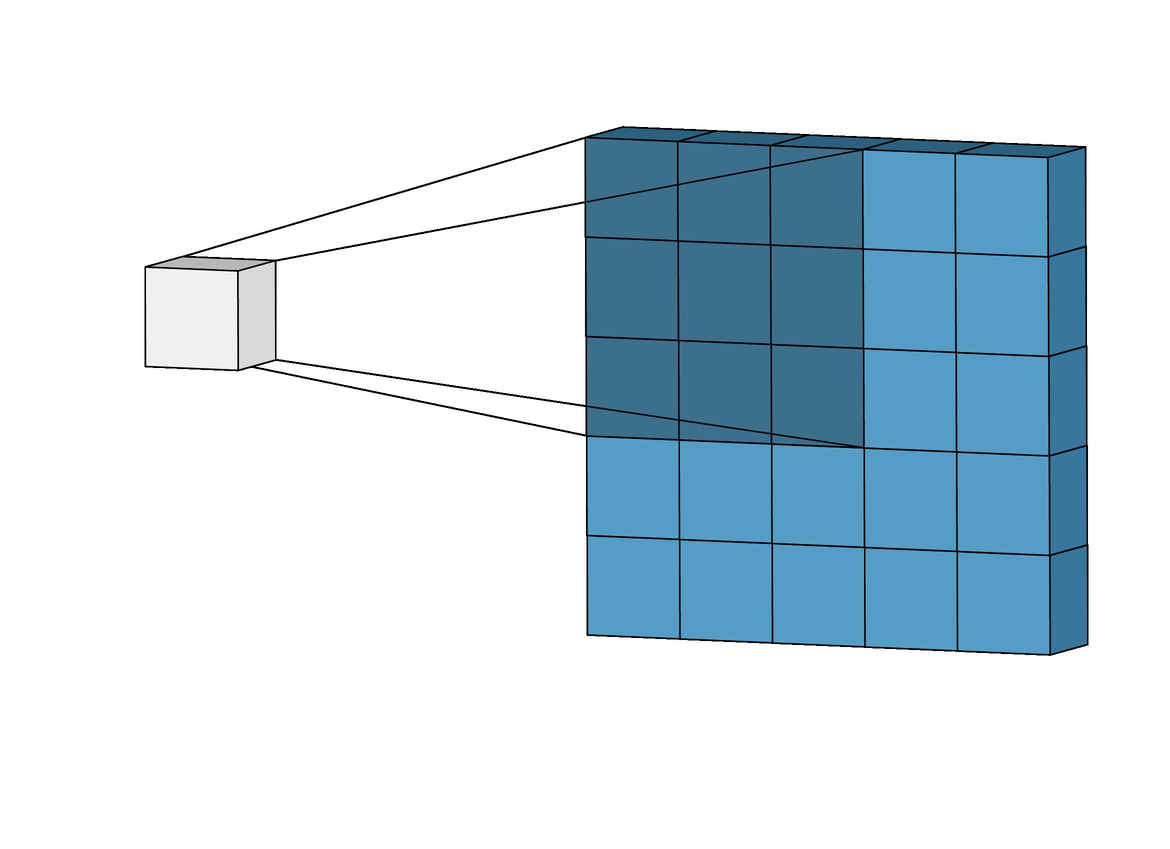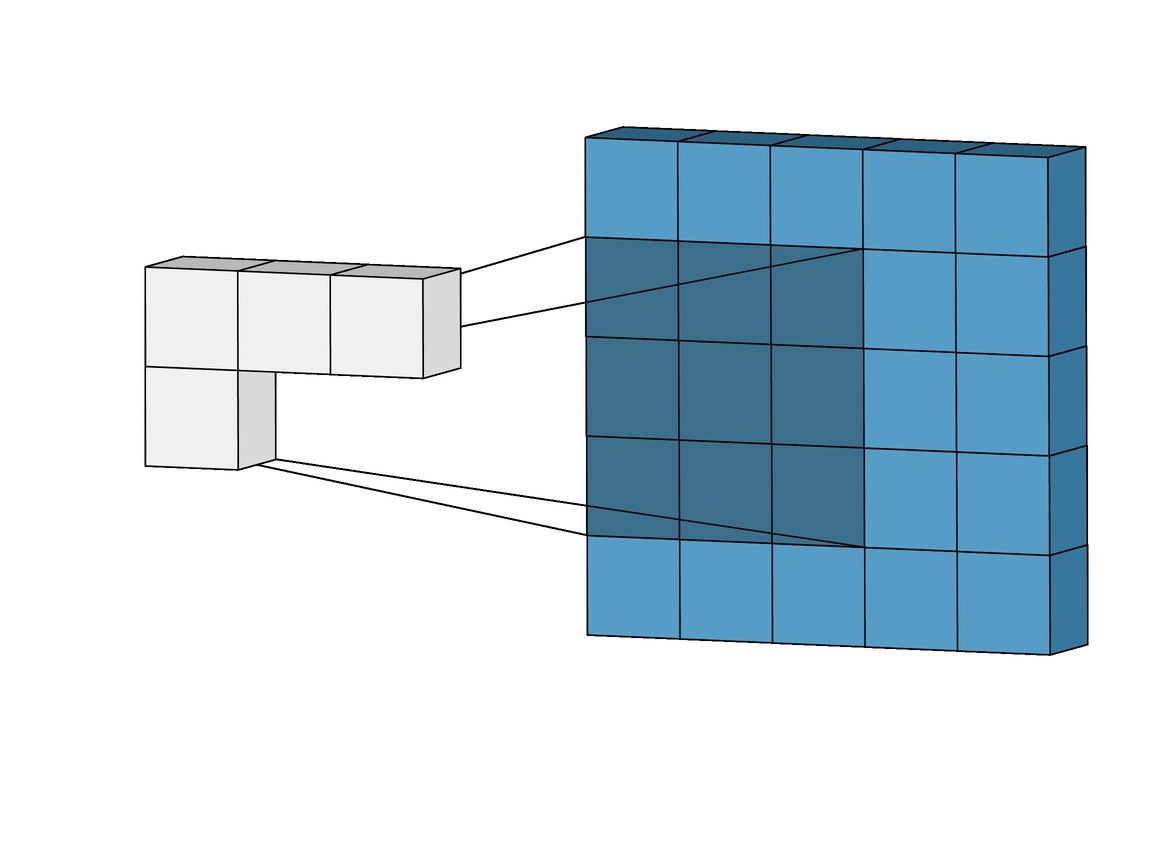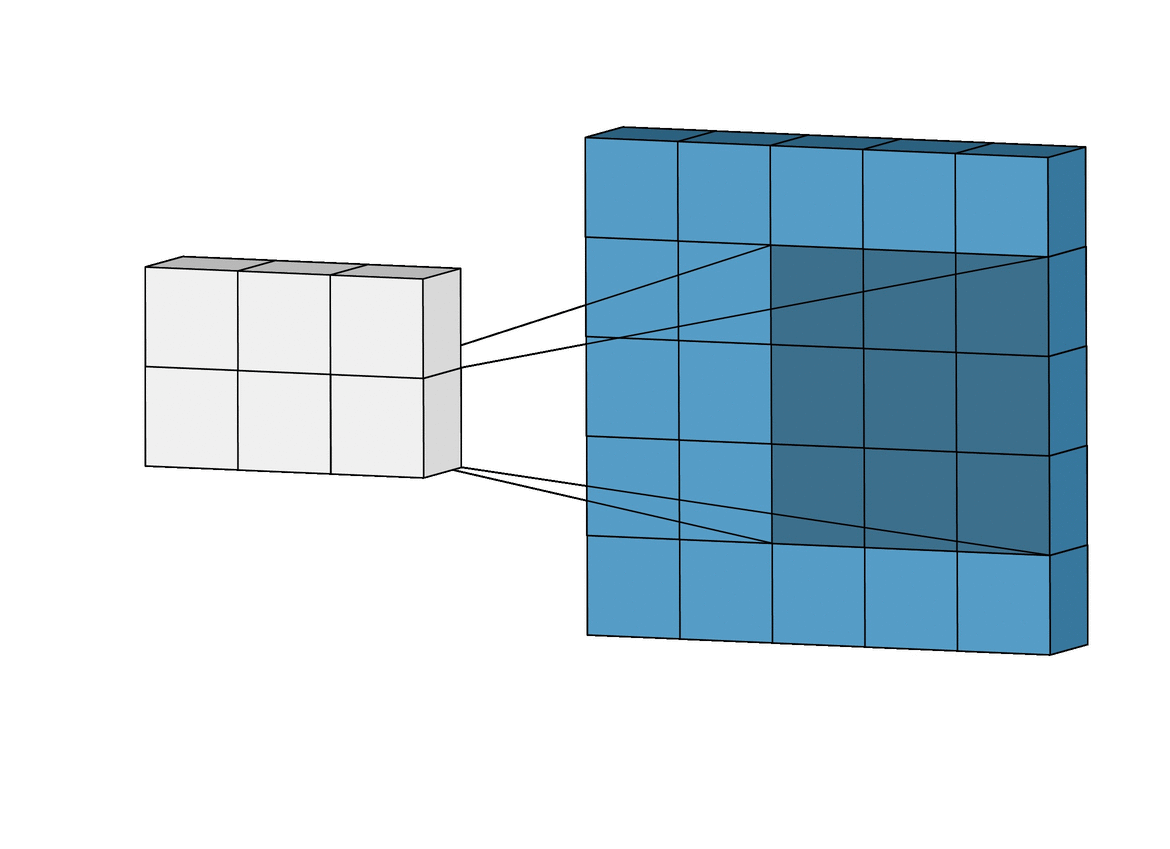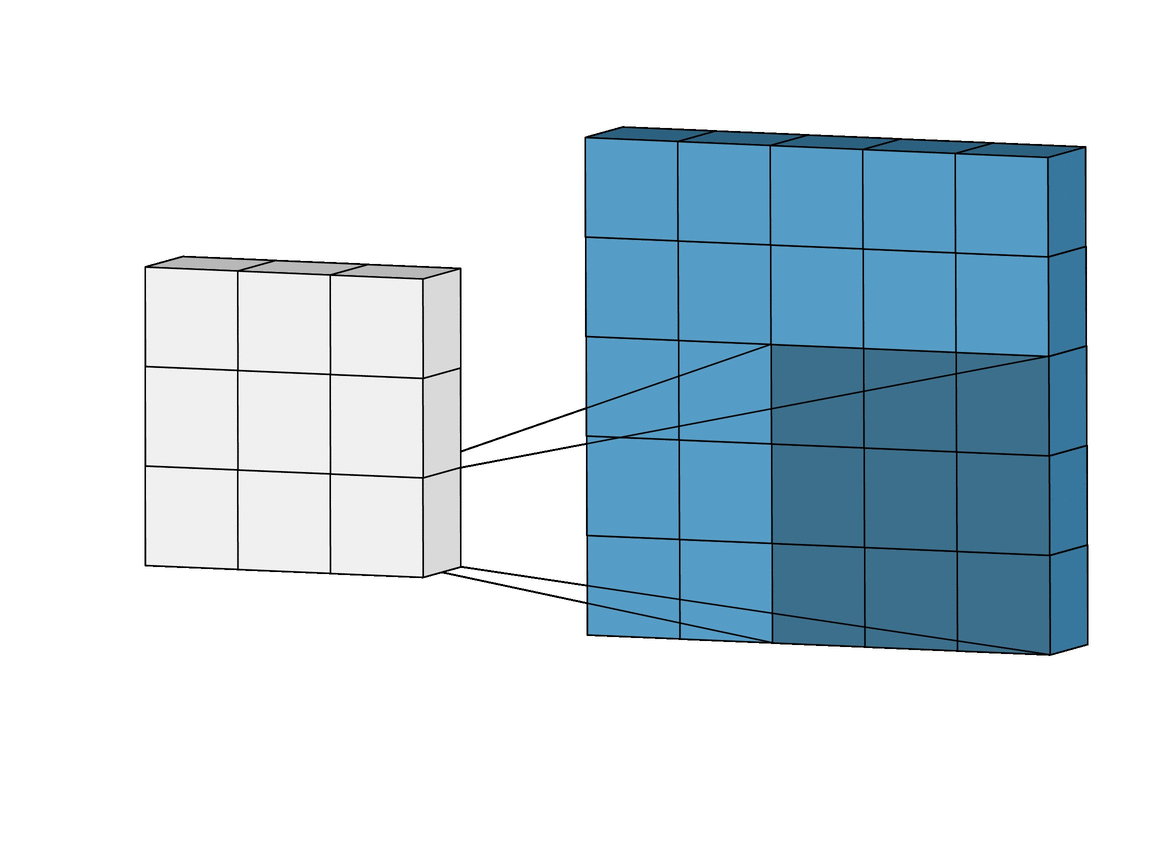
画像をスキャンして畳み込みを介して新しい画像を生成するフィルタ。
失われたピクセル
ピクセルが失われる理由を理解するには、畳み込みフィルターが画像をスキャンする際に境界を超えると、その特定の畳み込みインスタンスが無視されることを考慮してください。例を挙げると、6 x 6ピクセルの画像に3 x 3フィルターを畳み込む場合を考えます。以下の画像に示されているように、最初の4つの畳み込みは画像内に収まり、最初の行に4つのピクセルを生成しますが、5番目と6番目のインスタンスは境界を超え、したがって無視されます。同様に、フィルターが1ピクセル下に移動されると、同じパターンが繰り返され、2行目でも2つのピクセルが失われます。このプロセスが完了すると、6 x 6ピクセルの画像は4 x 4ピクセルの画像に変わります。なぜなら、dim 0(x)で2列のピクセルが失われ、dim 1(y)で2行のピクセルが失われるからです。

3x3フィルターを使用した畳み込みインスタンス。
同様に、5 x 5のフィルターを使用すると、dim 0(x)およびdim 1(y)のそれぞれで4列と4行のピクセルが失われ、その結果2 x 2ピクセルの画像になります。

5x5フィルターを使用した畳み込みインスタンス。
私の言葉を鵜呑みにしないでください。以下の関数を試して、実際にそうか確認してください。必要に応じて引数を調整してください。
import numpy as np
import torch
import torch.nn.functional as F
import cv2
import torch.nn as nn
from tqdm import tqdm
import matplotlib.pyplot as plt

def check_convolution(filter=(3,3), image_size=(6,6)):
    """
    This function creates a pseudo image, performs
    convolution and returns the size of both the pseudo
    and convolved image
    """
    #  creating pseudo image
    original_image = torch.ones(image_size)
    #  adding channel as typical to images (1 channel = grayscale)
    original_image = original_image.view(1, 6, 6)

    #  perfoming convolution
    conv_image = nn.Conv2d(1, 1, filter)(original_image)

    print(f'original image size: {original_image.shape}')
    print(f'image size after convolution: {conv_image.shape}')
    pass

check_convolution()
ピクセルが失われる方法にはパターンがあるようです。m x nフィルターが使用されると、次元0ではm-1列のピクセルが失われ、次元1ではn-1行のピクセルが失われるようです。もう少し数学的に考えてみましょう…
画像のサイズ=(x, y) フィルターのサイズ=(m, n) 畳み込み後の画像のサイズ=(x-(m-1), y-(n-1))=(x-m+1, y-n+1)
サイズ (x, y) の画像にサイズ (m, n) のフィルターを畳み込むと、サイズ (x-m+1, y-n+1) の画像が生成されます。
その式は少し複雑に見えるかもしれませんが(冗談ではありませんが)、その背後にある論理は非常に単純です。一般的なフィルターはほとんどが正方形のサイズであるため(両軸で同じ寸法)、(3, 3) フィルターを用いて畳み込みを行うと、2行と列のピクセルが失われることを知っておけば良いのです(3-1)。(5, 5) フィルターを用いると、4行と列のピクセルが失われ、(9, 9) フィルターを用いると、8行と列のピクセルが失われます(9-1)。
失われたピクセルの暗示
ピクセルの行と列を2つ失うことは、特に大きな画像を扱っているときには、それほど影響がないように思えるかもしれません。たとえば、4K UHD画像(3840、2160)は、(3、3)フィルターで畳み込むときにピクセルの行と列を2つ失っても(3838、2158)になり、全体のピクセル数の約0.1%を失うだけで、影響がないように見えます。問題は、最先端のCNNアーキテクチャに典型的なように、複数の畳み込み層が関与するときに始まります。たとえば、RESNET 128を考えてみましょう。このアーキテクチャには約50の(3、3)畳み込み層があり、約100行と列のピクセルが失われ、画像のサイズは(3740、2060)に減少します。これは、画像の総ピクセル数の約7.2%の損失に相当し、ダウンサンプリング操作を考慮に入れなくてもこの結果です。
浅いアーキテクチャでも、ピクセルを失うことは大きな影響を与える可能性があります。MNISTデータセットのサイズ(28, 28)の画像に適用された4つの畳み込み層だけのCNNは、8行と8列のピクセルを失うことになり、サイズが(20, 20)に縮小され、合計ピクセルの57.1%を失うことになります。これはかなりの損失です。
畳み込み演算は左から右、上から下へ行われるため、最も右側と下側のエッジでピクセルが失われます。したがって、畳み込みはエッジピクセルの損失を引き起こす、つまりコンピュータビジョンタスクに必要な特徴を含む可能性のあるピクセルが失われると言えるでしょう。
パディングを解決策として
畳み込みの後にピクセルが失われることがわかっているので、事前にピクセルを追加することでこれを防ぐことができます。例えば、(3, 3) フィルターを使用する場合、畳み込みが行われるときに画像のサイズが元の画像と同じになるように、事前に画像に2行と2列のピクセルを追加することができます。
もう一度少し数学的になりましょう…
画像サイズ=(x, y) フィルターサイズ=(m, n)
パディング後の画像サイズ=(x+2, y+2)
式を使用して ==>(x-m+1, y-n+1)
畳み込み後の画像サイズ (3, 3)=(x+2-3+1, y+2-3+1)=(x, y)
レイヤー用語でのパディング
数値データ型を扱っているため、追加のピクセルの値も数値であることが理にかなっています。一般的に採用される値はピクセル値のゼロであり、これが「ゼロパディング」という用語がよく使われる理由です。
画像配列にピクセルの行と列を事前に追加する際の注意点は、両側に均等に行う必要があるということです。例えば、2行と2列のピクセルを追加する場合、上部に1行、下部に1行、左側に1列、右側に1列を追加する必要があります。
下の画像を見てください。6 x 6の1の配列の左側に2行2列が追加され、右側には4行4列が追加されています。追加された行と列は、前の段落で述べたように、すべてのエッジに均等に分配されています。
配列をよく見ると、左側の6 x 6の1の配列は、単一のゼロの層で囲まれているようなので、padding=1です。一方、右側の配列は二層のゼロで囲まれているようなので、padding=2です。

パディングによって追加されたゼロの層。
これらすべてをまとめると、(3, 3) の畳み込みの準備のために2行2列のピクセルを追加する必要がある場合、1つのパディング層が必要であると言っても安全です。同様に、(7, 7) の畳み込みの準備のために6行6列のピクセルを追加する必要がある場合は、3つのパディング層が必要です。より専門的な用語で言えば、
フィルターのサイズが (m, n) の場合、畳み込み後に画像サイズを同じに保つためには、(m-1)/2 層のパディングが必要です; m=n で m が奇数である場合に限ります。
パッディングプロセス
パディングプロセスを示すために、パディングと畳み込みのプロセスを再現するためのバニラコードを書きました。
まず初めに、以下のパディング関数を見てみましょう。この関数は、デフォルトのパディング層が2の画像を引数として受け取ります。displayパラメータがTrueのままにされていると、関数は元の画像とパディングされた画像のサイズを表示するミニレポートを生成します。また、両方の画像のプロットも返されます。
def pad_image(image_path, padding=2, display=True, title=''):
      """
      This function performs zero padding using the number of
      padding layers supplied as argument and return the padded
      image.
      """

      #  reading image as grayscale
      image = cv2.imread(image_path, cv2.IMREAD_GRAYSCALE)

      #  creating an array of zeros
      padded = arr = np.zeros((image.shape[0] + padding*2,
                               image.shape[1] + padding*2))

      #  inserting image into zero array
      padded[int(padding):-int(padding),
             int(padding):-int(padding)] = image

      if display:
        print(f'original image size: {image.shape}')
        print(f'padded image size: {padded.shape}')

        #  displaying results
        figure, axes = plt.subplots(1,2, sharey=True, dpi=120)
        plt.suptitle(title)
        axes[0].imshow(image, cmap='gray')
        axes[0].set_title('original')
        axes[1].imshow(padded, cmap='gray')
        axes[1].set_title('padded')
        axes[0].axis('off')
        axes[1].axis('off')
        plt.show()
        print('image array preview:')
      return padded
パディング機能。
パディング機能をテストするために、以下のサイズ (375, 500) の画像を考えてみましょう。この画像をパディング=2 でパディング機能に通すと、左と右のエッジに2つのゼロの列、上下に2つのゼロの行が追加され、画像サイズは (379, 504) に増加するはずです。これが本当にそうなるか見てみましょう…

サイズ (375, 500) の画像
pad_image('image.jpg')
出力:元の画像サイズ:(375、500)パディングされた画像サイズ:(379、504)

パディングされた画像の縁に沿っている黒いピクセルの細いラインに注意してください。
動作します!見つけた任意の画像に関数を試してみて、必要に応じてパラメータを調整してください。以下は、畳み込みを再現するための基本的なコードです。
def convolve(image_path, padding=2, filter, title='', pad=False):
      """
      This function performs convolution over an image
      """

      #  reading image as grayscale
      image = cv2.imread(image_path, cv2.IMREAD_GRAYSCALE)

      if pad:
        original_image = image[:]
        image = pad_image(image, padding=padding, display=False)
      else:
        image = image

      #  defining filter size
      filter_size = filter.shape[0]

      #  creating an array to store convolutions
      convolved = np.zeros(((image.shape[0] - filter_size) + 1,
                        (image.shape[1] - filter_size) + 1))

      #  performing convolution
      for i in tqdm(range(image.shape[0])):
        for j in range(image.shape[1]):
          try:
            convolved[i,j] = (image[i:(i+filter_size), j:(j+filter_size)] * filter).sum()
          except Exception:
            pass

      #  displaying results
      if not pad:
        print(f'original image size: {image.shape}')
      else:
        print(f'original image size: {original_image.shape}')
      print(f'convolved image size: {convolved.shape}')

      figure, axes = plt.subplots(1,2, dpi=120)
      plt.suptitle(title)
      if not pad:
        axes[0].imshow(image, cmap='gray')
        axes[0].axis('off')
      else:
        axes[0].imshow(original_image, cmap='gray')
        axes[0].axis('off')
      axes[0].set_title('original')
      axes[1].imshow(convolved, cmap='gray')
      axes[1].axis('off')
      axes[1].set_title('convolved')
      pass
畳み込み関数
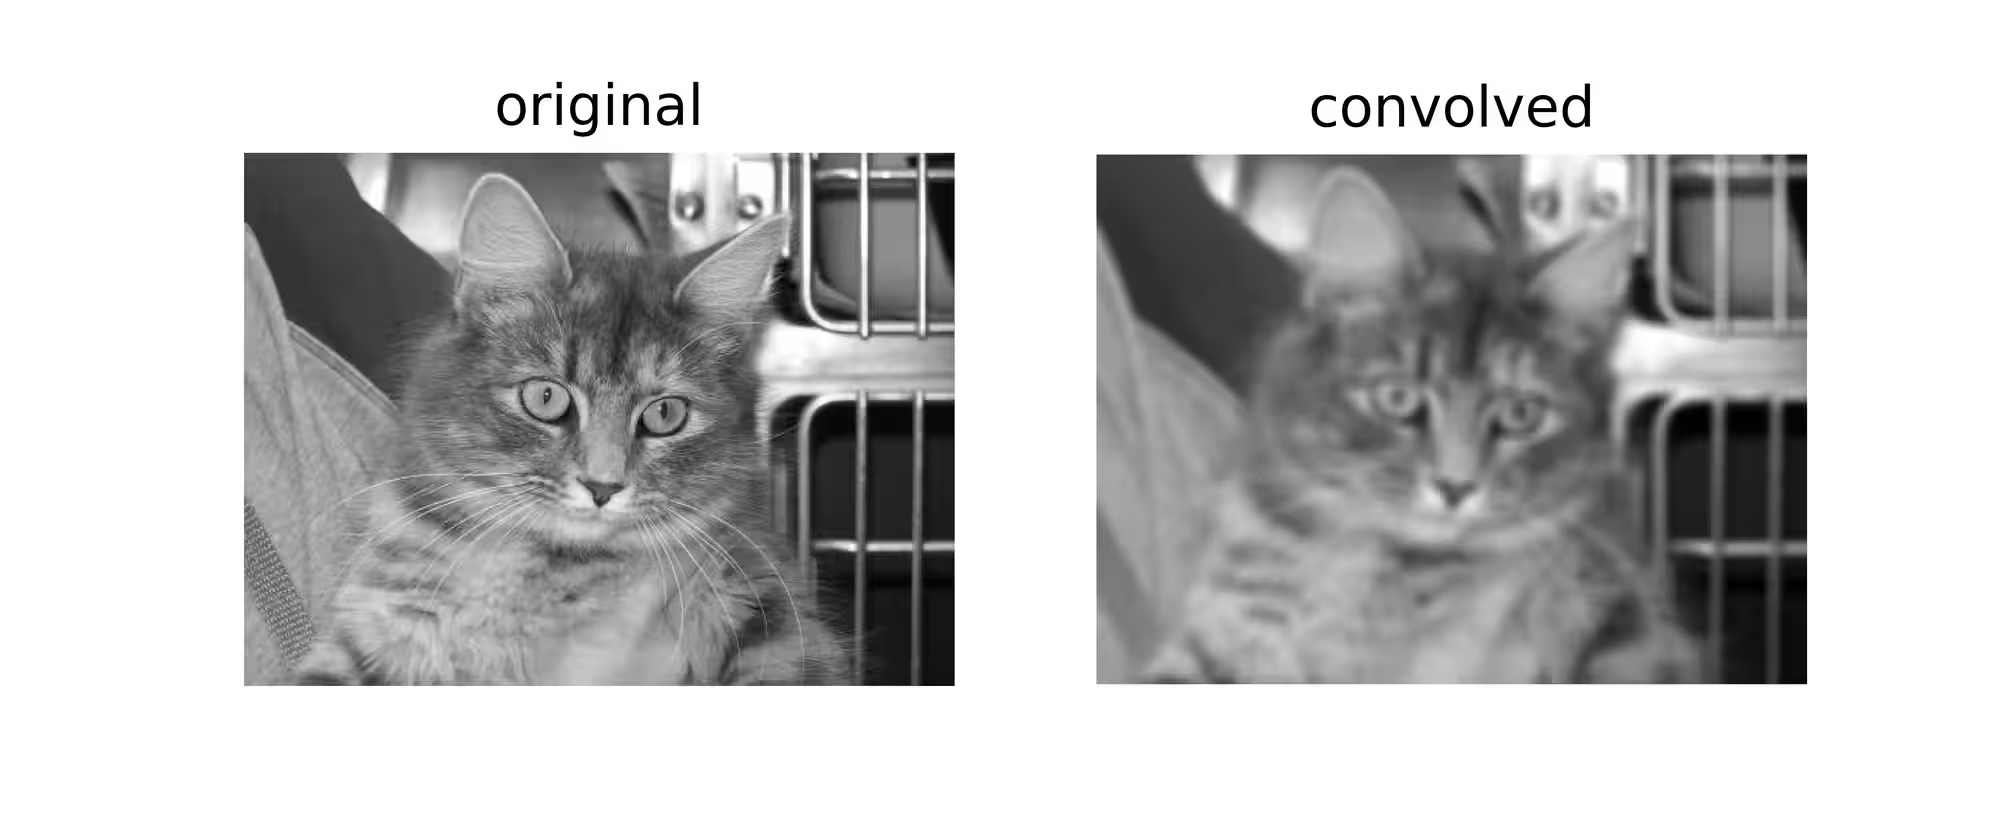
フィルターとして、0.01の値を持つ(5, 5)の配列を選びました。これの背後にあるアイデアは、フィルターが単一のピクセルを生成する前にピクセルの強度を99%減少させることです。単純に言えば、このフィルターは画像にぼかし効果を持つべきです。
filter_1 = np.ones((5,5))/100

filter_1
[[0.01, 0.01, 0.01, 0.01, 0.01]
 [0.01, 0.01, 0.01, 0.01, 0.01]
 [0.01, 0.01, 0.01, 0.01, 0.01]
 [0.01, 0.01, 0.01, 0.01, 0.01]
 [0.01, 0.01, 0.01, 0.01, 0.01]]
(5, 5) 畳み込みフィルター
パディングなしで元の画像にフィルターを適用すると、サイズが(371, 496)のぼやけた画像が得られ、4行と4列が失われます。
convolve('image.jpg', filter=filter_1)
パディングなしで畳み込みを行う
出力: 元の画像サイズ: (375, 500) 畳み込まれた画像サイズ: (371, 496)

(5, 5) パディングなしの畳み込み
しかし、パッドが真に設定されている場合、画像サイズは変わりません。
convolve('image.jpg', pad=True, padding=2, filter=filter_1)
2つのパディング層を持つ畳み込み。
出力: 元の画像サイズ: (375, 500) 畳み込まれた画像サイズ: (375, 500)

(5, 5) パディング付き畳み込み
今回は(9, 9)フィルターを使って同じ手順を繰り返しましょう…
filter_2 = np.ones((9,9))/100
filter_2

filter_2
[[0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01],
 [0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01],
 [0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01],
 [0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01],
 [0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01],
 [0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01],
 [0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01],
 [0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01],
 [0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01, 0.01]])
(9, 9) フィルター
パディングなしでは、得られる画像のサイズが小さくなります…
convolve('image.jpg', filter=filter_2)
出力: 元の画像サイズ: (375, 500) 畳み込まれた画像サイズ: (367, 492)
(9, 9) パディングなしの畳み込み
サイズを同じに保つために、(9, 9)フィルターを使用する場合、元の画像に8行と8列を追加することになるので、パディング層として4(9-1/2)を指定する必要があります。
convolve('image.jpg', pad=True, padding=4, filter=filter_2)
出力: 元の画像サイズ: (375, 500) 畳み込まれた画像サイズ: (375, 500)

(9, 9) の畳み込み パディング付き
PyTorchの観点から
説明を簡単にするために、上記のセクションではバニラコードを使用してプロセスを説明することにしました。同じプロセスはPyTorchでも再現できますが、結果の画像はほとんど変化しないか、全く変化しない可能性が高いことに注意してください。なぜなら、PyTorchは特定の目的のために設計されていないフィルターをランダムに初期化するからです。
これを示すために、上記の前のセクションで定義された check_convolution() 関数を変更してみましょう…
def check_convolution(image_path, filter=(3,3), padding=0):
    """
    This function performs convolution on an image and
    returns the size of both the original and convolved image
    """

    image = cv2.imread(image_path, cv2.IMREAD_GRAYSCALE)

    image = torch.from_numpy(image).float()

    #  adding channel as typical to images (1 channel = grayscale)
    image = image.view(1, image.shape[0], image.shape[1])

    #  perfoming convolution
    with torch.no_grad():
      conv_image = nn.Conv2d(1, 1, filter, padding=padding)(image)

    print(f'original image size: {image.shape}')
    print(f'image size after convolution: {conv_image.shape}')
    pass
デフォルトのPyTorch畳み込みクラスを使用して畳み込みを実行する関数
関数内で、デフォルトのPyTorch 2D畳み込みクラスを使用し、関数のパディングパラメータが直接畳み込みクラスに供給されることに注意してください。では、異なるフィルターを試してみて、結果として得られる画像サイズを見てみましょう…
check_convolution('image.jpg', filter=(3, 3))
(3, 3) パディングなしの畳み込み
出力: オリジナル画像サイズ: torch.Size(1, 375, 500) 畳み込み後の画像サイズ: torch.Size(1, 373, 498)
check_convolution('image.jpg', filter=(3, 3), padding=1)
(3, 3)の畳み込みに1つのパディング層を加えます。
出力: オリジナル画像サイズ: torch.Size(1, 375, 500) 畳み込み後の画像サイズ: torch.Size(1, 375, 500)
check_convolution('image.jpg', filter=(5, 5))
(5, 5) パディングなしの畳み込み-
出力: オリジナル画像サイズ: torch.Size(1, 375, 500) 畳み込み後の画像サイズ: torch.Size(1, 371, 496)
check_convolution('image.jpg', filter=(5, 5), padding=2)
(5, 5) の畳み込みに2層のパディングを施した
出力: オリジナル画像サイズ: torch.Size(1, 375, 500) 畳み込み後の画像サイズ: torch.Size(1, 375, 500)
上記の例に示されているように、パディングなしで畳み込みを行うと、結果として得られる画像のサイズは小さくなります。しかし、適切な量のパディング層を使用して畳み込みを行うと、得られる画像のサイズは元の画像と同じになります。
最後の remarks
この記事では、畳み込みプロセスが実際にピクセルの損失をもたらすことを確認しました。また、畳み込みの前にパディングと呼ばれるプロセスで画像に事前にピクセルを追加することで、畳み込み後に画像が元のサイズを維持できることを証明しました。