DeciDiffusion: テキストから画像への潜在拡散モデル

紹介
テキストから画像へのモデルの出現は、人工知能の分野における変革的なシフトを示しており、創造的表現とコミュニケーションの新しい可能性を開きます。これらのモデルは、テキスト入力に基づいてリアルで文脈に関連する画像を生成するために、高度な深層学習技術を活用しています。自然言語処理とコンピュータビジョンの統合により、テキストの説明を視覚的に魅力的な表現に解釈し翻訳できるアプリケーションへの道が開かれました。これらのモデルが進化し続け改善される中で、デザイン、エンターテインメント、教育などのさまざまな産業を革命する可能性を秘めており、言語の世界と画像の世界との間にシームレスな架け橋を提供します。
DeciDiffusionは、LAIONデータセットのサブセットで訓練されたオープンソースの最先端テキストから画像への潜在拡散モデルであり、LAION-ARTデータセットでファインチューニングされています。この拡散モデルは10億2000万のパラメータを持ち、同程度のサイズである1億7000万のパラメータを持つStable Diffusion v1.5(SD)を上回り、40%少ない反復で同等の画像生成品質を達成しています。このモデルは、NVIDIA A10G GPUで実行した場合、Stable Diffusion v1.5よりも3倍速いことも証明されています。このパフォーマンスは、モデルの最適効率のために開発された先進的なニューラルアーキテクチャサーチ技術によるものです。
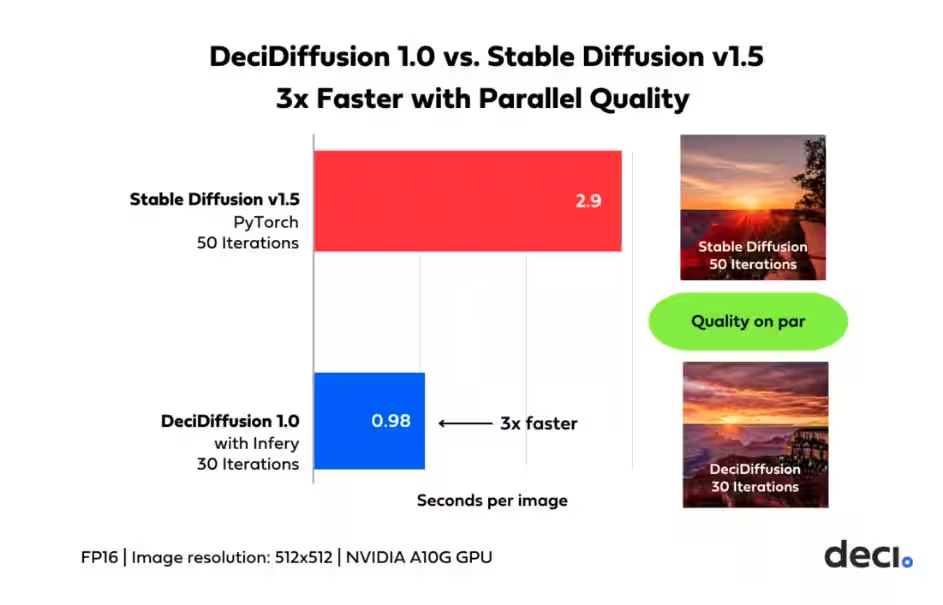
DeciDiffusionのパフォーマンスベンチマーキングとSD(ソース)
DeciDiffusionの強化された能力はSDのそれよりも深いものです。DeciDiffusionの意味合いについて簡単に話しましょう。
テキストから画像を生成するモデルは、デザイン、アート、広告、コンテンツ作成などの分野で巨大な可能性を秘めています。この技術の発展は、テキストを鮮やかな画像にシームレスに変換する能力にあります。これはAI能力の重要な進歩を示しています。SDがオープンソースであるため、多くの革新を促進しましたが、その要求される計算リソースのために実際の展開における課題では後手に回ってしまいます。ただし、Turboモデルの登場や蒸留技術がその前提を覆すかもしれません。
これらの課題は、トレーニングと展開の際に顕著な遅延とコストの問題を引き起こします。それに対して、DeciDiffusionはその優れた計算効率で際立っており、よりスムーズなユーザー体験と生産コストの約66%の印象的な削減を実現しています。その結果、このモデルを使用するテキストから画像への生成アプリケーションにとって、他の潜在拡散モデルと比べて、よりアクセスしやすく実現可能な環境が生まれます。
この記事では、DeciDiffusionがどのように強力で多用途であるかを見てから、実践的なデモンストレーションでそれを示します。
前提条件
- Python環境: Python 3.8以上。
- ライブラリ: PyTorch、Transformers、Diffusers(最新バージョン)。
- ハードウェア: CUDAサポートのあるNVIDIA GPU(例:A100、H100)を使用した加速トレーニングと推論。
- 基本知識: 拡散モデル、深層学習の基礎、モデル最適化技術の理解。
モデルアーキテクチャ
DeciDiffusion 1.0は、テキストから画像を生成するモデルで、Stable Diffusionの基本アーキテクチャを基にしており、DeciによるU-Net-NASデザインなどの進歩を組み込んでいます。この置き換えにより、パラメータ数を減少させることでモデルの計算効率が最適化され、Variational Autoencoder(VAE)とCLIPのテキストエンコーダを維持しています。
U-Net-NAS
DeciDiffusionはStable Diffusionと同様に潜在拡散モデルですが、そのアーキテクチャはU-Net-NASに基づいています。潜在拡散モデルは高品質な画像を生成する能力のある確率的フレームワークです。これらはランダムノイズを現実的な画像に変換することで画像生成プロセスを開始し、徐々に拡散していきます。これらのモデルの特徴的な点は、生のピクセル値ではなく、画像のエンコードされた潜在表現に拡散プロセスを適用することにあります。
ここに関与する主なステップがあります:
- 変分オートエンコーダ(VAE): 変分オートエンコーダ(VAE)は、トレーニング中にそのエンコーディング分布の正則化を受けるオートエンコーダアーキテクチャです。この正則化は、その潜在空間に好ましい特性を保証し、新しいデータの生成を容易にします。「変分」という用語は、この正則化と統計における変分推論法との強い関連性に由来しています。要するに、VAEは画像を潜在表現に変換し、その逆も行います。トレーニング中、エンコーダは画像を潜在バージョンに変換し、デコーダはトレーニングと推論の両方でこのプロセスを逆にします。
- U-Net: そのアーキテクチャデザインにちなんで名付けられたU-Netは、畳み込み層と2つのネットワーク(エンコーダーとデコーダー)からなる「U」字型モデルを特徴としています。このモデルは、「何」と「どこ」のセグメンテーションの問題に効果的に対処します。
- テキストエンコーダー: このエンコーダーは、テキストのプロンプトを潜在的なテキスト埋め込みに変換する役割を担っており、これはさらにU-Netデコーダーによって使用されます。

(a) U-Netアーキテクチャ (b) Nas-UnetアーキテクチャのU様バックボーン(出典)
このアーキテクチャでは、Uのようなバックボーンに基づいてDownSCとUpSCと呼ばれる2種類のセルアーキテクチャが定義されています。DeciDiffusionは、その独特な特徴、つまり各ブロックの柔軟な構成により際立っています。これにより、最小限の計算でピークパフォーマンスを最適化するために、ResNetブロックとAttentionブロックの数が調整されます。DeciDiffusionでは、パラメータが少ない効率的なU-Net-NASを採用しており、モデルは計算の要求を減らし、Stable Diffusionに対してより資源効率の良い選択肢となっています。
モデルは4つの段階でトレーニングされています。
- フェーズ1:スクラッチから始めて、LAION-v2からの3億2000万サンプルのサブセットを使用して、256x256の解像度で128万ステップ訓練しました。
- フェーズ2:さらなるトレーニングは、同じデータセットで870Kステップを512x512の解像度で行い、より細かい詳細を捉えました。
- フェーズ3:指数移動平均(EMA)を使用して65,000ステップのトレーニングを実施し、追加の学習率スケジューラを導入し、より多くの「質的」データを取り入れました。
- フェーズ4:LAION-ARTの200万サンプルのサブセットを使用したファインチューニング。
トレーニングのためのハードウェア要件
要件
フェーズ1
フェーズ2-4
ハードウェア
8 x 8 x A100 (80GB)
8 x 8 x H100 (80GB)
最適化ツール
アダムW
ラム
バッチ
8192
6144
学習率
1e-4
5e-3
DeciDiffusionのトレーニングに必要なハードウェア要件は非常に高く、集中的な処理を処理するためにかなりの計算能力が必要でした。そのため、コストのかかるインフラに投資することなく、作業フローを効率化し、パフォーマンスを最適化するために、DigitalOceanのGPUドロップレットの使用をお勧めします。
DeciDiffusionの実践
このモデルを使用して驚くべき画像を作成する手順に従ってください!
必要なパッケージをインストールする
#install the packages using pip
!pip install --quiet git+https://github.com/huggingface/diffusers.git@d420d71398d9c5a8d9a5f95ba2bdb6fe3d8ae31f
!pip install --quiet ipython-autotime
!pip install --quiet transformers==4.34.1 accelerate==0.24.0 safetensors==0.4.0
!pip install --quiet ipyplot
%load_ext autotime
ライブラリと必要なパッケージをインポートする
#import necessary libraries
from diffusers import StableDiffusionPipeline, DiffusionPipeline
import torch
import ipyplot
import time
*事前に学習されたチェックポイント「DeciDiffusion-v1-0」を安定した拡散パイプライン用に読み込みます。2つのプロンプトでモデルを実行します。生成された画像は「img」と「img2」変数に保存されます。
#set the device and load the pre-trained model
device = 'cuda' if torch.cuda.is_available() else 'cpu'
checkpoint = "Deci/DeciDiffusion-v1-0"

#biuld the decidiffusion pipeline
pipeline = StableDiffusionPipeline.from_pretrained(checkpoint, custom_pipeline=checkpoint, torch_dtype=torch.float16)

pipeline.unet = pipeline.unet.from_pretrained(checkpoint, subfolder='flexible_unet', torch_dtype=torch.float16)
pipeline = pipeline.to(device)

#generate images by passing prompt
img = pipeline(prompt=['A photo of an astronaut riding a horse on Mars']).images[0]

img2 = pipeline(prompt=['A big owl with bright shinning eyes']).images[0]

*DeciDiffusionによって生成された画像
DeciDiffusionとStable Diffusion v1.5の比較
SDモデルが画像を生成するのにかかる時間:

SDによって生成された画像。画像作成時間は2.96秒、2.93秒、2.94秒、2.93秒でした。
DeciDiffusionモデルが画像を生成するのにかかる時間:

DeciDiffusionによって生成された画像。画像の作成時間はそれぞれ1.11秒、1.08秒、1.09秒、1.08秒でした。
DeciDiffusionの改善されたレイテンシは、そのアーキテクチャの進歩、サンプル効率を高める効率的なトレーニング技術、そして使いやすいSDKであるInferyの統合によるものであり、これによりさらに向上する可能性があります。この組み合わせにより、推論操作中に大幅なコスト削減が実現されます。まず第一に、ハードウェアの選択に柔軟性を提供し、高性能のA100/H100 GPUから、より予算に優しいA10Gへの移行が可能であり、パフォーマンスを犠牲にすることなく(私たちは依然としてA100-80GまたはH100の使用を推奨します)。さらに、同じハードウェア上で比較した場合、DeciDiffusionは非常にコスト効果が高く、生成される10,000画像ごとにStable Diffusionと比較して66%のコスト削減を実現しています。
結論的な考え
DeciDiffusionは、生成AIアプリケーションにおいて重要な進歩を表しています。これは、コンテンツ制作や広告におけるリアルタイムプロジェクトを最適化するだけでなく、運営コストの大幅な削減にもつながります。この記事では、DeciDiffusionをSDと比較しましたが、その結果、モデルはSDよりもトレーニングと推論において高速かつ効率的であると結論づけられます。ただし、このモデルは人々や出来事の正確なまたは真実の表現を生成することを意図していないことに注意する価値があります。したがって、その目的で使用することは、指定された能力を超えています。また、モデルには独自の制限もあります。以下にそのいくつかを示します:
- モデルは完全にフォトリアルな画像を生成することができません。アーティファクトが一般的です。
- 複雑な構成はまだモデルにとって課題であり、モデルの自己符号化の側面はまだ損失です。
- 完璧な顔や人間の姿を生成することは、実際にすべての拡散モデルにとっての課題です。
- DeciDiffusionは主に英語のキャプションに最適化されており、他の言語では効果的ではありません。
それにもかかわらず、このモデルには、特に計算能力とコスト効率の面で独自の利点があります。この文章と一緒に、DeciDiffusionとStable Diffusionに基づいた2つのノートブックを提供しています。ユーザーには、このノートブックを記事と併用することで、より豊かな体験を得ることをお勧めします。
モデルの詳細とリソース
- 開発モデル: Deci
- モデルタイプ: 潜在拡散に基づくテキストから画像への生成モデル
- コードライセンス:このリポジトリのコードはApache 2.0ライセンスのもとにリリースされています。
- 重みのライセンス: これらの重みはCreativeML Open RAIL+±Mライセンスの下で公開されています。
- DeciDiffusion ハギングフェイス: https://huggingface.co/Deci/DeciDiffusion-v1-0