モンキーチャットビジョンモデルによるテキストラベリングと画像解像度

紹介
視覚と言語のモデルは、視覚データとテキストデータを一緒に理解し処理するために設計された高度な人工知能(AI)システムの一つです。これらのモデルは、コンピュータビジョンと自然言語処理のタスクの能力を組み合わせることで知られています。モデルは画像を解釈し、画像に関する説明を生成するように訓練されており、画像キャプション作成、視覚的質問応答、テキストから画像への合成など、さまざまなアプリケーションを可能にします。これらのモデルは大規模なデータセットと強力なニューラルネットワークアーキテクチャで訓練され、複雑な関係を学ぶ手助けをしています。これにより、モデルは望ましいタスクを実行できるようになります。この高度なシステムは、人間とコンピュータの相互作用の可能性を広げ、人間と同様にコミュニケーションできるインテリジェントなシステムの開発を可能にします。
大規模マルチモーダルモデル(LMM)は非常に強力ですが、高解像度の入力やシーンの理解に苦労しています。これらの課題に対処するために、最近Monkeyが導入されました。Monkeyは視覚と言語のモデルで、入力画像を均一なパッチに分割して処理します。各パッチは、その元の視覚エンコーダートレーニングで使用されたサイズ(例:448×448ピクセル)に合致しています。
このデザインは、モデルが高解像度の画像を処理できるようにします。Monkeyは二段階の戦略を採用しています。まず、より高い解像度を通じて視覚的なキャッチを強化し、次にシーンとオブジェクトの関連性を豊かにするための多層的な説明生成方法を使用します。これにより視覚データのより包括的な理解が得られます。このアプローチは、詳細なビジュアルをキャッチすることでデータからの学習を向上させ、説明文生成の効果を高めます。
前提条件
- テキストラベリングと画像処理の基本的な理解。
- コンピュータビジョンタスクにおけるAIモデルの使用に慣れていること。
- Monkey Chat Vision Modelへのアクセスと互換性のある開発環境。
モンキーアーキテクチャの概要

総合的なサルのアーキテクチャ(画像出典)
このアプローチを段階を追って分解してみましょう。
スライディングウィンドウによる画像処理
- 入力画像: 高さ(H)と幅(W)を持つ次元(H X W X 3)の画像(I)であり、3は色チャネル(RGB)を表しています。
- スライディングウィンドウ:画像は、寸法(H_v X W_v)のスライディングウィンドウ(W)を使用して、より小さなセクションに分割されます。このプロセスは画像を局所セクションに分割し、モデルが画像の特定の部分に焦点を合わせることを可能にします。
LoRA統合
- LoRA(低ランク適応):LoRAは、画像の異なる部分に存在する多様な視覚要素を処理するために、各共有エンコーダー内で使用されます。LoRAは、エンコーダーが詳細に敏感な特徴をより効果的に捉えるのを助け、モデルのパラメータや計算負荷を大幅に増加させることなく実現します。
構造情報の維持
- グローバル画像リサイズ:入力画像の全体的な構造情報を保つために、元の画像は次元((H_v, W_v))にリサイズされ、グローバル画像が作成されます。このグローバル画像は全体的なビューを維持し、一方でパッチは詳細な視点を提供します。
ビジュアルエンコーダーとリサンプラーを使用した処理
- 同時処理:個々のパッチとグローバルイメージの両方が、視覚エンコーダーとリサンプラーを通じて同時に処理されます。
ビジュアルリサンプラー:フラミンゴモデルに触発されたビジュアルリサンプラーは、主に2つの機能を果たします。
- 視覚情報の要約:画像のセクションから視覚情報を凝縮します。
- 高次セマンティック表現の取得:視覚情報を言語特徴空間に変換し、より良いセマンティック理解を促進します。
クロスアテンションモジュール
- クロスアテンションメカニズム:リサンプラーは、学習可能なベクター(埋め込み)がクエリベクターとして機能するクロスアテンションモジュールを使用します。視覚エンコーダからの画像特徴がクロスアテンション操作におけるキーとして機能します。これにより、モデルは重要な画像の部分に焦点を当てつつ、文脈情報を取り入れることができます。
詳細と全体的理解のバランスを取る
- バランスの取れたアプローチ:この方法は、詳細な地域分析の必要性と全体的なグローバルイメージの視点をバランスよく兼ね備えています。このバランスは、計算リソースを大幅に増やすことなく、詳細な特徴と全体的な構造を捉えることでモデルのパフォーマンスを向上させます。
このアプローチは、LoRAやクロスアテンションなどの高度な技術を活用し、局所的な詳細分析と全体的な概要を組み合わせることで、モデルの複雑な画像を理解する能力を向上させます。
いくつかの重要なポイント
- リソース効率的な入力解像度の向上:モンキーは広範な事前トレーニングを必要とせずに、LMMでの入力解像度を向上させます。高解像度の画像を小さなパッチに分割するためにスライディングウィンドウ法を採用し、Vision Transformer (ViT) モデルを高解像度に直接補間するのではありません。それぞれのパッチは、LoRA調整を施した静的なビジュアルエンコーダーと訓練可能なビジュアルリサンプラーによって処理されます。
- トレーニングデータの分布を維持する:モンキーは、各パッチをサポートされている解像度にリサイズすることで、より小さな解像度(例えば、448×448)でトレーニングされたエンコーダーを活用します。このアプローチは、元のデータ分布を維持し、一からのトレーニングのコストを回避します。
- トレーニング可能なパッチの利点:この手法はさまざまなトレーニング可能なパッチを使用しており、位置埋め込みのための従来の補間技術よりも効果的に解像度を向上させます。
- 自動多層説明生成: Monkeyは、これらの生成器からの洞察を組み合わせることによって高品質なキャプションを生成するために、複数の高度なシステム(例: BLIP2、PPOCR、GRIT、SAM、ChatGPT)を組み込んでいます。このアプローチは、層状かつ文脈的な理解を通じて、視覚的な詳細の幅広いスペクトルを捉えます。
サルの利点
- 高解像度サポート:事前トレーニングなしで最大1344×896の解像度をサポートし、小さな物体や密集したテキストの識別を助けます。
- 改善された文脈関連付け:複数の対象間の関係の理解を強化し、より良いテキスト記述生成のために共通の知識を活用します。
- 性能向上:画像キャプション生成や視覚的質問応答を含む様々なタスクにおいて競争力のある性能を示し、特に密なテキストの質問応答においてGPT-4Vのようなモデルと比較して有望な結果を示しています。
全体として、Monkeyは既存のモデルをより効率的に使用することによって、LMMの解像度と記述生成を改善する洗練された方法を提供します。
Monkeyを使って視覚的なQ&Aを行うにはどうすればよいですか?
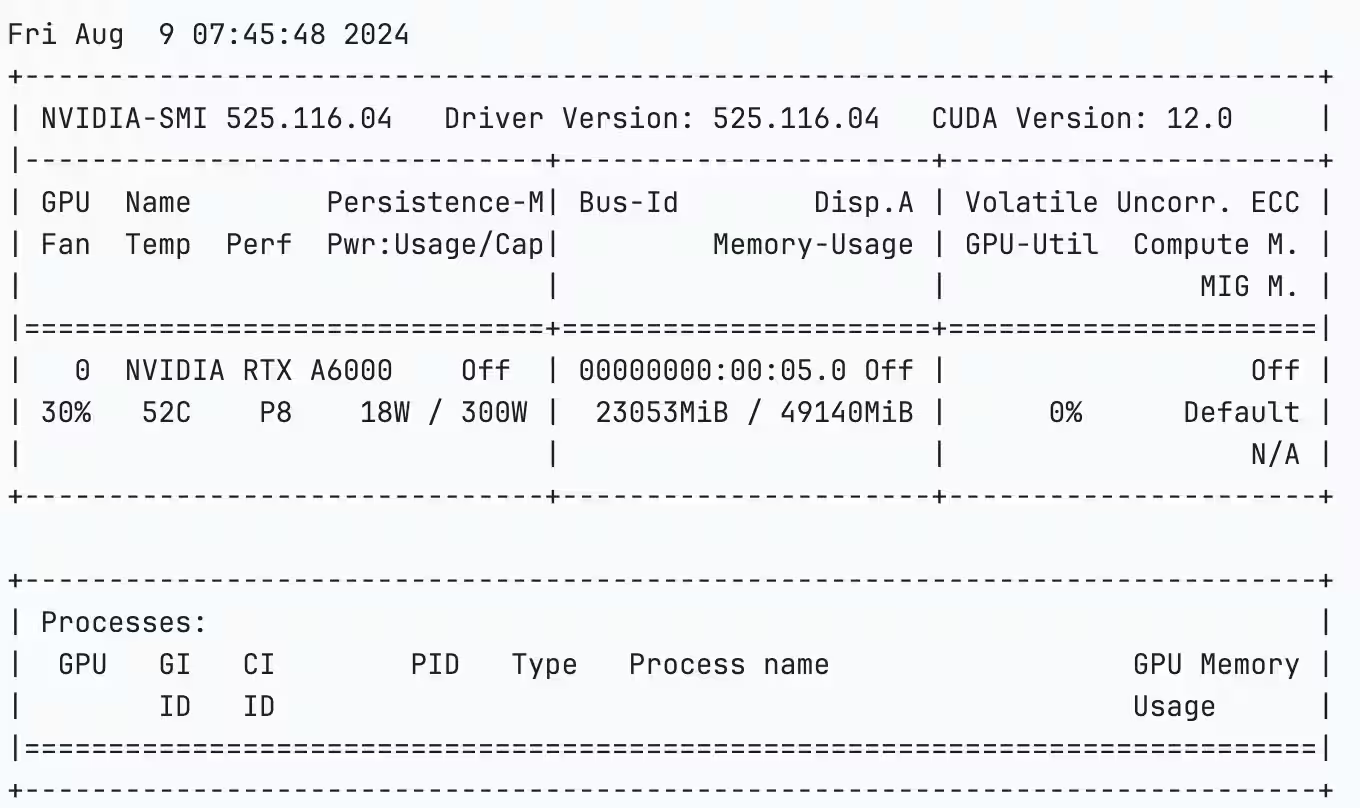
Monkey Modelを実行して実験するには、まずノートブックを開始するか、端末を立ち上げます。モデルを実行するには、A4000 GPUの使用を強くお勧めします。
NVIDIA A6000 GPUは、視覚質問応答(VQA)を含むさまざまなAIおよび機械学習アプリケーションにおいて、その卓越した性能で知られる強力なグラフィックスカードです。A6000はメモリと先進的なAmpereアーキテクチャを備えており、高いスループットと効率を提供し、VQAタスクで要求される複雑な計算処理を扱うのに理想的です。
!nvidia-smi
セットアップ
以下のコードセルを実行します。これにより、リポジトリがクローンされ、requirements.txtファイルがインストールされます。
git clone https://github.com/Yuliang-Liu/Monkey.git
cd ./Monkey
pip install -r requirements.txt
私たちは速くて使いやすいGradioデモを実行することができます。
python demo.py
またはコードに沿って進むことができます。
from transformers import AutoModelForCausalLM, AutoTokenizer
checkpoint = "echo840/Monkey-Chat"
model = AutoModelForCausalLM.from_pretrained(checkpoint, device_map='cuda', trust_remote_code=True).eval()
tokenizer = AutoTokenizer.from_pretrained(checkpoint, trust_remote_code=True)
tokenizer.padding_side = 'left'
tokenizer.pad_token_id = tokenizer.eod_id
上記のコードは、Hugging Face Transformersライブラリから事前に学習されたモデルとトークナイザーをロードします。
「echo840/Monkey-Chat」は、私たちがロードするモデルチェックポイントの名前です。次に、モデルの重みと設定をロードし、デバイスをCUDA対応GPUにマッピングして、より高速な計算を行います。
img_path = '/notebooks/quick_start_pytorch_images/image 2.png'
question = "provide a detailed caption for the image"

query = f'<img>{img_path}</img> {question} Answer: '
input_ids = tokenizer(query, return_tensors='pt', padding='longest')
attention_mask = input_ids.attention_mask
input_ids = input_ids.input_ids

pred = model.generate(
    input_ids=input_ids.cuda(),
    attention_mask=attention_mask.cuda(),
    do_sample=False,
    num_beams=1,
    max_new_tokens=512,
    min_new_tokens=1,
    length_penalty = 1,
    num_return_sequences=1,
    output_hidden_states=True,
    use_cache=True,
    pad_token_id=tokenizer.eod_id,
    eos_token_id=tokenizer.eod_id,
)

response = tokenizer.decode(pred[0][input_ids.size(1):].cpu(), skip_special_tokens=True).strip()
print(response)
このコードは、プロンプトクエリに基づいてMonkeyを使用して詳細なキャプションや説明、またはその他の出力を生成します。保存した画像のパスを指定し、画像参照とキャプションを求める質問を含むクエリ文字列を作成します。次に、クエリは‘tokenizer’を使用してトークン化され、入力テキストがトークンIDに変換されます。
do_sample=Falseやnum_beams=1のようなパラメータはサンプリングを無効にして決定論的な出力を保証します。max_new_tokens、min_new_tokens、length_penaltyなどの他のパラメータは、生成されるシーケンスの長さと性質を制御します。生成後、出力トークンは人が読み取れるテキストにデコードされ、特殊トークンはスキップされて、最終的な応答を形成します。これは画像を説明するキャプションです。最後に、生成されたキャプションを印刷します。
結果
私たちは非常に基本的な画像、つまりスクリーンショットだけでモデルを試しましたが、画像が何であるかをかなりよく認識しています。

モンキー出力:- 画像は青い背景のコンピュータインターフェースを表示しています。主な焦点は「A4000」というラベルと「$0.76/時」という価格が付けられた機械です。この機械は45GBのRAMと8つのCPUを搭載しています。また、インターフェースには、青い「マシン停止」ボタンや白い「11時間後に自動シャットダウン」ボタンなど、いくつかのボタンやアイコンがあります。「45GB RAM」と「8CPUs」というテキストも視認可能です。全体のレイアウトは、仮想マシンを管理するためのユーザーフレンドリーなインターフェースを示唆しています。

画像には、ゴールデンレトリバーが空中で黄色いテニスボールに向かってジャンプしている様子が捉えられています。犬の体は真っ直ぐに伸びており、前脚はボールを掴もうとし、尻尾は興奮して高く上がっています。背景は緑豊かな芝生で、犬の白い毛とのコントラストが鮮やかです。画像は低い角度から撮影されており、犬が大きくて威圧的に見えます。犬の集中した表情と躍動的なポーズは、激しい遊びの瞬間を示唆しています。

プロンプト:画像の詳細なキャプションを提供してください。
この画像は夜の都市のスカイラインの絵画です。空は渦巻く黄色と青の色で彩られ、星のような効果を生み出しています。前景には、上に時計のある高い建物があります。この絵画には、黄色い光が当たっている大きな木も描かれています。全体的な効果は、ヴァン・ゴッホの有名な「星月夜」を思わせる安らぎと美しさです。
私たちは画像の細部まで説明し、キャプションを提供する詳細な説明に非常に感銘を受けています。AI生成のキャプションは本当に素晴らしいです!
以下の画像は、MonkeyのさまざまなVQAタスクにおける能力を強調しています。Monkeyは質問を分析し、重要な画像要素を特定し、微細なテキストを認識し、オブジェクトについて推論し、視覚的なチャートを理解します。図はまた、Monkeyの優れたキャプション生成能力を示しており、オブジェクトを正確に説明し、要約を提供します。

さまざまなタスクにおけるサルの結果(画像出典)
比較結果
定性的分析において、Monkeyは詳細なキャプションを生成するタスクでGPT4Vや他のLMMと比較されました。

サルとGPT-4Vはバックグラウンドに「エンポリオ・アルマーニ」の店舗を特定しました。サルは、赤いコートと黒いパンツを着た女性が黒いバッグを持っているという追加の詳細も提供しました。(画像出典)
さらに実験により、多くのケースで、Monkeyは複雑なテキストベースの質問を理解する際にGPT4Vと比較して優れたパフォーマンスを示していることがわかりました。

以下の図に示すVQAタスクの比較結果は、モデルサイズを拡大することで、Monkeyが密なテキストを含むタスクで顕著な性能のメリットを得ることを示しています。MonkeyはQwenVL-Chat [3]、LLaVA-1.5 [29]、およびmPLUG-Owl2 [56]を上回るだけでなく、GPT-4V [42]と比較しても有望な結果を達成しています。これは、マルチモーダル大型モデルの性能向上のためにモデルサイズを拡大することの重要性を示しており、我々の手法がそれらの性能を向上させる効果的であることを検証しています。

モンキーはVQAタスクにおけるGPT-4V、QwenVL-Chat、LLaVA-1.5、mPLUG-Owl2との比較を行います。
実用的な応用
- 自動画像キャプショニング:eコマース、ソーシャルメディア、デジタルアーカイブなど、さまざまな分野の画像に対して詳細な説明を生成します。
- 支援技術:画像のためにリアルタイムアプリケーションで説明的なキャプションを生成することで視覚障害者を支援します。例えば、スクリーンリーダーやナビゲーション補助具です。
- インタラクティブチャットボット:チャットボットと統合して、顧客サポートやバーチャルアシスタントで詳細な視覚的説明と文脈を提供し、さまざまなサービスでのユーザー体験を向上させます。
- 画像ベースの検索エンジン:検索の精度と関連性を向上させる豊富でコンテキストに配慮した説明を提供することで、画像検索機能を改善します。