Linux上のログファイルから列を抽出して並べ替える方法

特定の列でログファイルをソートすることは、情報を迅速に見つけるのに便利です。ログは通常プレーンテキストとして保存されるため、コマンドラインのテキスト操作ツールを使用して処理し、より読みやすい形式で表示できます。
cutとawkを使ったカラムの抽出
「cut」および「awk」ユーティリティは、テキストファイルから情報の列を抽出するための2つの異なる方法です。どちらも、ログファイルが空白で区切られていると仮定しています。例えば:
column column columnこれは、列内のデータに空白が含まれている場合、問題を引き起こします。例えば、日付(「水曜日 6月12日」)などです。cutはこれを3つの別々の列として識別するかもしれませんが、ログファイルの構造が一貫していると仮定すれば、3つすべてを一度に抽出することができます。
cut は非常に使いやすいです:
cat system.log | cut -d ' ' -f 1-6catコマンドはsystem.logの内容を読み取り、それをcutにパイプします。-dフラグは区切り文字を指定します。この場合、区切り文字は空白です。(デフォルトはタブ、tです。)-fフラグは出力するフィールドを指定します。このコマンドは特にsystem.logの最初の6列を表示します。もし3列だけを表示したい場合は、-f 3フラグを使用します。
awkはより強力ですが、簡潔ではありません。cutは列を抽出するのに便利で、たとえばApacheのログからIPアドレスのリストを取得したい場合に役立ちます。awkは全行を再配置できるため、特定の列で文書全体をソートするのに便利です。awkは完全なプログラミング言語ですが、列を印刷するために簡単なコマンドを使用できます:
cat system.log | awk '{print $1, $2}'awk はファイルの各行に対してコマンドを実行します。デフォルトでは、ファイルを空白で分割し、各列を変数 $1, $2, $3 として保存します。 print $1 コマンドを使用することで、最初の列を表示できますが、ループを使用せずに列の範囲を表示する簡単な方法はありません。
awk の利点の一つは、コマンドが一度に全行を参照できることです。行の内容は変数 $0 に格納されており、これを使用して全行を出力できます。したがって、例えば、行の残りを出力する前に、3列目を出力することができます:
awk '{print $3 " " $0}'この" "は$3と$0の間にスペースを印刷します。このコマンドは3列目を2回繰り返しますが、$3変数をnullに設定することで回避できます:
awk '{printf $3; $3=""; print " " $0}'printf コマンドは改行を出力しません。同様に、$0を印刷する前に、特定の列をすべて空の文字列に設定することで、出力から除外できます:
awk '{$1=$2=$3=""; print $0}'awkを使えば、正規表現マッチングなど、もっと多くのことができますが、初期設定のカラム抽出はこの使用例にはうまく機能します。
ソートとユニークを使った列のソート
このsortコマンドは、特定の列に基づいてデータのリストを並べるために使用できます。構文は次のとおりです:
sort -k 1-kフラグは列番号を示します。このコマンドに入力をパイプすると、順序付きリストが出力されます。デフォルトでは、sortはアルファベット順を使用しますが、-nによる数値ソート、-hによる接尾辞ソート(1M > 1K)、-Mによる月の略称のソート、-Vによるファイルバージョン番号のソート(file-1.2.3 > file-1.2.1)などのフラグを介して、さらに多くのオプションをサポートします。
コマンドuniqは重複した行をフィルタリングし、ユニークなものだけを残します。それは隣接する行のみに対してのみ機能します(パフォーマンス上の理由から)。したがって、ファイル全体の重複を削除するためには、常にsortの後に使用する必要があります。その構文は単純です:
sort -k 1 | uniq重複だけをリストしたい場合は、-d フラグを使用してください。
uniq は -c フラグを使って重複の数を数えることもできるため、頻度を追跡するのに非常に便利です。たとえば、あなたの Apache サーバーにアクセスしているトップの IP アドレスのリストを取得したい場合、access.log に対して次のコマンドを実行することができます:
cut -d ' ' -f 1 | sort | uniq -c | sort -nr | headこのコマンドの文字列は、IPアドレスの列を切り取り、重複をまとめて、各出現回数をカウントしながら重複を削除し、その後、カウント列に基づいて降順に並べ替え、次のようなリストを得ることができます:
21 192.168.1.1

12 10.0.0.1


5 1.1.1.1

2 8.0.0.8
これらの同じ技術を、他のユーティリティであるawkやsedと共に、ログファイルにも適用することができます。役立つ情報を引き出すためにこれらの連鎖したコマンドは長いですが、毎回入力する必要はなく、必ずbashスクリプトに保存するか、~/.bashrcでエイリアス化することができます。
grepとawkを使ったデータのフィルタリング
grepは非常にシンプルなコマンドです。検索語を与え、入力を渡すと、その検索語を含むすべての行を出力します。例えば、Apacheのアクセスログで404エラーを検索したい場合は、次のようにできます:
cat access.log | grep "404"与えられたテキストに一致するログエントリのリストを出力します。
しかし、grepは特定の列に検索を制限できないため、ファイル内の他の場所に「404」というテキストがある場合、このコマンドは失敗します。HTTPステータスコードの列のみを検索したい場合は、awkを使用する必要があります:
cat access.log | awk '{if ($9 == "404") print $0;}'awkを使用すると、否定検索を行うことができるという利点もあります。例えば、ステータスコード200(OK)で返されなかったすべてのログエントリを検索することができます:
cat access.log | awk '{if ($9 != "200") print $0;}'プログラム機能awkが提供するすべての機能にアクセスできることも含まれます。
ウェブログのGUIオプション
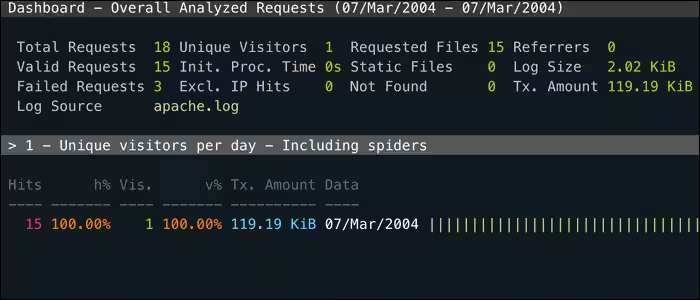
GoAccessは、ウェブサーバーのアクセスログをリアルタイムで監視し、有用な各フィールドでソートするためのCLIユーティリティです。完全にターミナルで動作するため、SSH経由でも使用できますが、より直感的なウェブインターフェースもあります。
apachetop は、アクセスログの列でフィルタリングとソートに使用できる、Apache専用の別のユーティリティです。これは、アクセスログに直接リアルタイムで実行されます。