JavaでPostgreSQLにデータを永続化する方法
Javaはおそらく現在最も広く使用されているプログラミング言語です。その堅牢性とプラットフォームに依存しない性質により、Javaベースのアプリケーションはほぼすべての環境で実行できます。どのアプリケーションにも言えるように、私たちはデータを信頼できる方法で保存する必要があります。この必要性がデータベースを生み出しました。
Javaでは、データベース接続はJDBC(Java Database Connectivity API)によって実装されており、プログラマーが異なる種類のデータベースをほぼ同じ方法で扱うことができるため、データベースからデータを保存または読み取る必要がある時に、私たちの生活をはるかに楽にしてくれます。
このチュートリアルでは、PostgreSQLデータベースインスタンスに接続し、データを書き込むことができるJavaアプリケーションの例を作成します。データの挿入が成功したかどうかを確認するために、データを挿入したテーブルを読み返して印刷する機能も実装します。
このチュートリアルでは、あなたは学びます:
- アプリケーションのためのデータベースの設定方法
- プロジェクトにPostgreSQL JDBCドライバーをインポートする方法
- データベースにデータを挿入する方法
- データベーステーブルの内容を読むための簡単なクエリの実行方法
- 取得したデータを印刷する方法
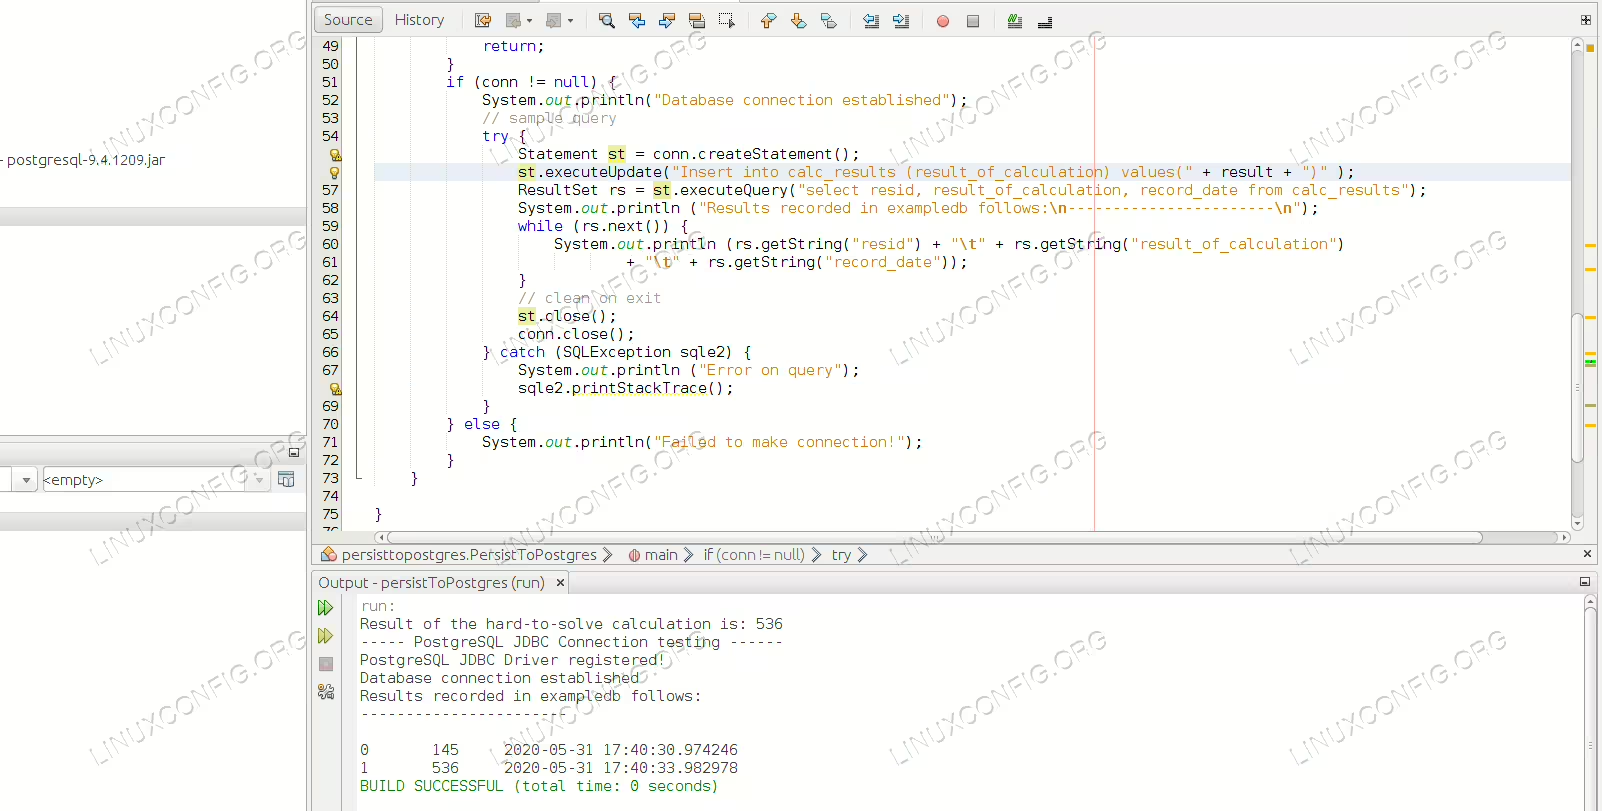
アプリケーションの実行結果。
ソフトウェアの要件と使用される規約
セットアップ
このチュートリアルの目的のために、すべての必要なコンポーネントをインストールするために、ワークステーション(デスクトップまたはノートパソコン)が1台あれば十分です。JDK、NetBeans IDE、およびラボマシンへのPostgreSQLデータベースのインストールについては説明しません。exampledbという名前のデータベースが稼働していると仮定し、次の資格情報を使用して、パスワード認証で接続、読み取り、書き込みができるものとします。
| ユーザー名: | 例のユーザー |
| パスワード: | ExamplePass |
これは例の設定です。実際のシナリオでは強力なパスワードを使用してください!データベースはlocalhostでリッスンするように設定されており、JDBCの接続URLを構築する際に必要になります。
私たちのアプリケーションの主な目的は、データベースへの書き込みと読み取りの方法を示すことです。そのため、保存したい貴重な情報については、1から1000の間のランダムな数を選び、その情報を計算の一意のIDおよびデータがデータベースに記録された正確な時刻とともに保存します。
IDと録音の時間はデータベースによって提供され、これにより私たちのアプリケーションは実際の問題のみ(この場合はランダムな番号を提供すること)に取り組むことができます。これは故意に行われており、このチュートリアルの最後にこのアーキテクチャの可能性について説明します。
アプリケーションのためのデータベースを設定しています
私たちは稼働中のデータベースサービスを持っており、上記の認証情報で作業する権利を持つ exampledb というデータベースがあります。貴重な(ランダムな)データを保存する場所が必要なので、テーブルを作成して、便利な方法でユニークな識別子を提供するシーケンスも作成する必要があります。次のSQLスクリプトを考えてみてください:
create sequence resultid_seq start with 0 increment by 1 no maxvalue minvalue 0 cache 1;
alter sequence resultid_seq owner to exampleuser;
create table calc_results (
        resid numeric primary key default nextval('resultid_seq'::regclass),
        result_of_calculation numeric not null,
        record_date timestamp default now()
);
alter table calc_results owner to exampleuser;
これらの指示は自明であるべきです。シーケンスを作成し、所有者をexampleuserに設定し、calc_resultsという名前のテーブル(「計算結果」を意味する)を作成し、residを挿入のたびにシーケンスの次の値で自動的に埋められるように設定し、データを保存するためのresult_of_calculationおよびrecord_date列を定義します。最後に、テーブルの所有者もexampleuserに設定されます。
これらのデータベースオブジェクトを作成するために、postgresユーザーに切り替えます。
sudo su - postgres
そして、exampledb データベースに対して table_for_java.sql というテキストファイルに保存されているスクリプトを実行します:
psql -d exampledb < table_for_java.sql
CREATE SEQUENCE
ALTER SEQUENCE
CREATE TABLE
ALTER TABLE
これで、私たちのデータベースは準備が整いました。
プロジェクトにPostgreSQL JDBCドライバーをインポートする
アプリケーションを構築するために、NetBeans IDE 8.2を使用します。最初の数ステップは手作業です。ファイルメニューを選択し、新しいプロジェクトを作成します。ウィザードの次のページでは、デフォルトの設定をそのままにし、「Java」のカテゴリと「Javaアプリケーション」のプロジェクトを選択します。「次へ」を押します。アプリケーションに名前を付けます(オプションでデフォルト以外の場所を定義することもできます)。私たちの場合、persistToPostgresと呼ばれます。これにより、IDEが基本的なJavaプロジェクトを作成します。
プロジェクトパネルで「ライブラリ」を右クリックし、「ライブラリの追加...」を選択します。新しいウィンドウが表示されるので、PostgreSQL JDBCドライバーを検索して選択し、ライブラリとして追加します。
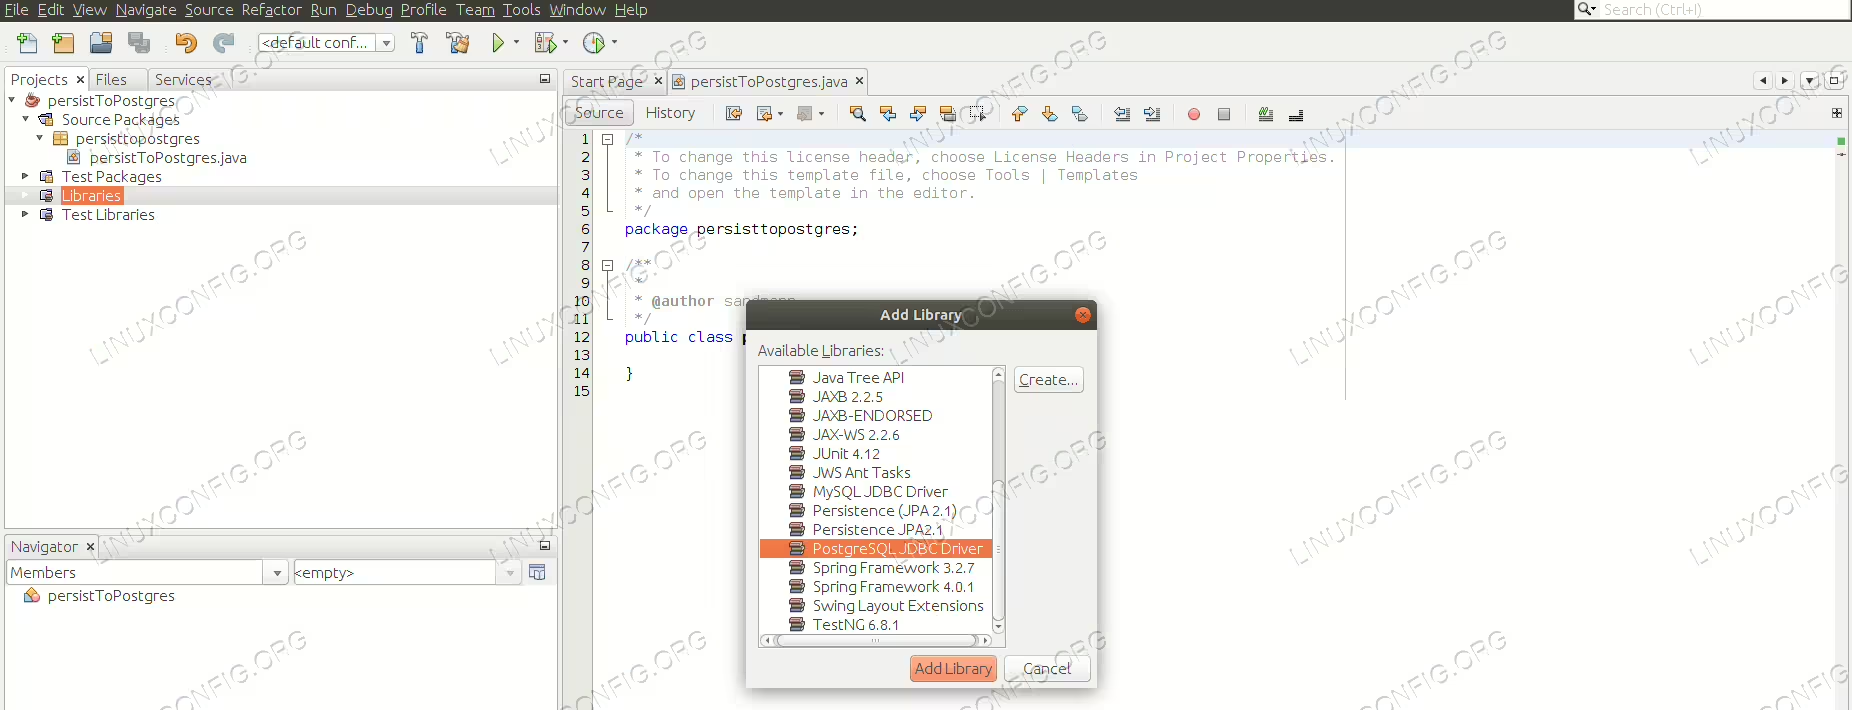
プロジェクトにPostgreSQL JDBCドライバーを追加する。
ソースコードを理解する
次に、アプリケーションのメインクラス「PersistToPostgres」に以下のソースコードを追加します:
package persisttopostgres;

import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.ResultSet;
import java.sql.SQLException;
import java.sql.Statement;
import java.util.concurrent.ThreadLocalRandom;

public class PersistToPostgres {
    public static void main(String[] args) {
        int result = ThreadLocalRandom.current().nextInt(1, 1000 + 1);
        System.out.println("Result of the hard-to-solve calculation is: " + result);
        System.out.println("-----PostgreSQL JDBC Connection testing------");
        try {
            Class.forName("org.postgresql.Driver");
        } catch (ClassNotFoundException cnfe) {
            System.out.println("No PostgreSQL JDBC Driver in library path!");
            cnfe.printStackTrace();
            return;
        }
        System.out.println("PostgreSQL JDBC Driver registered!");
        Connection conn = null;

        try {
            conn = DriverManager.getConnection("jdbc:postgresql://localhost:5432/exampledb", "exampleuser", "ExamplePass");
        } catch (SQLException sqle) {
            System.out.println("Connection failed! Check output console");
            sqle.printStackTrace();
            return;
        }
        if (conn != null) {
            System.out.println("Database connection established");
            // building query
            try {
                Statement st = conn.createStatement();
                st.executeUpdate("Insert into calc_results (result_of_calculation) values(" + result + ")" );
                ResultSet rs = st.executeQuery("select resid, result_of_calculation, record_date from calc_results");
                System.out.println ("Results recorded in exampledb follows:\n-----------------------\n");
                while (rs.next()) {
                    System.out.println (rs.getString("resid") + "\t" + rs.getString("result_of_calculation") + "\t" + rs.getString("record_date"));
                }
                // clean on exit
                st.close();
                conn.close();
            } catch (SQLException sqle2) {
                System.out.println ("Error on query");
                sqle2.printStackTrace();
            }
        } else {
            System.out.println("Failed to make connection!");
        }
    }
}
- 12行目でランダムな数を計算し、それを結果を格納する変数
resultに保存します。この数は、データベースに保存する必要がある複雑な計算の結果を表しています。 - 「15行目で、PostgreSQL JDBCドライバーを登録しようとします。アプリケーションが実行時にドライバーを見つけられない場合、エラーが発生します。」
- 26行目では、データベースが実行されているホスト名(localhost)、データベースがリッスンしているポート(5432、PostgreSQLのデフォルトポート)、データベース名(exampledb)、および最初に記載された認証情報を使用してJDBC接続文字列を構築します。
- 37行目で、
result変数の値をcalc_resultsテーブルのresult_of_calculation列に挿入するinsert intoSQL文を実行します。この単一の列の値だけを指定するので、デフォルトが適用されます:residは設定したシーケンスから取得され、record_dateはデフォルトでnow()、つまりトランザクション時のデータベース時間になります。 - 38行目で、前のステップで挿入したデータを含む、テーブル内のすべてのデータを返すクエリを構築します。
- 行39から、データを表形式で印刷することによって取得したものを提示し、リソースを解放し、終了します。
アプリケーションを実行する
今、IDE自体またはコマンドラインから、persistToPostgresアプリケーションをクリーン、ビルド、実行できます。IDEから実行するには、上部の「プロジェクトを実行」ボタンを使用します。コマンドラインから実行するには、プロジェクトのdistディレクトリに移動し、JARパッケージを引数としてJVMを呼び出す必要があります:
java -jar persistToPostgres.jar
Result of the hard-to-solve calculation is: 173
-----PostgreSQL JDBC Connection testing------
Database connection established
Results recorded in exampledb follows:
-----------------------

0       145     2020-05-31 17:40:30.974246
コマンドラインの実行はIDEコンソールと同じ出力を提供しますが、ここで重要なのは、各実行(IDEからでもコマンドラインからでも)が、各実行時に計算された与えられたランダム番号を持つ別の行をデータベースのテーブルに挿入することです。
これが、アプリケーションの出力におけるレコードの数が増えていく理由です:各実行によりテーブルが1行増えます。数回の実行後には、テーブルに結果行の長いリストが表示されるでしょう。

データベースの出力はアプリケーションのすべての実行結果を示します。
結論
このシンプルなアプリケーションは実際の使用例がほとんどありませんが、いくつかの重要な側面を示すには最適です。このチュートリアルでは、アプリケーションで重要な計算を行い、その都度ランダムな数を挿入すると述べました。なぜなら、このチュートリアルの目的はデータを持続させる方法を示すことだからです。この目標は達成しました:アプリケーションは毎回終了し、内部計算の結果は失われますが、データベースはデータを保存します。
私たちは単一のワークステーションからアプリケーションを実行しましたが、もし本当に複雑な計算を解決する必要があるなら、データベース接続URLをリモートマシンに変更するだけで、複数のコンピュータで同時に計算を開始でき、このアプリケーションの数百または数千のインスタンスを作成し、より大きなパズルの小さな部分を解決し、結果を永続的に保存することができるでしょう。これにより、わずか数行のコードと少しの計画で計算能力をスケールアップすることが可能になります。
なぜ計画が必要なのか?この例を考えると、もし私たちが行の識別子やタイムスタンプの割り当てをデータベースに任せなかったら、私たちのアプリケーションはもっと大きく、もっと遅く、そしてもっとバグが多くなっていたでしょう。その中には、同時にアプリケーションの2つのインスタンスを実行したときにだけ表面化するバグもあります。