EDA - 探索的データ分析:Python関数の使用

前の記事では、グラフィカルな方法を使用してEDAを実行する方法を見てきました。この記事では、Pythonでの探索的データ分析に使用されるPython関数に焦点を当てます。EDAがどれだけ重要であるかは、データについての簡潔な理解を提供することからわかります。では、無駄な時間をかけずに始めましょう!
探索的データ分析 - EDA
- EDAはデータを調査し、重要な洞察を要約するために適用されます。
- それはあなたのデータの基本的な理解、分布、NULL値などを提供します。
- データをグラフを使って探索するか、いくつかのPython関数を通じて探索することができます。
- 分析には2つのタイプがあります。単変量と二変量。 単変量では、1つの属性を分析します。しかし、二変量では、ターゲット属性と一緒に属性を分析します。
- 非グラフィカルアプローチでは、shape、summary、describe、isnull、info、datatypesなどの関数を使用します。
- グラフィカルアプローチでは、散布図、箱ひげ図、棒グラフ、密度図、相関図などのプロットを使用します。
データをロードする
まずはじめに、エクスプロラトリーデータ分析(EDA)を行うために、タイタニックのデータセットをPythonに読み込みます。
#Load the required libraries
import pandas as pd
import numpy as np
import seaborn as sns

#Load the data
df = pd.read_csv('titanic.csv')


#View the data
df.head()

私たちのデータは探求する準備ができています!
1. データに関する基本情報 - EDA
df.info() 関数は、データセットに関する基本情報を提供します。どんなデータに対しても、その情報を知ることから始めるのが良いです。私たちのデータでどのように機能するか見てみましょう。
#Basic information

df.info()

#Describe the data

df.describe()

- データの説明 - 記述統計。

この機能を使用すると、上記の出力に表示されているように、ヌル値の数、データ型、およびメモリ使用量とともに、記述統計を確認できます。
2. 重複値
df.duplicate.sum() 関数を使用して、もしあれば存在する重複値の合計を求めることができます。この関数は、データに存在する場合、重複値の数を表示します。
#Find the duplicates

df.duplicated().sum()
0
さて、その関数は '0' を返しました。これは、私たちのデータセットに重複値が一つも存在しないことを意味しており、知っておくべき非常に良いことです。
3. データ内のユニークな値
特定の列におけるユニークな値の数は、pythonのunique()関数を使用して見つけることができます。
#unique values

df['Pclass'].unique()

df['Survived'].unique()

df['Sex'].unique()
array([3, 1, 2], dtype=int64)


array([0, 1], dtype=int64)


array(['male', 'female'], dtype=object)
unique() 関数は、データに存在するユニークな値を返し、それは非常に素晴らしいです!
4. ユニークカウントを可視化する
はい、データに存在するユニークな値を視覚化できます。そのために、seabornライブラリを使用します。sns.countplot()関数を呼び出し、カウントプロットを描画する変数を指定する必要があります。
#Plot the unique values

sns.countplot(df['Pclass']).unique()

それは素晴らしいです!あなたはうまくやっています。それはそれほど簡単です。ただし、EDAには2つのアプローチがあり、グラフィカルと非グラフィカルを組み合わせることで、全体像を把握することができます。
5. NULL値を見つける
欠損値を見つけることは、探索的データ分析(EDA)において最も重要なステップです。何度も言ったように、データの品質を確保することが重要です。それでは、欠損値をどのように見つけることができるか見てみましょう。
#Find null values

df.isnull().sum()
PassengerId      0
Survived         0
Pclass           0
Name             0
Sex              0
Age            177
SibSp            0
Parch            0
Ticket           0
Fare             0
Cabin          687
Embarked         2

dtype: int64
ああ、‘年齢’と‘キャビン’の変数にヌル値がいくつかあります。しかし、心配しないでください。私たちはすぐにそれらに対処する方法を見つけます。
6. NULL値を置き換える
こんにちは、すべてのnull値を特定のデータで置き換えるためのreplace()関数があります。それはとても良いです!
#Replace null values

df.replace(np.nan,'0',inplace = True)

#Check the changes now
df.isnull().sum()
PassengerId    0
Survived       0
Pclass         0
Name           0
Sex            0
Age            0
SibSp          0
Parch          0
Ticket         0
Fare           0
Cabin          0
Embarked       0

dtype: int64
ワオ!それは素晴らしいですね。データ内のヌル値を見つけて置き換えるのは非常に簡単です。私はヌル値を0に置き換えました。平均や中央値のようなより意味のある方法を選ぶこともできます。
7. データ型を知る
探索しているデータ型を知ることは非常に重要であり、プロセスも簡単です。どのように機能するか見てみましょう。
#Datatypes

df.dtypes
PassengerId      int64
Survived         int64
Pclass           int64
Name            object
Sex             object
Age             object
SibSp            int64
Parch            int64
Ticket          object
Fare           float64
Cabin           object
Embarked        object

dtype: object
それでおしまいです。このためにdtypes関数を使用する必要があります。そうすれば、各属性のデータ型を取得できます。
8. データをフィルタリングする
はい、いくつかのロジックに基づいてデータをフィルタリングできます。
#Filter data

df[df['Pclass']==1].head()

上記のコードがクラス1に属するデータ値のみを返したことがわかります。
9. クイックボックスプロット
任意の数値列に対して、一行のコードを使用して箱ひげ図を作成できます。
#Boxplot

df[['Fare']].boxplot()

10. 相関プロット - EDA
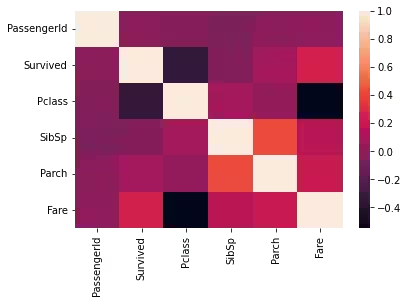
最後に、変数間の相関を見つけるために、相関関数を利用することができます。これにより、異なる変数間の相関の強さの概念を理解することができます。
#Correlation

df.corr()

これは、+1 から -1 までの範囲を持つ相関行列で、+1 は非常に正の相関があり、-1 は非常に負の相関があることを示しています。
下に示すように、seabornライブラリを使用して相関行列を視覚化することもできます。
#Correlation plot

sns.heatmap(df.corr())
エンディングノート - EDA
EDAは、あらゆる分析の最も重要な部分です。データについて多くのことを知ることができます。EDAを使えば、ほとんどの質問の答えを見つけることができるでしょう。データを視覚的に探るために使用されるPythonの関数の多くを示そうとしました。この記事から何か得られたことを願っています。
今のところそれだけです!楽しいPythonを :)
さらに読む: 探索的データ分析