SRGAN: 超解像生成対抗ネットワーク

高解像度の画像と高画質の動画は、現在の人々がリラックスと休息を楽しむための最も人気のある必需品の一つです。特定の画像や動画の品質が高いほど、視聴者にとって全体的な視聴体験がより快適で注目されるものになります。今日の世界で開発されたすべての近代的な視覚技術は、高品質のビデオとオーディオパフォーマンスの要件を満たすことを目的としています。これらの画像や動画の品質が急速に向上する中で、これらの製品の需要と供給も急増しています。しかし、プロセス中に直面する技術的制限により、最高品質の画像や動画を常に達成または生成することが可能であるとは限りません。
超解像生成敵対ネットワーク(SRGAN)は、技術的制約やその他の理由によって生じるこれらの問題への解決策を提供します。これらの素晴らしいGANアーキテクチャの助けを借りることで、低解像度の画像や動画コンテンツを高解像度のエンティティにアップスケールすることができます。
この記事では、私たちの主な目的は、これらのSRGANモデルアーキテクチャを使用して、低品質の画像から超解像画像を実現することです。SRGANネットワークのアーキテクチャを探求し、シンプルなプロジェクトを構築します。
この記事では、SRGANの助けを借りて低解像度画像を超解像度画像に変換する方法を理解するための基本的な内容のほとんどをカバーします。さまざまな解像度スペクトルの簡単な紹介とSRGANの基本概念の理解の後、SRGANのアーキテクチャを実装します。生成器と識別器モデルの両方を構築し、それらを利用してSRGANに関連する多くのプロジェクトを構築できます。最後に、これらのアーキテクチャを使用してプロジェクトを開発し、その実装がどのように機能するかをさらに理解します。
紹介
この超解像画像のトピックにさらに進む前に、現代世界に存在するビデオ品質のさまざまなスペクトルを理解しましょう。オンラインでビデオを視聴する際の典型的な低品質は、144p、240p、または360pです。これらの解像度は、特定のビデオをストリーミングまたは視聴する際の低品質を示しています。そのような低解像度では、特定の視覚表現の微細な詳細やより適切な関心事は、人間の目には検出できないかもしれません。そのため、視聴者にとって全体的な体験は期待通りに美的に満足できるものではないかもしれません。
480p解像度は、ほとんどの視聴フォーマットにおける最小標準解像度と呼ばれています。この解像度は640 x 480の画素サイズをサポートし、コンピュータの初期の時代における典型的な規範でした。この標準定義(SD)の視覚表現はアスペクト比4:3を持ち、ほとんどの表現にとっての規範と考えられています。スケーリングのラインを進むと、高解像度(HD)があり、720pから始まります。720pは通常約1280 x 720の画素サイズを持っています。
次に、フルハイビジョン(FHD)があり、1080pの短縮形は1920x1080のピクセルサイズを表し、さらに、1440pの短縮形であるクワッドハイビジョン(QHD)もあります。これらの三つのスケールはすべて16:9のアスペクト比を持ち、ほとんどの通常のコンピューティングエンジンで広く使用されているスケールのいくつかです。最終的なスケーリング範囲には、2K、4K、8K解像度など、より現代的な視覚スペクトラムが含まれます。技術の進歩に伴い、これらの画像や動画の品質をさらに向上させ、視聴者や観客が可能な限り最高の体験を得られることを目指しています。
しかし、時には望ましい画像品質や動画品質が得られないことに気付くかもしれません。原因としては、カメラのレンズの種類、スケーリング機能、効率的な技術の欠如、効果的でない編集、背景のぼかし撮影、またはその他の類似の要因が考えられます。一部のソフトウェアはこの問題を解決するのに役立つかもしれませんが、これらの問題に対抗するための最良の先進的な解決策の一つは、深層学習ニューラルネットワーク、すなわち超解像生成的敵対ネットワーク(SRGAN)のアーキテクチャを使用して、これらの低解像度の画像(または動画)を高品質のコンテンツに変換することです。
上記のGIF表現では、動画の低画質の解像度が135pの視聴スケールにあることがわかり、画像内の重要な詳細がいくつか欠けていることがわかります。細かい岩の粒子の飛行や宇宙船の全体像など、コンテンツの全体的な品質はかなりぼやけて見えます。しかし、SRGANを使用することで、動画は540p形式に変換され、視聴者は映画の複雑な詳細をより良く視覚化できるようになりました。インターステラーの映画シーンの一部の低解像度から高解像度への変換の素晴らしい仕事を示しているため、画像ソースとして以下のクリップを確認することをお勧めします。次に、SRGANの概念的理解を深め、それに基づいて実装を進めていきましょう。
前提条件
生成的敵対ネットワーク(GAN)の基本:生成器と識別器の役割を含むGANのアーキテクチャと機能の理解。
ディープラーニングの基本知識:特に畳み込みニューラルネットワーク(CNN)に対する知識が必要で、これは画像処理タスクにおいて重要です。
画像処理の経験:画像解像度の概念、画像アップスケーリング技術、および品質評価指標(PSNRやSSIMなど)の理解。
Pythonのプログラミングスキル:特に、SRGANモデルを実装およびトレーニングするためのTensorFlowやPyTorchなどのライブラリを使用したPythonの習熟度。
最適化手法に関する理解: 損失関数、バックプロパゲーション、正則化など、深層学習モデルのトレーニングに関する基本的な知識。
SRGANの理解
SRGANの概念は、大部分の画像ビジュアルに対してほぼ4倍のアップスケーリング係数を達成するモデルの最初の技術の1つです。低解像度の画像から高解像度の画像を推定し生成するというアイデアは、非常に難しいタスクです。以前はCNNが使用され、高解像度の画像を生成し、より早くトレーニングし、高度な精度を達成していました。しかし、場合によっては、細かい詳細を回復できず、ぼやけた画像を生成することがよくあります。提案されたSRGANアーキテクチャは、高品質で最先端の画像を生成するためのこれらの問題のほとんどに対処します。
超解像に関わるほとんどの教師ありアルゴリズムは、取得した高解像度画像と特定の画像の真の値との間の平均二乗誤差損失を利用します。この方法は便利であることが証明されています。なぜなら、平均二乗誤差の最小化は自動的にピーク信号対雑音比(PSNR)を最大化するからです。PSNRは超解像画像の評価に使用される最も一般的な用語の一つです。しかし、これらの用語は各ピクセルの特徴を見つけることに向けられており、特定の画像の高いテクスチャの詳細など、より視覚的な属性には焦点を当てていません。
したがって、生成的敵対ネットワークを使用したフォトリアリスティック単一画像超解像生成に関する以下の研究論文は、最近導入された損失である知覚損失の助けを借りて、より知覚的な特徴に対抗するために決定される損失を提案します。VGG損失は、リアルタイムスタイル転送と超解像のための知覚損失のスタイル転送および超解像フレームワークで導入されたコンテンツ損失の一種です。知覚損失は、敵対的損失とコンテンツ損失の両方を組み合わせたものです。この損失の定式化は、次の解釈と共に解釈することができます。

この損失は平均二乗誤差損失よりも好まれます、なぜなら私たちは画像の画素ごとの比較を気にしないからです。私たちは主に画像の質の向上を気にしています。したがって、SRGANモデルでこの損失関数を使用することで、より望ましい結果を達成することができます。
SRGANアーキテクチャの分解
この記事のこのセクションでは、SRGANアーキテクチャの構築についてさらに詳しく理解します。ジェネレーターとディスクリミネーターのアーキテクチャをそれぞれ探り、どのように機能するのかを理解します。ジェネレーターのアーキテクチャは、基本的に高品質の超解像画像を生成するために利用される完全畳み込みSRRESNETモデルです。ディスクリミネーターモデルは画像分類器として機能し、全体のアーキテクチャが画像の品質に応じて調整され、生成された画像がより最適になるように構築されています。SRGANアーキテクチャは、高い知覚的品質を持つ自然な画像を生成します。
ジェネレーター

画像ソース
SRRESNETジェネレーターネットワークのジェネレーターアーキテクチャは、低解像度の入力から始まり、9×9のカーネルと64のフィーチャーマップを持つ最初の畳み込み層を通過し、その後にパラメトリックReLU層が続きます。全体のジェネレーターアーキテクチャが主要な活性化関数としてパラメトリックReLUを使用していることが注目されます。パラメトリックReLUを選ぶ理由は、低解像度の画像を高解像度の画像にマッピングするという特定のタスクにおいて最も優れた非線形関数の1つであるためです。
ReLUのような活性化関数は、次の作業を実行することもできますが、負の値が直接ゼロにマッピングされることによって、死んだニューロンの概念から生じる問題があります。代替オプションとしては、負の値がユーザーによって設定された数にマッピングされるLeaky ReLUがあります。しかし、パラメトリックReLUの場合、ニューラルネットワークに最適な値を自ら選ばせることができるため、このシナリオでは好まれます。
フィードフォワードの完全畳み込みSRRESNETモデルの次のレイヤーは、一連の残差ブロックを利用します。各残差ブロックには、3×3のカーネルと64の特徴マップを持つ畳み込み層が含まれており、その後にバッチ正規化層、パラメトリックReLU活性化関数、別の畳み込み層とバッチ正規化が続き、最後に要素ごとの和を取る方法があります。要素ごとの和を取る方法は、フィードフォワード出力とスキップ接続出力を使用して最終的な結果を提供します。
以下の神経ネットワークアーキテクチャについて注意すべき重要な点は、各畳み込み層が類似のパディングを使用しており、次の入力と出力のサイズが変わらないということです。他の完全畳み込みネットワーク、たとえばU-Netアーキテクチャは、画像サイズを減少させるためにプーリング層をよく使用します。しかし、私たちのSRGANモデルでは画像サイズを減少させる必要がないため、これを必要としません。むしろ、私たちが達成しようとしているのはその逆です。
残差ブロックが構築されると、ジェネレーターモデルの残りの部分が構築されます。上の画像の表現に示されているように、私たちはこのジェネレーターモデルのアーキテクチャで、畳み込み層の4倍のアップサンプリングの後にピクセルシャッフラーを使用して超解像画像を生成します。ピクセルシャッフラーは、チャネル次元から値を取得し、それらを高さと幅の次元に配置します。この場合、高さと幅はそれぞれ2倍にされ、チャネルは2で割られます。この記事の次のセクションでは、ジェネレーターアーキテクチャの構築のためのコードを詳細に説明します。
識別器

画像ソース
識別器のアーキテクチャは、典型的なGAN手法をサポートするために最適な方法で構築されています。生成器と識別器は互いに競い合い、同時に改善されています。識別器ネットワークが偽の画像を見つけようとする一方で、生成器は識別器からの検出を逃れるためにリアルな画像を生成しようとしています。SRGANの場合でも同様の動作が行われ、生成モデルGは、スーパーレゾリューション画像と実際の画像を区別するために訓練された微分可能な識別器Dを欺くことを目的としています。
したがって、上の画像に示された識別器アーキテクチャは、超解像画像と実際の画像を区別するために機能します。構築された識別器モデルは、敵対的なミニマックス問題を解決することを目的としています。この方程式の定式化の一般的な考え方は、次のように解釈できます:
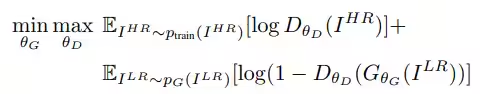
構築された識別器のアーキテクチャは非常に直感的で理解しやすいです。最初に畳み込み層を使用し、その後にLeaky ReLU活性化関数を用います。この構造のLeaky ReLUのアルファ値は0.2に設定されています。それから、畳み込み層の繰り返しブロックがいくつか続き、その後にバッチ正規化層とLeaky ReLU活性化関数があります。この繰り返しブロックを5つ持つと、分類アクションを行うための全結合層とシグモイド活性化関数があります。最初の畳み込みサイズは64 x 64で、2つの完全なブロックごとに2倍され、最終的に512 x 512の8倍のアップスケーリングファクターに達します。この識別器モデルは、ジェネレーターがより効果的に学習し、より良い結果を生み出す手助けをします。
SRGANを使ったプロジェクトの開発
この記事のこのセクションでは、SRGANを使用してプロジェクトを展開します。このタスクを完了するために利用できるデータセットは多数あります。この研究論文では、ImageNetデータセットから35万枚のランダムなサンプルを利用しています。しかし、ImageNetデータセットのサイズは約150GBであり、そのようなモデルのトレーニングには多くの時間がかかります。したがって、このプロジェクトでは、約5GBのサイズのDiverse 2k(div2k)データセットを利用します。
このプロジェクトでは、SRGANモデルを構築し、必要に応じてトレーニングするために、TensorFlowとKerasの深層学習フレームワークを使用します。このプロジェクトの構築に使用されるコードの大部分は、私が強く推奨する以下のGitHubリポジトリから考慮されています。実際、データセットとutilsフォルダを作業ディレクトリにダウンロードすることをお勧めします。これにより、データの抽出が簡単になり、SRGANアーキテクチャモデルの構築とトレーニングに集中できます。
必須のライブラリをインポートしています
SRGANプロジェクトを始めるための最初のステップは、次のタスクを実行するために必要なすべての必須ライブラリを実装することです。デバイスでTensorFlowのGPUバージョンが有効になっていることを確認し、以下のコードブロックに記載されている必要なライブラリをすべてインポートしてください。損失、オプティマイザー、レイヤー、VGG16損失用のVGG19アーキテクチャ、その他の必要なライブラリです。他に重要なインポートは、前述のGitHubリンクからダウンロードしたフォルダからの直接インポートです。データセットとutilsフォルダが作業ディレクトリに配置されていることを確認してください。これらはデータセットの準備を簡素化し、モデルの学習の手間を減らすために使用されます。
import tensorflow as tf
from tensorflow.keras.optimizers import Adam
from tensorflow.keras.optimizers.schedules import PiecewiseConstantDecay
from tensorflow.keras.losses import MeanSquaredError, BinaryCrossentropy, MeanAbsoluteError
from tensorflow.keras.layers import Input, Conv2D, BatchNormalization, Add, Lambda, LeakyReLU, Flatten, Dense
from tensorflow.python.keras.layers import PReLU
from tensorflow.keras.applications.vgg19 import VGG19, preprocess_input
from tensorflow.keras.models import Model
from tensorflow.keras.metrics import Mean
from PIL import Image
import time
import os

from datasets.div2k.parameters import Div2kParameters
from datasets.div2k.loader import create_training_and_validation_datasets
from utils.normalization import normalize_m11, normalize_01, denormalize_m11
from utils.dataset_mappings import random_crop, random_flip, random_rotate, random_lr_jpeg_noise
from utils.metrics import psnr_metric
from utils.config import config
from utils.callbacks import SaveCustomCheckpoint
データセットの準備
DIVerse 2Kデータセットには、SRGANsモデルの構築に最適な高品質の画像が多数の解像度で含まれています。このデータセットは、以下のウェブサイトからダウンロードできます。この記事の残りを続けるために、以下のコードスニペットで言及されている4つの個別のzipファイルをそれぞれダウンロードすることをお勧めします。これらの4つのファイルには、低解像度および高解像度画像のトレーニングファイルと検証ファイルが含まれています。ダウンロードが完了したら、それに応じて抽出できます。
新しいディレクトリをdiv2kというラベルで作成し、すべての抽出されたファイルを新しく作成したディレクトリに配置してください。我々のモデルは、低解像度の画像とそれに対応する高解像度の画像を利用します。研究論文では、96 x 96のサイズのランダムクロップを利用しているため、我々のトレーニング方法でも同じサイズを使用します。低解像度画像の各サンプルは、それに対応する高解像度のパッチに応じてクロップされます。
Dataset Link - https://data.vision.ee.ethz.ch/cvl/DIV2K/
http://data.vision.ee.ethz.ch/cvl/DIV2K/DIV2K_train_LR_bicubic_X4.zip
https://data.vision.ee.ethz.ch/cvl/DIV2K/DIV2K_valid_LR_bicubic_X4.zip
http://data.vision.ee.ethz.ch/cvl/DIV2K/DIV2K_train_HR.zip
http://data.vision.ee.ethz.ch/cvl/DIV2K/DIV2K_valid_HR.zip

dataset_key = "bicubic_x4"
data_path = config.get("data_path", "")
div2k_folder = os.path.abspath(os.path.join(data_path, "div2k"))

dataset_parameters = Div2kParameters(dataset_key, save_data_directory=div2k_folder)

hr_crop_size = 96

train_mappings = [
    lambda lr, hr: random_crop(lr, hr, hr_crop_size=hr_crop_size, scale=dataset_parameters.scale),
    random_flip,
    random_rotate,
    random_lr_jpeg_noise]

train_dataset, valid_dataset = create_training_and_validation_datasets(dataset_parameters, train_mappings)

valid_dataset_subset = valid_dataset.take(10)
SRRESNETジェネレーターアーキテクチャを構築する
SRRESNETジェネレーターアーキテクチャは、前のセクションで詳細に説明された通りに正確に構築されています。モデルのアーキテクチャは、全体の構造のサイズが構築しやすくなるようにいくつかの機能に分かれています。ピクセルシャッフルブロックを定義し、データをアップサンプリングするためのピクセルシャッフルレイヤーとそれに関連する関数を定義します。次に、3×3カーネルと64のフィーチャーマップからなる畳み込み層の連続的な組み合わせを含む残差ブロックのための別の関数を定義します。その後にバッチ正規化層、パラメトリックReLU活性化関数、バッチ正規化を伴うもう1つの畳み込み層、最後にフィードフォワードとスキップ接続を使用する要素ごとの合計法を用います。
upsamples_per_scale = {
    2: 1,
    4: 2,
    8: 3
}


pretrained_srresnet_models = {
    "srresnet_bicubic_x4": {
        "url": "https://image-super-resolution-weights.s3.af-south-1.amazonaws.com/srresnet_bicubic_x4/generator.h5",
        "scale": 4
    }
}


def pixel_shuffle(scale):
    return lambda x: tf.nn.depth_to_space(x, scale)


def upsample(x_in, num_filters):
    x = Conv2D(num_filters, kernel_size=3, padding='same')(x_in)
    x = Lambda(pixel_shuffle(scale=2))(x)
    return PReLU(shared_axes=[1, 2])(x)


def residual_block(block_input, num_filters, momentum=0.8):
    x = Conv2D(num_filters, kernel_size=3, padding='same')(block_input)
    x = BatchNormalization(momentum=momentum)(x)
    x = PReLU(shared_axes=[1, 2])(x)
    x = Conv2D(num_filters, kernel_size=3, padding='same')(x)
    x = BatchNormalization(momentum=momentum)(x)
    x = Add()([block_input, x])
    return x


def build_srresnet(scale=4, num_filters=64, num_res_blocks=16):
    if scale not in upsamples_per_scale:
        raise ValueError(f"available scales are: {upsamples_per_scale.keys()}")

    num_upsamples = upsamples_per_scale[scale]

    lr = Input(shape=(None, None, 3))
    x = Lambda(normalize_01)(lr)

    x = Conv2D(num_filters, kernel_size=9, padding='same')(x)
    x = x_1 = PReLU(shared_axes=[1, 2])(x)

    for _ in range(num_res_blocks):
        x = residual_block(x, num_filters)

    x = Conv2D(num_filters, kernel_size=3, padding='same')(x)
    x = BatchNormalization()(x)
    x = Add()([x_1, x])

    for _ in range(num_upsamples):
        x = upsample(x, num_filters * 4)

    x = Conv2D(3, kernel_size=9, padding='same', activation='tanh')(x)
    sr = Lambda(denormalize_m11)(x)

    return Model(lr, sr)
識別器モデルとSRGANアーキテクチャを構築する
識別器のアーキテクチャは、前のセクションで詳しく説明された通りに構築されています。私たちは、0.2のアルファ値を使用するLeaky ReLU活性化関数の後に畳み込み層を用います。最初のブロックには畳み込み層とLeaky ReLU活性化関数を追加します。残りの5つのブロックの識別器アーキテクチャは、畳み込み層の後にバッチ正規化層を使用し、最後にLeaky ReLU活性化関数層を追加します。アーキテクチャの最終層は、1024のパラメータを持つ全結合ノード、Leaky ReLU層、そして分類目的のためのシグモイド活性化関数を持つ最終の全結合密ノードです。識別器アーキテクチャを構築するための全体のコードスニペットについては、以下のコードブロックを参照してください。
def discriminator_block(x_in, num_filters, strides=1, batchnorm=True, momentum=0.8):
    x = Conv2D(num_filters, kernel_size=3, strides=strides, padding='same')(x_in)
    if batchnorm:
        x = BatchNormalization(momentum=momentum)(x)
    return LeakyReLU(alpha=0.2)(x)


def build_discriminator(hr_crop_size):
    x_in = Input(shape=(hr_crop_size, hr_crop_size, 3))
    x = Lambda(normalize_m11)(x_in)

    x = discriminator_block(x, 64, batchnorm=False)
    x = discriminator_block(x, 64, strides=2)

    x = discriminator_block(x, 128)
    x = discriminator_block(x, 128, strides=2)

    x = discriminator_block(x, 256)
    x = discriminator_block(x, 256, strides=2)

    x = discriminator_block(x, 512)
    x = discriminator_block(x, 512, strides=2)

    x = Flatten()(x)

    x = Dense(1024)(x)
    x = LeakyReLU(alpha=0.2)(x)
    x = Dense(1, activation='sigmoid')(x)

    return Model(x_in, x)
SRGANモデルのトレーニング
SRGANアーキテクチャの構築が成功裏に完了したので、モデルのトレーニングに進むことができます。生成モデルと識別モデルをそれぞれのモデルに保存してください。このモデルで使用する永続的損失の解釈のためにVGGモデルを定義します。チェックポイントを作成し、生成ネットワークと識別ネットワークの両方のオプティマイザーを定義します。次のステップを完了したら、SRGANモデルのトレーニングに進むことができます。
generator = build_srresnet(scale=dataset_parameters.scale)
generator.load_weights(weights_file)
discriminator = build_discriminator(hr_crop_size=hr_crop_size)

layer_5_4 = 20
vgg = VGG19(input_shape=(None, None, 3), include_top=False)
perceptual_model = Model(vgg.input, vgg.layers[layer_5_4].output)

binary_cross_entropy = BinaryCrossentropy()
mean_squared_error = MeanSquaredError()

learning_rate=PiecewiseConstantDecay(boundaries=[100000], values=[1e-4, 1e-5])
generator_optimizer = Adam(learning_rate=learning_rate)
discriminator_optimizer = Adam(learning_rate=learning_rate)

srgan_checkpoint_dir=f'./ckpt/srgan_{dataset_key}'

srgan_checkpoint = tf.train.Checkpoint(step=tf.Variable(0),
                                       psnr=tf.Variable(0.0),
                                       generator_optimizer=Adam(learning_rate),
                                       discriminator_optimizer=Adam(learning_rate),
                                       generator=generator,
                                       discriminator=discriminator)

srgan_checkpoint_manager = tf.train.CheckpointManager(checkpoint=srgan_checkpoint,
                           directory=srgan_checkpoint_dir,
                           max_to_keep=3)

 if srgan_checkpoint_manager.latest_checkpoint:
    srgan_checkpoint.restore(srgan_checkpoint_manager.latest_checkpoint)
    print(f'Model restored from checkpoint at step {srgan_checkpoint.step.numpy()} with validation PSNR {srgan_checkpoint.psnr.numpy()}.')
@tf.functionというデコレーターとして機能するものを使用することで、私たちのPythonコマンドはTensorFlowグラフの形に変換されます。モデルを望みどおりにコンパイルしてトレーニングするために、勾配テープ関数を利用します。生成器と識別器のネットワークを同時にトレーニングします。なぜなら、両方のモデルアーキテクチャを相互に改善させたいからです。前のセクションで説明したように、永久損失関数を利用します。トレーニングプロセスのコードは、私の以前のGANsの記事のいくつかに沿って視聴者が従ってきた場合、直感的に見えるに違いありません。そのトレーニングプロセスをより詳しくカバーしています。以下は、SRGANモデルのトレーニングプロセスを開始するためのコードスニペットです。
@tf.function
def train_step(lr, hr):
    with tf.GradientTape() as gen_tape, tf.GradientTape() as disc_tape:
        lr = tf.cast(lr, tf.float32)
        hr = tf.cast(hr, tf.float32)

        sr = srgan_checkpoint.generator(lr, training=True)

        hr_output = srgan_checkpoint.discriminator(hr, training=True)
        sr_output = srgan_checkpoint.discriminator(sr, training=True)

        con_loss = calculate_content_loss(hr, sr)
        gen_loss = calculate_generator_loss(sr_output)
        perc_loss = con_loss + 0.001 * gen_loss
        disc_loss = calculate_discriminator_loss(hr_output, sr_output)

    gradients_of_generator = gen_tape.gradient(perc_loss, srgan_checkpoint.generator.trainable_variables)
    gradients_of_discriminator = disc_tape.gradient(disc_loss, srgan_checkpoint.discriminator.trainable_variables)

    generator_optimizer.apply_gradients(zip(gradients_of_generator, srgan_checkpoint.generator.trainable_variables))
    discriminator_optimizer.apply_gradients(zip(gradients_of_discriminator, srgan_checkpoint.discriminator.trainable_variables))

    return perc_loss, disc_loss

@tf.function
def calculate_content_loss(hr, sr):
    sr = preprocess_input(sr)
    hr = preprocess_input(hr)
    sr_features = perceptual_model(sr) / 12.75
    hr_features = perceptual_model(hr) / 12.75
    return mean_squared_error(hr_features, sr_features)

def calculate_generator_loss(sr_out):
    return binary_cross_entropy(tf.ones_like(sr_out), sr_out)

def calculate_discriminator_loss(hr_out, sr_out):
    hr_loss = binary_cross_entropy(tf.ones_like(hr_out), hr_out)
    sr_loss = binary_cross_entropy(tf.zeros_like(sr_out), sr_out)
    return hr_loss + sr_loss
上記のコードブロックの実行が成功したら、以下に示す次のコードスニペットに進むことができます。トレーニング手順はかなり長い時間を要する場合があるため、システムの種類に応じて数時間から数日間モデルを訓練させることをお勧めします。そうすることで、私たちが開発したSRGANによって生成される最高の結果と高解像度の画像が得られます。各エポックの終了時に生成された画像は監視トレーニングフォルダに保存され、各エポックの終了時に生成された結果を確認することができます。また、以前に作成したチェックポイントコールバックのおかげで、最良の重みも保存されます。
perceptual_loss_metric = Mean()
discriminator_loss_metric = Mean()

step = srgan_checkpoint.step.numpy()
steps = 200000

monitor_folder = f"monitor_training/srgan_{dataset_key}"
os.makedirs(monitor_folder, exist_ok=True)

now = time.perf_counter()

for lr, hr in train_dataset.take(steps - step):
    srgan_checkpoint.step.assign_add(1)
    step = srgan_checkpoint.step.numpy()

    perceptual_loss, discriminator_loss = train_step(lr, hr)
    perceptual_loss_metric(perceptual_loss)
    discriminator_loss_metric(discriminator_loss)

    if step % 100 == 0:
        psnr_values = []

        for lr, hr in valid_dataset_subset:
            sr = srgan_checkpoint.generator.predict(lr)[0]
            sr = tf.clip_by_value(sr, 0, 255)
            sr = tf.round(sr)
            sr = tf.cast(sr, tf.uint8)

            psnr_value = psnr_metric(hr, sr)[0]
            psnr_values.append(psnr_value)
            psnr = tf.reduce_mean(psnr_values)

        image = Image.fromarray(sr.numpy())
        image.save(f"{monitor_folder}/{step}.png" )

        duration = time.perf_counter() - now

        now = time.perf_counter()

        print(f'{step}/{steps}, psnr = {psnr}, perceptual loss = {perceptual_loss_metric.result():.4f}, discriminator loss = {discriminator_loss_metric.result():.4f} ({duration:.2f}s)')

        perceptual_loss_metric.reset_states()
        discriminator_loss_metric.reset_states()

        srgan_checkpoint.psnr.assign(psnr)
        srgan_checkpoint_manager.save()
トレーニング手順は、使用しているシステムのタイプによってかなり長くなる可能性があることに注意してください。この問題を実行するための基本要件が提供されます。トレーニングされたSRGANモデルから多数の画像結果を生成しながら、生成的ニューラルネットワークの世界を自由に探求し、深く掘り下げてください。
結論
特定の視覚化におけるすべての重要な機能と属性の全体的な重み付けされた組み合わせは、表現の画像品質を分類することに寄与します。低解像度では、特定の画像や動画コンテンツのいくつかの細部や重要な詳細を強調できませんが、解像度を上げて指定されたエンティティの全体的な品質を向上させることで解決されます。現代の世界では、ほとんどの視覚化を最高品質で消費することを好むため、私たち視聴者が特定のコンテンツから最良の体験を得ることができるのです。したがって、超解像は現代世界において重要な意味を持つ概念であり、この記事では生成ニューラルネットワークの助けを借りて達成を目指したものです。
この記事では、画像の解像度の操作を始めるための重要な側面のほとんどを取り上げました。私たちは、異なる解像度のスケールと、低解像度を使用するよりも高解像度のスペクトルを得ることの重要性を理解しました。画像と動画の解像度の概念に関する簡単な知識を得た後、SRGANの概念をさらに詳しく理解しました。その後、このネットワークのアーキテクチャを、生成器と識別器のブロックを見ながら詳細に探求しました。最後に、これらの生成的ニューラルネットワークの重要性と、自然界でどのように機能するかを理解するためのプロジェクトを開発しました。
今後の記事では、さらに多くのGANアーキテクチャを探求し、最近大きな人気を博しているさまざまなタイプの生成ネットワークについて学ぶことを試みます。また、ニューラルスタイル転送の概念も探求し、強化学習のようなトピックをさらに詳しく取り上げます。その間は、引き続き学び、ニューラルネットワークやAIが提供するすべてを楽しんでください!